තවත් භාෂාවලින්: English · தமிழ்
08. උත්පාදක AI හි අවදානම්, පක්ෂග්රාහීත්වය සහ වගකීම් සහගත භාවිතය
ප්රකාශිත 2026-09-14
මෙම පරිච්ඡේදය CM-06: උත්පාදක AI හි අවදානම්, සයිබර් ආරක්ෂාව සහ වගකීම් සහගත භාවිතය (පාලනය සහ සදාචාරය) හි රාජ්ය නිලධාරීන් සඳහා වූ සංස්කරණයයි. පොදු පැහැදිලි කිරීම එහි ඇත; මෙහි ඇත්තේ රාජ්ය කාර්යාලයක රැකියාවේදී වෙනස් වන දේ පමණි.
උත්පාදක AI හි ප්රධාන අවදානම් හත මොනවාද?
මෙම පරිච්ඡේදයේ ඇති සෑම කරුණක්ම 03 වන පරිච්ඡේදයේ තහවුරු කළ එක් මූලික තාක්ෂණික සත්යයකින් පැන නගින අතර, අවදානම් නම් කිරීමට පෙර එය නැවත සිහිපත් කිරීම වටී. මහා පරිමාණ භාෂා ආකෘතියක් යනු තොරතුරු ගබඩාවක් හෝ දත්ත සමුදායක් (Database) නොවේ. එය හුදෙක් සංඛ්යානමය සම්භාවිතාව මත පදනම්ව වඩාත්ම ගැළපෙන ඊළඟ වචනය අනුමාන කරන එන්ජිමකි (P(w_t | w_<t)).
මීට අදාළව ප්රධාන අවදානම් මානයන් හතක් පවතින අතර, ඒ සෑම එකක්ම රාජ්ය නිලධාරියෙකුගේ මේසය මතට පැමිණේ. ඒ සෑම එකක්ම එහි තාක්ෂණික ස්වභාවය සහ රාජ්ය අංශයේ බලපෑම සමග පහත දක්වා ඇත්තේ, රාජ්ය සේවයේදී මෙහි විපාක විඳින්නට සිදුවන්නේ යන්ත්රයකට එරෙහිව අභියාචනා කිරීමට කිසිදු හැකියාවක් නැති සාමාන්ය පුරවැසියන්ට වන බැවිනි.
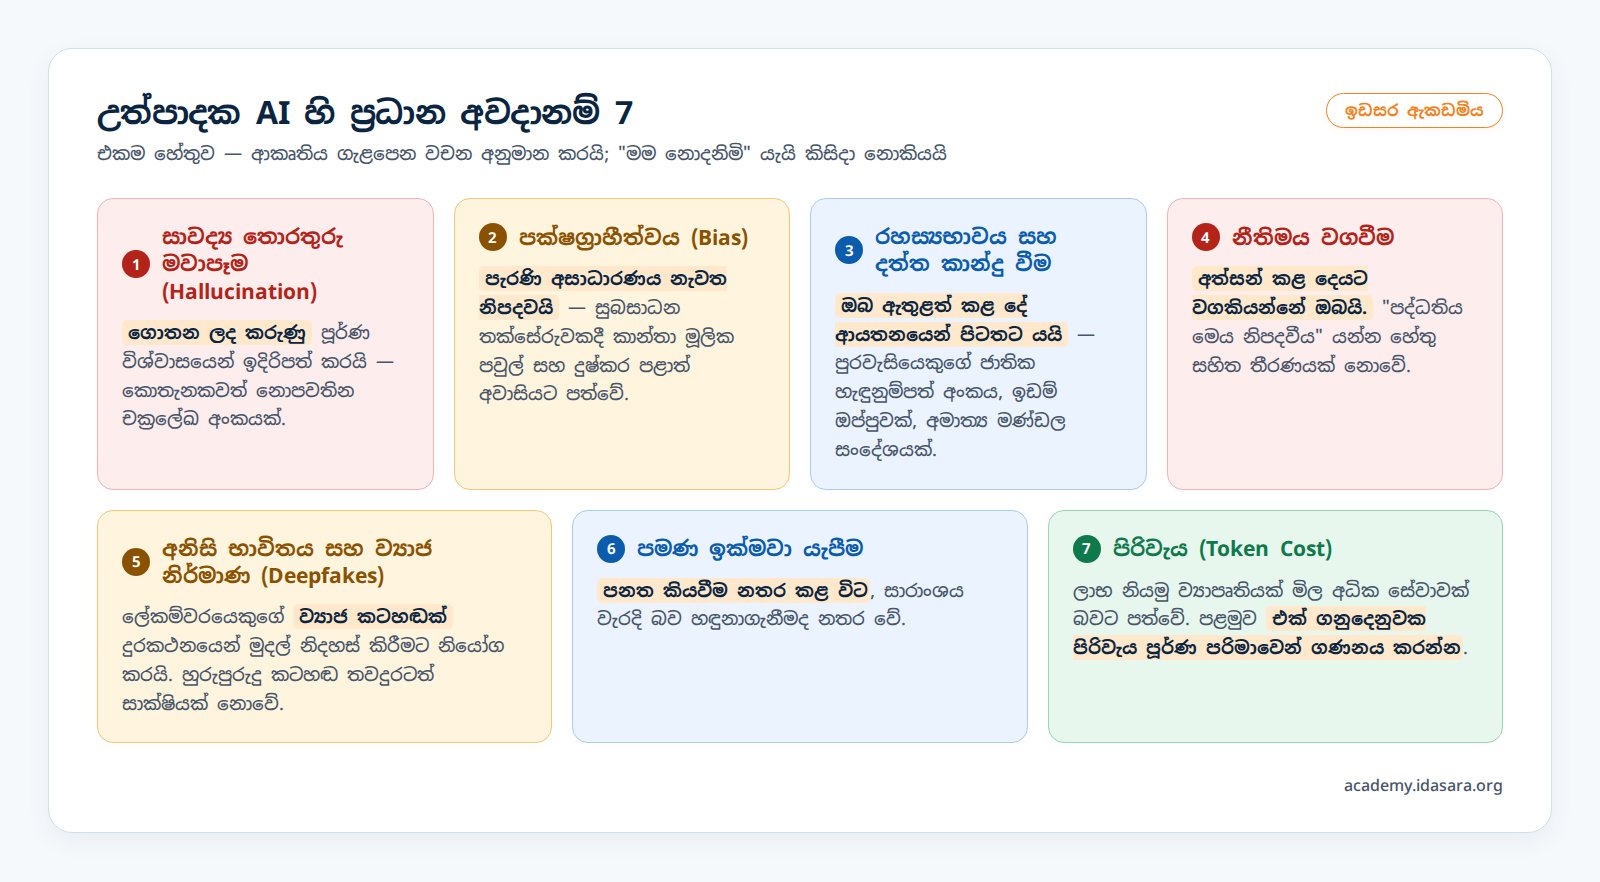 රූපය 8.1: උත්පාදක AI හි අවදානම් (Risks of Generative AI) — සාවද්ය තොරතුරු (Hallucination), පක්ෂග්රාහීත්වය (Bias), රහස්යභාවය (Privacy), නීතිමය වගවීම (Legal), අනිසි භාවිතය (Misuse), පමණ ඉක්මවා යැපීම (Over-reliance) සහ ටෝකන් පිරිවැය (Token Cost).
පළමු අවදානම: සාවද්ය තොරතුරු මවාපෑම (Risk one: hallucination)
ප්රායෝගිකව සිදුවන පාඩුව. සැබෑ ලෝකයේ කොතැනකවත් නොමැති රාජ්ය පරිපාලන චක්රලේඛ අංක. මනඃකල්පිත ශ්රේෂ්ඨාධිකරණ නඩු තීන්දු. නිවැරදි ආකෘතියෙන් සහ නිල ලේඛන ස්වරූපයෙන් ඉදිරිපත් වන ගෙතූ ජනවිකාස සංඛ්යාලේඛන. අමාත්යාංශ ලේකම්වරයෙකු හෝ ප්රාදේශීය ලේකම්වරයෙකු එවැනි ලේඛනයකට අත්සන් තැබූ මොහොතේ, එම මනඃකල්පිත කරුණ නිල රාජ්ය ලේඛනයක බලය අත්පත් කරගනී — තවද එම දෝෂයේ වගවීම යන්ත්රයකට නොව නම සඳහන් මිනිසෙකුට සෘජුවම පැවරේ.
දෙවන අවදානම: පක්ෂග්රාහීත්වය සහ සමාජ අසාධාරණත්වය (Risk two: bias and inequity)
ප්රායෝගිකව සිදුවන පාඩුව. අස්වැසුම හෝ සමෘද්ධි වැනි ශ්රී ලංකාවේ ජාතික සුබසාධන ප්රතිලාභ තක්සේරු කිරීමේදී හෝ රාජ්ය සේවා බඳවාගැනීම් කෙටි ලැයිස්තුගත කිරීමේදී, ආන්තික ප්රජාවන්, කාන්තා ගෘහමූලික පවුල් සහ දුෂ්කර පළාත්වල ජනතාව ස්වයංක්රීයව සහ කිසිවෙකුට නොපෙනී අසාධාරණයට ලක්විය හැක. පද්ධතිය තුළ ඇඟිල්ල දිගු කළ හැකි කිසිදු වෙනස්කම් කිරීමේ උපදෙසක් නොමැති බැවින්, එවැනි වෙනස්කම් කිරීමට එරෙහිව අභියෝග කිරීම මිනිස් පක්ෂග්රාහීත්වයට අභියෝග කිරීමට වඩා අතිශය දුෂ්කර වේ.
යුරෝපා සංගමයේ AI පනත (EU AI Act - Regulation 2024/1689) මගින් රාජ්ය සුබසාධන සහ මහජන සේවා තීරණ "ඉහළ අවදානම් සහිත AI" (High-Risk AI) ලෙස වර්ගීකරණය කර ඇත්තේ මේ හේතුවෙනි — එය දිරිගැන්වීම් වෙනුවට නීතිමය බැඳීම් පනවන කාණ්ඩයකි. ජාත්යන්තර නීතිමය දිශානතිය පැහැදිලිය: පුරවැසියෙකු සඳහා තීරණයක ප්රතිවිපාකය බරපතල වන තරමට, එය ස්වයංක්රීය කරන ඕනෑම අයෙකු මත ඔප්පු කළ හැකි සාධාරණත්වයේ වගකීම ඉහළ යයි.
තෙවන අවදානම: රහස්යභාවය සහ දත්ත කාන්දු වීම (Risk three: confidentiality and privacy leakage)
ප්රායෝගිකව සිදුවන පාඩුව. පුරවැසියන්ගේ ජාතික හැඳුනුම්පත් අංක, ඉඩම් ඔප්පු විස්තර, වෛද්ය වාර්තා, අමාත්ය මණ්ඩල රහස්ය සංදේශ — තම රාජකාරිය ඉක්මනින් අවසන් කිරීමට උත්සාහ කරන යහපත් චේතනාවෙන් යුත් නිලධාරීන් විසින් විවෘත පද්ධතිවලට ඇතුළත් කරනු ලබයි. ශ්රී ලංකාවේ 2022 අංක 9 දරන පුද්ගලික දත්ත ආරක්ෂණ පනත (PDPA) යටතේ දත්ත පාලකයා ලෙස පුරවැසි දත්ත ආරක්ෂා කිරීම රජයේ නිරපේක්ෂ නීතිමය වගකීමක් වන අතර, එම අනාවරණය පහසු වීම හෝ නොදැනුවත්ව සිදුවීම නිසා එම වගකීම ලිහිල් නොවේ.
මෙහි ඇති ප්රායෝගික දුෂ්කරතාවය වන්නේ මෙම අවදානමට කිසිදු ප්රතිචාර ලූපයක් නොමැති වීමයි. රහස්ය දත්ත වැරදි කවුළුවකට ඇතුළත් කළ විට කිසිදු බාහිර අනතුරක් නොපෙනේ. නිලධාරියාගේ වැඩ පහසු වේ, අනතුරු ඇඟවීමක් නොපෙනේ, සහ එය පුරුද්දක් බවට පත්වේ — 07 වන පරිච්ඡේදයේ දැක්වූ පරිදි මෙය තනි පුද්ගල විනිශ්චයට නොතබා ප්රකාශිත ආයතනික නීතියක් බවට පත්කළ යුත්තේ එබැවිනි.
සිව්වන අවදානම: නීතිමය සහ නියාමන වගවීම (Risk four: legal and regulatory liability)
ප්රායෝගිකව සිදුවන පාඩුව. ටෙන්ඩර් ලියකියවිලි, ප්රතිපත්ති පත්රිකා හෝ විෂයමාලා තුළ බුද්ධිමය දේපළ උල්ලංඝනය වීම. තවද පරිපාලකයින් දැඩි ලෙස අවධානය යොමු කළ යුතු වඩාත් සියුම් අවදානමක් ඇත: පරිපාලන නීතියට අනුව, රාජ්ය තීරණයක් නිශ්චිත මානව තාර්කික නිගමනයක් මත පදනම් විය යුතුය. "පද්ධතිය මගින් මෙය නිපදවීය" යන්නෙන් ඔබ්බට පැහැදිලි කළ නොහැකි තීරණයක්, එහි ප්රතිඵලය කෙතරම් ප්රයෝජනවත් වුවද අධිකරණය හමුවේ නීතිවිරෝධී විය හැක. තර්කනය යනු තීරණයක් මත ඇති සැරසිල්ලක් නොවේ. තීරණය වලංගු කරන කොටසක් වන්නේ එයයි.
පස්වන අවදානම: අනිසි භාවිතය සහ ව්යාජ නිර්මාණ (Risk five: misuse and deepfakes)
ප්රායෝගිකව සිදුවන පාඩුව. දිස්ත්රික් ලේකම්වරයෙකුගේ හෝ අමාත්යාංශ ලේකම්වරයෙකුගේ කටහඬ ව්යාජ ලෙස සකසා මුදල් නිදහස් කිරීමට දුරකථනයෙන් උපදෙස් දීම. ව්යාජ නිල ලේඛන මිනිත්තු කිහිපයකින් නිපදවීම. එමෙන්ම තාක්ෂණික පැත්තෙන් ගත් කල, අපරාධකරුවන් විසින් MOSIP වැනි අනන්යතා රාමුවල හෝ ස්වයංක්රීය පරීක්ෂාවන්ට ඔරොත්තු දීමට සැලසුම් කර නැති පැරණි රාජ්ය වෙබ් ද්වාරවල ඇති කේත දුර්වලතා ස්වයංක්රීයව සොයාගෙන ප්රයෝජනයට ගැනීම.
මෙහි වෙනස් වී ඇත්තේ වංචාවේ පැවැත්ම නොව එහි ආර්ථිකයයි. ජ්යෙෂ්ඨ නිලධාරියෙකුගේ අනන්යතාවය සාර්ථකව අනුකරණය කිරීමට අතීතයේදී දක්ෂතාවය, සූදානම සහ නිර්භීතකම අවශ්ය විය. දැන් ඊට අවශ්ය වන්නේ කටහඬ සාම්පලයක් සහ දායකත්වයක් පමණි; එබැවින් ප්රහාරයේ දුෂ්කරතාවය මත පදනම් වූ ආරක්ෂක ක්රම තවදුරටත් වලංගු නොවේ. දුරකථනයේ හුරුපුරුදු කටහඬ අනන්යතාවය තහවුරු කිරීමක් ලෙස සලකන ක්රමවේද දැන් මුළුමනින්ම අභාවයට ගොස් ඇත.
හයවන අවදානම: පමණ ඉක්මවා යැපීම සහ මානව කුසලතා ගිලිහී යාම (Risk six: over-reliance and deskilling)
ප්රායෝගිකව සිදුවන පාඩුව. සාක්කු කැල්කියුලේටරය පැමිණි පසු මනෝමයෙන් ගණනය කිරීමට සිදු වූ දෙය මීට නිදසුනකි. රාජ්ය නිලධාරියා සංකීර්ණ පනත් සහ චක්රලේඛ කියවීම නතර කර මුළුමනින්ම AI සාරාංශ මත යැපීමට පටන් ගනී; එම සාරාංශ සාමාන්යයෙන් නිවැරදි බැවින් එම පුරුද්ද තහවුරු වේ; යම් එකක් වැරදි වූ විට එය හඳුනාගැනීමේ හැකියාව නිහඬව අතුරුදහන් වේ. කාලයත් සමග, කිසිදු තනි පුද්ගලයෙකු එවැනි තීරණයක් නොගෙනම මුළු මහත් රාජ්ය සේවයේම බුද්ධිමය මට්ටම පහත වැටිය හැක.
මෙය මෙම ලැයිස්තුවේ ඇති වඩාත්ම මන්දගාමී සහ වඩාත්ම බරපතල අවදානමයි, මන්ද අනෙක් අවදානම් හයෙන් ආරක්ෂා කරන හැකියාවම එයින් ඉවත් කරන බැවිනි. චක්රලේඛ කියවීම නතර කළ නිලධාරියෙකුට ගොතන ලද චක්රලේඛ අංකයක් හඳුනාගත නොහැක. පළමු අවදානම සහ හයවන අවදානම එකිනෙක බැඳී පවතින අතර, එම සම්බන්ධය දිවෙන්නේ එක් දිශාවකට පමණි.
හත්වන අවදානම: පිරිවැය සහ ටෝකන් ආර්ථික විද්යාව (Risk seven: cost and token economics)
ප්රායෝගිකව සිදුවන පාඩුව. නිසි පද්ධති නිර්මාණ සැලැස්මක් සහ අයවැය පාලනයක් නොමැතිව, රාජ්ය ආයතනයක් තමන්ට දරාගත නොහැකි මාසික මෙහෙයුම් වියදම් නිර්මාණය කර ගනී. රුපියල් දහස් ගණනක් වැය වන නියමු ව්යාපෘතියක් ලක්ෂ ගණනක් වැය වන සේවාවක් බවට පත්වන අතර, සේවාව භාවිතයට පැමිණ දේශපාලනිකව ඉවත් කරගත නොහැකි වන තෙක් වියදම් වක්රය දෘශ්යමාන නොවේ.
අලංකාර නොවන සත්යය නම්: ප්රශ්නය වන්නේ AI මගින් කාර්යය කළ හැකිද යන්න නොව, පූර්ණ පරිමාවේදී එක් ගනුදෙනුවකට එම කාර්යය සඳහා වැයවන පිරිවැය කුමක්ද යන්නයි. එම සංඛ්යාව අයත් විය යුත්තේ පළමු බිල්පතට නොව මුල් සැලසුමටය.
ඩෙලොයිට් (Deloitte) සමාගමේ ඩොලර් 440,000 ක වාර්තාවෙන් සිදු වූ සැබෑ හානිය කුමක්ද?
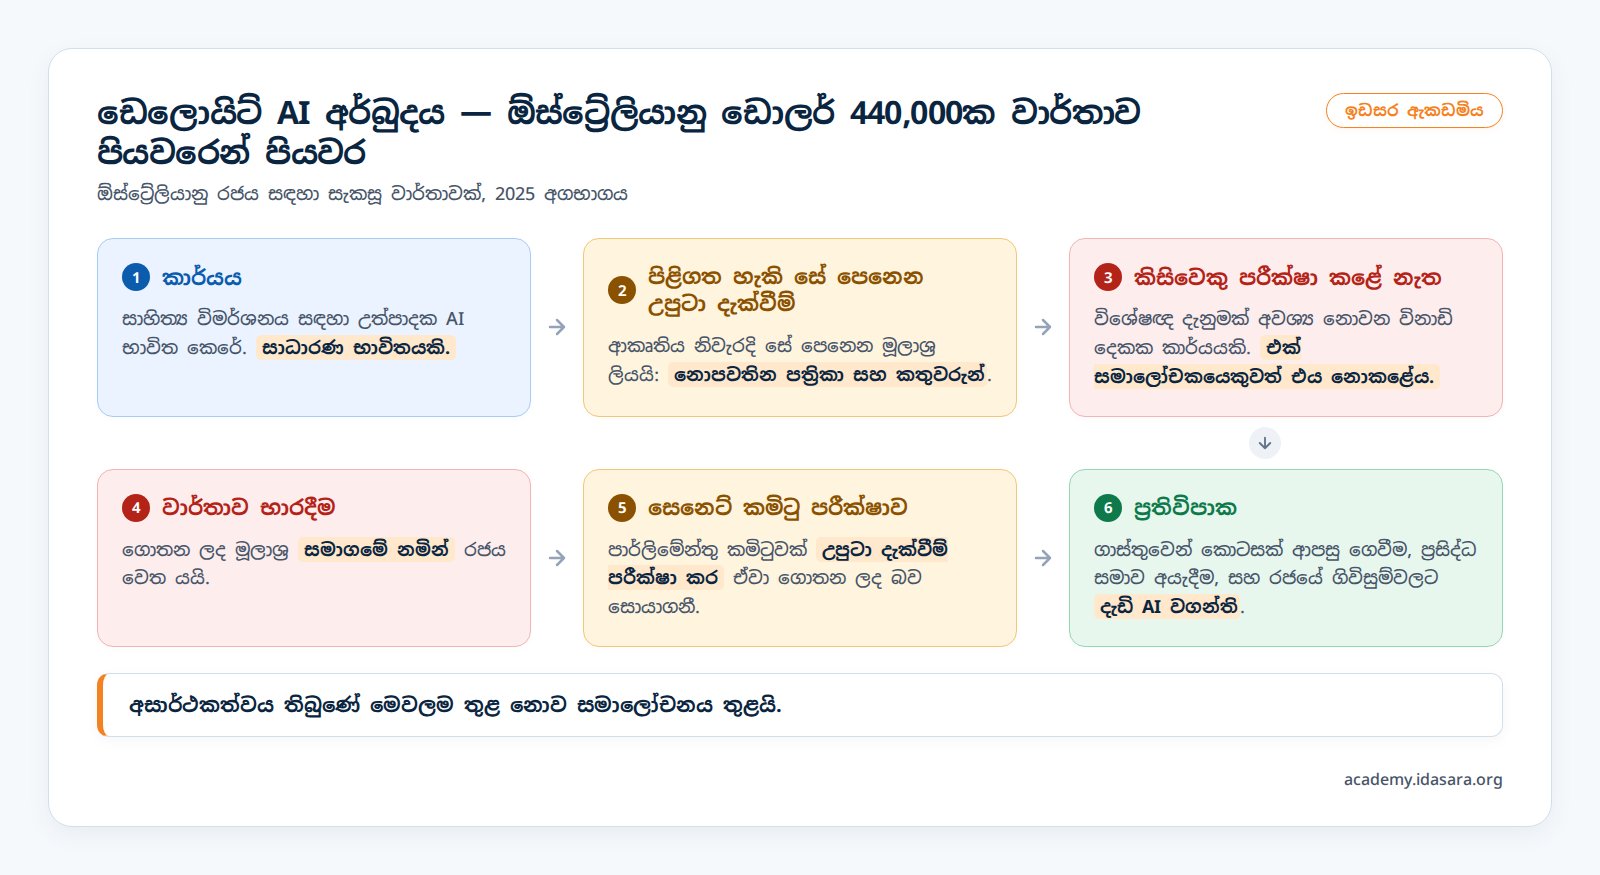 රූපය 8.2: Deloitte's AI Fallout Explained — The $440,000 Report That Backfired (ඕස්ට්රේලියානු ෆෙඩරල් රජයට ඉදිරිපත් කළ නිල වාර්තාවට අත් වූ ඉරණම).
හුදෙක් සටහන් කරගන්නවාට වඩා මෙම සිදුවීම ගැඹුරින් අධ්යයනය කළ යුත්තේ ඇයි (Why this case is worth studying rather than merely noting)
අසාර්ථකත්වය තිබුණේ මෙවලම තුළ නොව සමාලෝචනය තුළයි. 03 වන පරිච්ඡේදයේ විස්තර කළ දේම ආකෘතිය සිදු කළේය: එය පිළිගත හැකි උපුටා දැක්වීම් නිපදවීය, මන්ද ශාස්ත්රීය සාහිත්ය විමර්ශනයක ප්රකාශයක් පිටුපස සංඛ්යානමය වශයෙන් ගලා එන්නේ පිළිගත හැකි උපුටා දැක්වීමකි. උපුටා දැක්වූ පත්රිකාවක් පවතින්නේදැයි පරීක්ෂා කිරීම කිසිදු විශේෂඥ දැනුමක් අවශ්ය නොවන විනාඩි දෙකක කාර්යයකි. එහෙත් කිසිවෙකු එය සිදු කළේ නැත.
මිනිසා පාලනය රඳවා ගන්නා එකම පවුර කියවීම වන්නේ ඇයි?
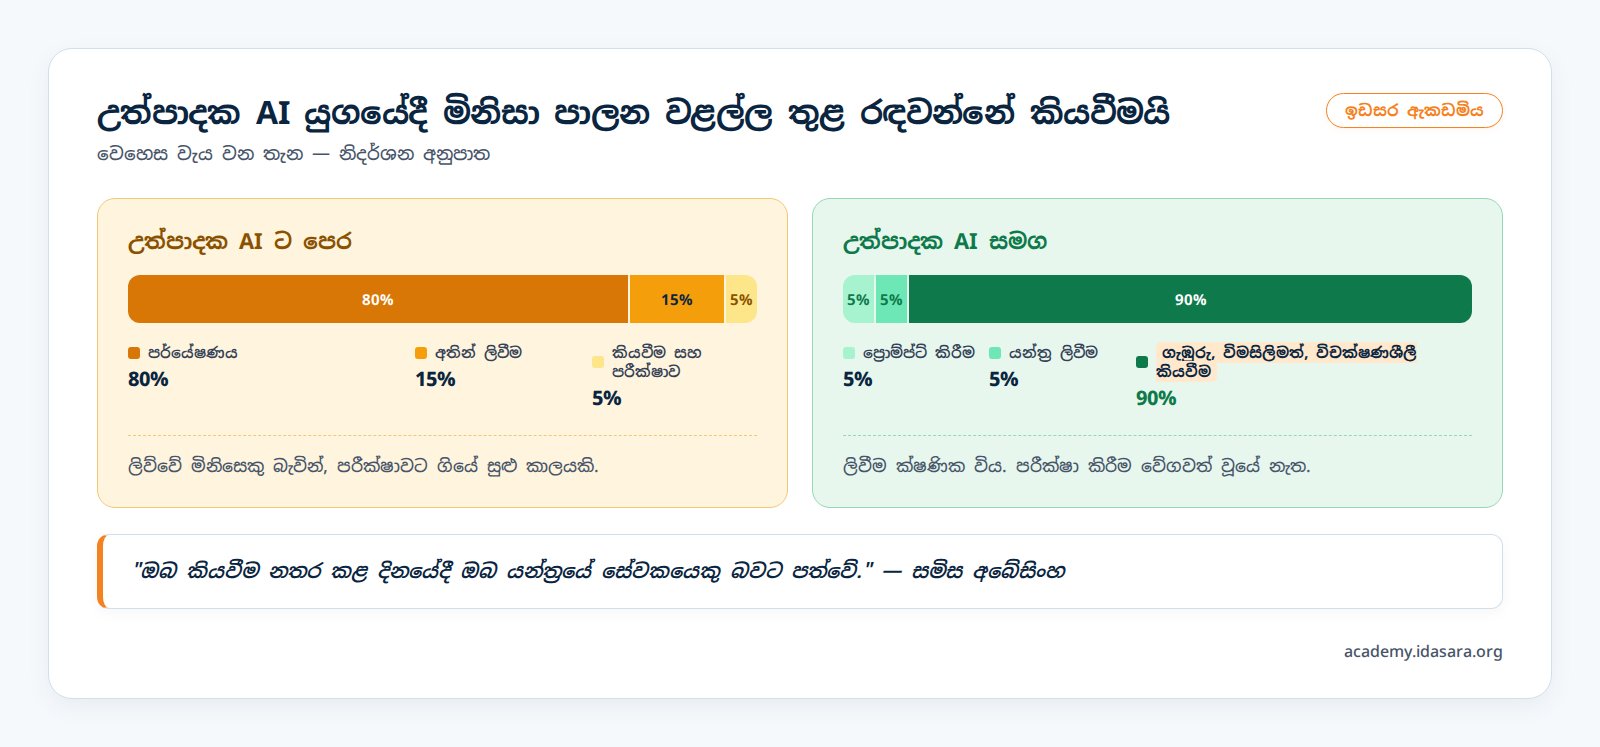 රූපය 8.3: In the Age of Generative AI, Reading Is What Keeps the Human in the Loop — කියවීම යනු හුදු නිෂ්ක්රීය ක්රියාවක් නොව බුද්ධිය පාලනය කරන මානව අතුරුමුහුණතයි (සමිස අබේසිංහ).
ගැඹුරු විචක්ෂණශීලී කියවීමට සැබවින්ම ඇතුළත් වන කරුණු
සංවේදී ගැලපීම (Empathetic alignment). ලේඛනයේ භාෂාව පුරවැසියාගේ සැබෑ වේදනාවට සහ රාජ්ය සේවයේ ගෞරවයට පරිපාලනමය විචක්ෂණභාවයෙන් ගැළපේද? මෙය කිසිදු ආකෘතියකට කළ නොහැකි විනිශ්චයකි, මන්ද ලේඛනය කියවන්නේ කවුරුන්ද යන්න සහ එය ලැබුණු විට කෙබඳු හැඟීමක් ඇතිවේද යන්න දැනගැනීම ඊට අවශ්ය වේ. තාක්ෂණික වශයෙන් දෝෂ රහිත එහෙත් යැවීමට මුළුමනින්ම නුසුදුසු ලේඛනයක් හඳුනාගැනීමට වැඩිම ඉඩක් ඇත්තේ මෙම පරීක්ෂාවෙනි.
AI සාවද්ය තොරතුරු (Hallucinations) ඇතිවන්නේ ඇයි, ඒවා වළක්වන්නේ කෙසේද?
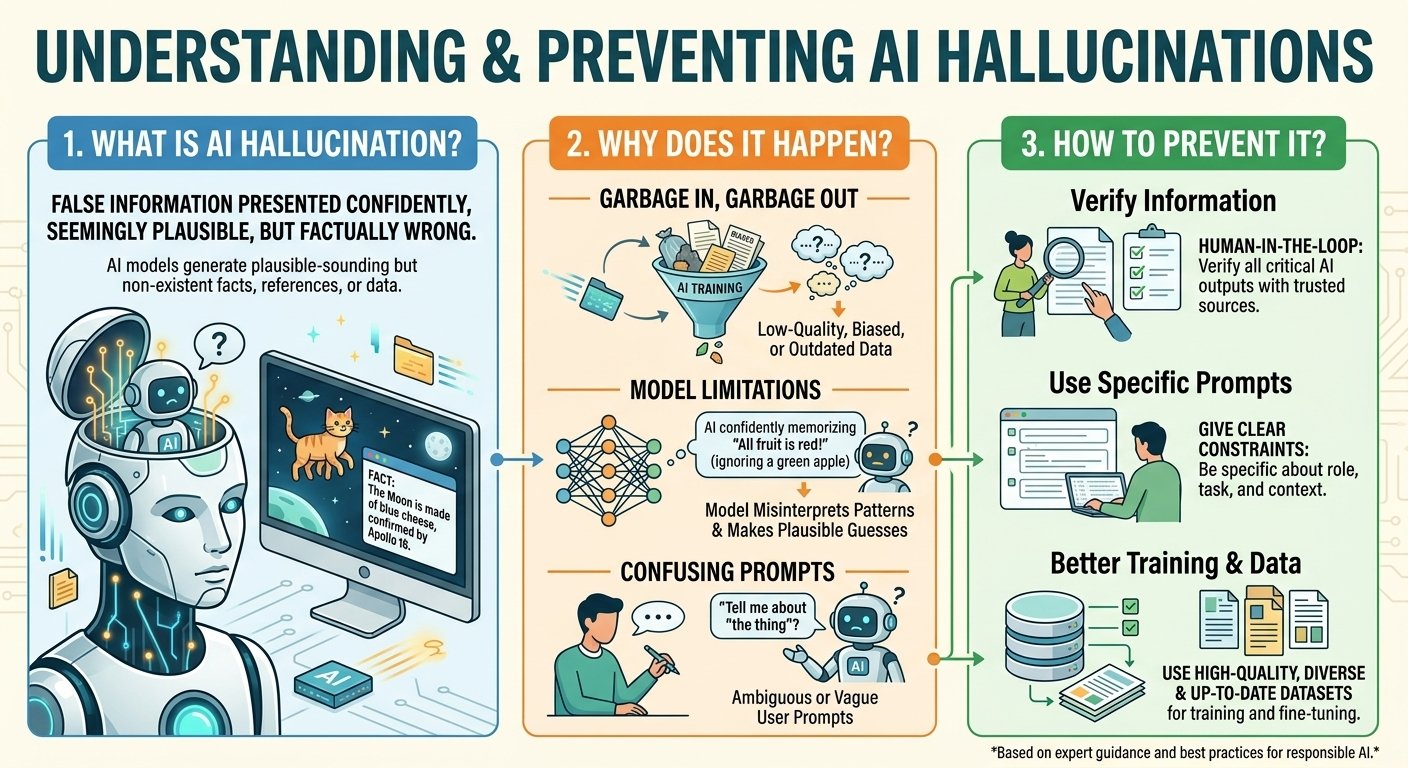 රූපය 8.6: Understanding & Preventing AI Hallucinations — සාවද්ය තොරතුරු නිර්මාණය වීමට බලපාන හේතු 3 (Garbage In, Garbage Out / Model Limitations / Confusing Prompts) සහ ඒවා වැළැක්වීමේ පිළියම් 3.
| දෝෂයේ මූලය | තාක්ෂණික පසුබිම | රාජ්ය සේවයේ සැබෑ අවදානම | ඉංජිනේරුමය පිළියම |
|---|---|---|---|
| Garbage In, Garbage Out | අඩු ගුණාත්මක, පක්ෂග්රාහී හෝ යල්පැන ගිය පුහුණු දත්ත. | 1985 ඉඩම් චක්රලේඛයක් මත පදනම්ව, 2024 ගැසට් පත්රය නොසලකා වන්දි ගණනය කිරීම. | උසස් දත්ත සහ RAG: ආකෘතියේ විවෘත මතකය වෙනුවට යාවත්කාලීන නිල ලේඛන පමණක් භාවිත කිරීම. |
| ආකෘතියේ සීමාවන් (Model Limitations) | රටා වැරදියට අර්ථකථනය කර සම්භාවිතාව මත අනුමාන කිරීම ("සියලු පලතුරු රතු ය!" කියා සිතා කොළ ඇපල් ප්රතික්ෂේප කිරීම). | නීතිමය පූර්වාදර්ශ 10ක් ඉල්ලූ විට සැබෑ විනිසුරුවරුන්ගේ නම් සමග ව්යාජ නඩු අංක ඒකාබද්ධ කර පෙන්වීම. | මානව සත්යාපනය (Human-in-the-Loop): සෑම නිල ලේඛනයක්ම නිකුත් කිරීමට පෙර නිලධාරියෙකු විසින් මූලික ලේඛනය හා සැසඳීම. |
| නොපැහැදිලි ප්රොම්ප්ට් (Confusing Prompts) | සීමාවන්, භූමිකාව සහ සන්දර්භය නොමැතිව සාමාන්ය වචනවලින් විමසීම ("අර සිද්ධිය ගැන කියන්න?"). | සහන ආධාර මුදලක් ගැන විමසූ විට නිශ්චිත චක්රලේඛ නොබලා මනඃකල්පිත මුදලක් ආකෘතිය විසින් නිර්දේශ කිරීම. | පැහැදිලි සීමා පැනවීම (Clear Constraints): භූමිකාව, සන්දර්භය සහ "නොදන්නේ නම් 'නොදනී' යැයි කියන්න" යන සෘණාත්මක සීමා පැනවීම. |
සත්යාපන වැඩ ප්රවාහයක් (Verification Workflow) ප්රායෝගිකව ක්රියාත්මක වන්නේ කෙසේද?
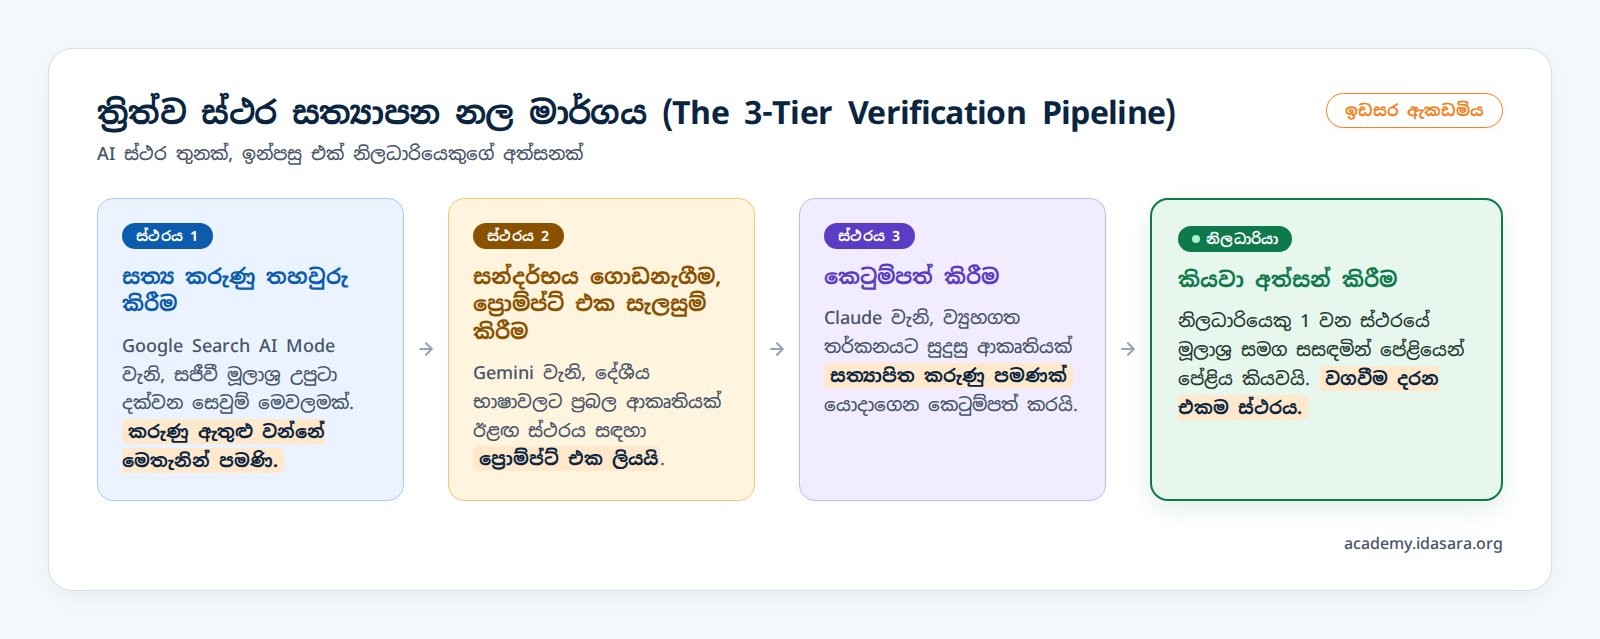 රූපය 8.7: Three-Tier Human-in-the-Loop Verification Pipeline — බහු-මාදිලි මෙහෙයුම්, සීමා පැනවීම සහ පරිපාලනමය වගවීම.
පළමු ස්ථරය — සජීවී මූලාශ්රවලට එරෙහිව සත්ය කරුණු තහවුරු කිරීම. Google Search AI Mode වැනි උපුටා දැක්වීම් සහිත වත්මන් තොරතුරු ලබාගන්නා සෙවුම් මෙවලමකින් ආරම්භ කර සත්යාපිත ස්ථාවරය එක්රැස් කරන්න: නවතම ගැසට් පත්ර, නිල වෙබ් දත්ත, සහ විවෘත කළ හැකි සබැඳි. කරුණු ක්රියාවලියට ඇතුළු වන්නේ මෙම අදියරේදී පමණි. මෙම නල මාර්ගයේ පසු කිසිදු අදියරකට නව කරුණක් හඳුන්වා දීමට අවසර නැත.
දෙවන ස්ථරය — සන්දර්භය ගොඩනැගීම සහ උපදෙස් සැලසුම් කිරීම. එම සත්යාපිත සාරාංශය Gemini වැනි ප්රබල දේශීය භාෂා හැකියාවක් ඇති ආකෘතියකට ගෙන ගොස්, ශ්රී ලංකා සන්දර්භය සහ සිංහල භාෂා නිරවද්යතාවයෙන් එය පුළුල් කරන්න. අනතුරුව අවසාන ලේඛනය වෙනුවට ඊළඟ මෙවලම ලිවීමට එම ආකෘතිය භාවිත කරන්න: "මෙම සත්යාපිත කරුණු මත පදනම්ව, මෙම නීතිමය ලේඛනය කෙටුම්පත් කිරීම සඳහා Claude ආකෘතියට ලබා දිය යුතු සෘණාත්මක සීමාවන් සහිත ප්රශස්ත ප්රොම්ප්ට් එක ලියන්න." එක් ආකෘතියක් ලවා තවත් ආකෘතියක් සඳහා ප්රොම්ප්ට් එක සැලසුම් කරවීම වක්ර එකක් සේ පෙනුණද එය ඉතා ප්රායෝගිකය. ප්රොම්ප්ට් ගොඩනැගීම ආකෘති ඉතා හොඳින් කරන කාර්යයක් වන අතර, එය සීමාවන් උපකල්පනය කරනවා වෙනුවට පැහැදිලිව සඳහන් කිරීමට බලකරයි.
සෙවනැලි AI (Shadow AI) යනු කුමක්ද, AI තහනම් කිරීමෙන් එය වඩාත් නරක අතට හැරෙන්නේ ඇයි?
ආයතනික ප්රතිපත්ති බොහෝ විට සත්යයක් නොවන ලෙස ලියැවෙන බැවින් එක් යථාර්ථයකට අවංකව මුහුණ දිය යුතුය: රාජ්ය නිලධාරීන් දැනටමත් නිල ලිපිගොනු තම පෞද්ගලික දුරකථනවල ඇති නොමිලේ ලැබෙන ChatGPT වෙත යවමින් සිටිති.
එය කරන්නේ නරක චේතනාවකින් නොවේ. ලිපිගොනු බර දරාගත නොහැකි තරම් වන අතර මෙවලමෙන් සැබවින්ම පිහිටක් ලැබේ. විභාග වෙමින් පවතින ලිපිගොනු හැටක් සහ තම දුරකථනයේ නොමිලේ මෙවලමක් සමග රෑ බෝ වන තුරු වැඩ කරන නිලධාරියා නොසැලකිලිමත් වන්නේ නැත; ඔවුන් තමන්ට ඇති එකම මාධ්යයෙන් ඵලදායී වීමට උත්සාහ කරයි.
ඒ වෙනුවට අනුමත ආයතනික මාවතක් සලසන්න. එක් ආරක්ෂිත මෙවලමක් අනුමත කරන්න — ශුන්ය දත්ත රඳවා ගැනීමේ (Zero Data Retention) ප්රතිපත්තියක් සහිත ආයතනික මට්ටමක් — සහ ඇතුළත් කළ හැකි සහ නොහැකි දත්ත මොනවාද යන්න පිළිබඳ පැහැදිලි, නිශ්චිත ලැයිස්තුවක් ප්රකාශයට පත් කරන්න. මෙහිදී දැඩි බවට වඩා නිශ්චිත බව වැදගත් වේ. "සංවේදී දත්ත ගැන සැලකිලිමත් වන්න" යනු කිසිවෙකුට අනුගමනය කළ හැකි නීතියක් නොවේ; "ජාතික හැඳුනුම්පත් අංක, වෛද්ය වාර්තා හෝ ඔප්පු විස්තර කිසිවිටෙකත් ඇතුළත් නොකරන්න" යනු පැහැදිලි නීතියකි.
සැබෑ අවදානම සරලව ප්රකාශ කළහොත්. එය මිනිසුන් AI භාවිත කිරීම නොවේ. එය ආයතනික පාලනයකින්, රෙගුලාසියකින් හෝ මානව සත්යාපනයකින් තොරව රහසින් දත්ත පිටතට යාමයි — තවද එසේ කරන නිලධාරීන්ට උදව් ඉල්ලීමට කිසිදු ක්රමයක් නොමැති වීමයි.
මීළඟ පරිච්ඡේදයේදී, මෙම අවදානම් කළමනාකරණය කරමින් පුරවැසි සේවාවන් ඉහළ නැංවීම සඳහා වන අවුකන පිළිම නිර්මාණයේ ආදර්ශය (බරණැස්ත මූලධර්මය), ජපන් මුහුණු තුන සහ කළුතර ප්රාදේශීය ලේකම් කාර්යාලයේ සංවේදී අත්දැකීම, AI Agents සහ අනාගත පද්ධති පිළිබඳව ගැඹුරින් සාකච්ඡා කරමු.