තවත් භාෂාවලින්: English · தமிழ்
CM-06: උත්පාදක AI හි අවදානම්, සයිබර් ආරක්ෂාව සහ වගකීම් සහගත භාවිතය (Governance & Ethics)
ප්රධාන තේමාව: AI මෙවලමක් යනු ආත්මවිශ්වාසයෙන් පිරි සීමාවාසිකයෙකු (Confident Intern) බඳුය. එය ඉතා දක්ෂ ලෙස වැඩ කරයි; නමුත් කිසිදු පැකිලීමකින් තොරව පට්ටපල් බොරු කීමටද පුළුවන. අවසාන වගවීම ඇත්තේ අත්සන තබන, උත්තරය භාර දෙන, තීරණය ගන්නා මිනිසා සතුවය. කියවීම යනු මානවයා පාලනය රඳවා ගන්නා එකම පවුරයි.
1. උත්පාදක AI හි ප්රධාන අවදානම් 7 පිළිබඳ පද්ධතිමය විග්රහය (Taxonomy of AI Risks)
කෘත්රිම බුද්ධිය භාවිතයේදී ඕනෑම කෙනෙකු තේරුම් ගත යුතු මූලිකම සත්යය නම්, LLM ආකෘතියක් යනු තොරතුරු ගබඩාවක් හෝ දත්ත සමුදායක් (Database) නොව, හුදෙක් වඩාත්ම ගැළපෙන ඊළඟ වචනය සංඛ්යානමය සම්භාවිතාව මත අනුමාන කරන එන්ජිමක් (P(w_t | w_<t)) බවයි. තොරතුරු නොමැති විට හෝ නොදන්නා දෙයක් ඇසූ විට "මම නොදනිමි" කියා නිහඬ වනවා වෙනුවට, ආකෘතිය කරන්නේ අතිශය විශ්වාසනීය සහ නිල ස්වරූපයෙන් අසත්ය තොරතුරු ගොතා ඉදිරිපත් කිරීමයි.
සිසුවාගේ සිට විධායක නිලධාරියා දක්වා අප සැවොම මුහුණ දෙන ප්රධාන අවදානම් මානයන් 7 මෙසේ ක්රමානුකූලව හඳුනාගත හැක (පහත එක් එක් අවදානම සඳහා රාජ්ය සේවය ඇසුරෙන් ගත් සංයුක්ත උදාහරණ දක්වා ඇත — එම රටාවම ඔබේ පාසලට, ව්යාපාරයට හෝ නිවසට සෘජුවම අදාළ වේ):
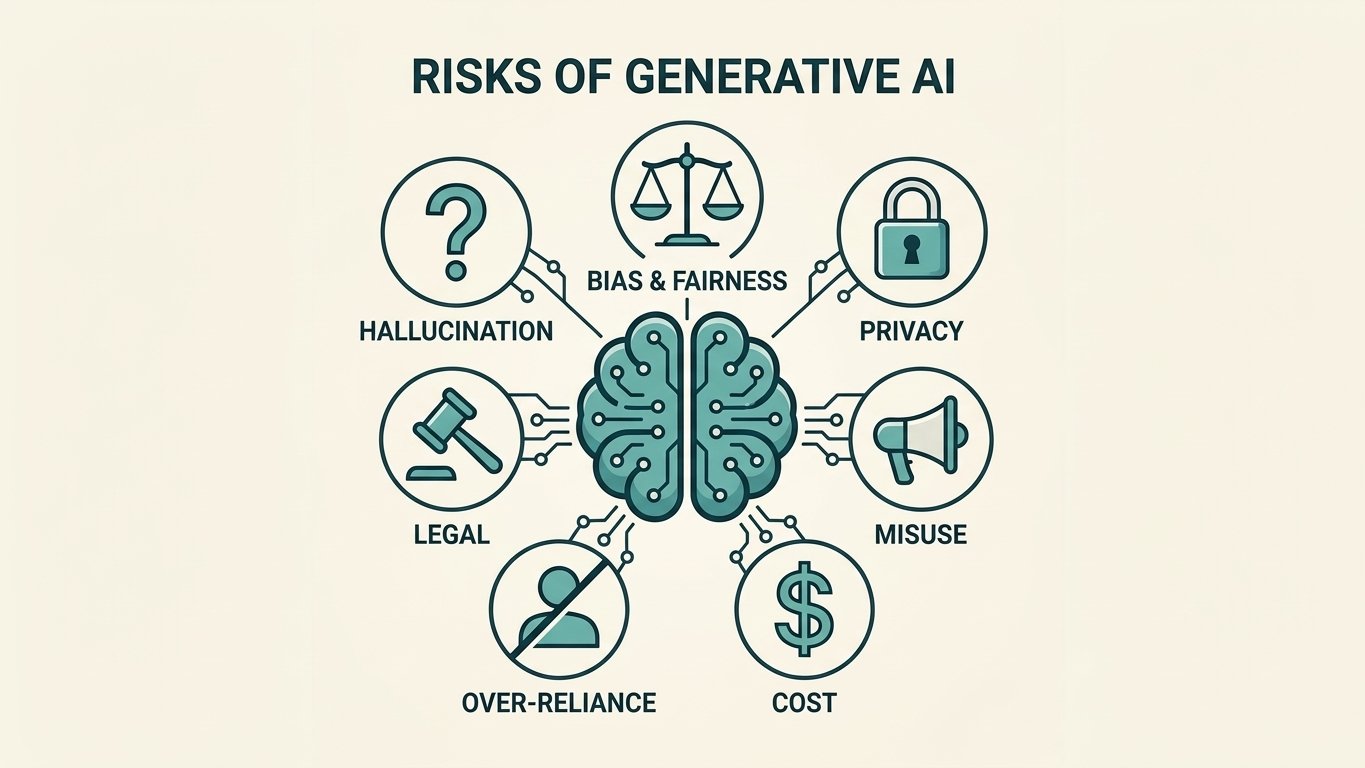 රූපය 8.1: Risks of Generative AI — සාවද්ය තොරතුරු (Hallucination), පක්ෂග්රාහීත්වය (Bias), රහස්යභාවය (Privacy), නීතිමය වගවීම (Legal), අනිසි භාවිතය (Misuse), පමණ ඉක්මවා යැපීම (Over-reliance) සහ ටෝකන් පිරිවැය (Cost).
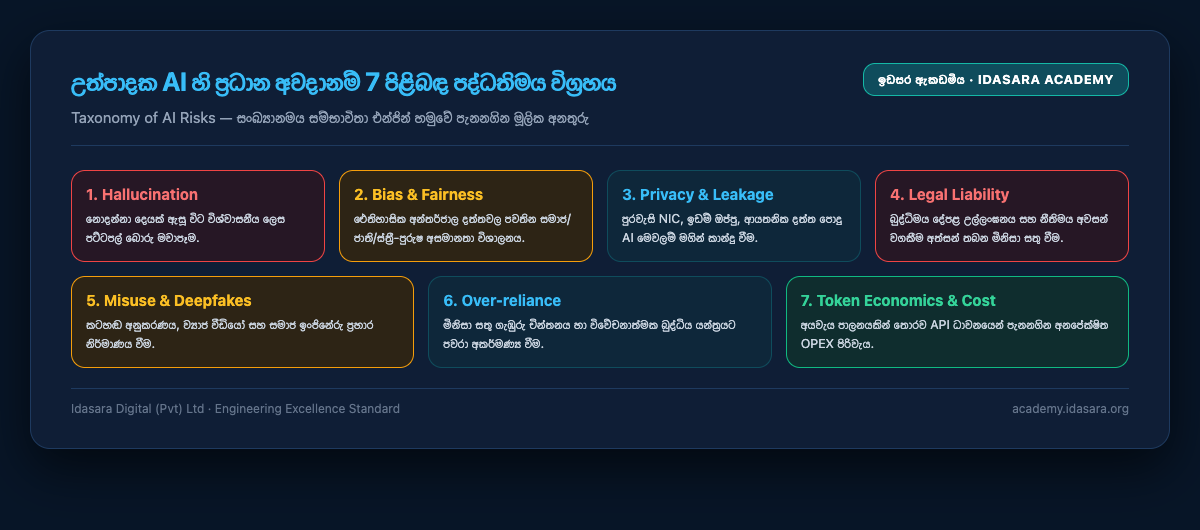 රූපය: උත්පාදක AI හි ප්රධාන අවදානම් 7 පිළිබඳ පද්ධතිමය විග්රහය — ඉඩසර ඇකඩමිය (Idasara Academy)
අවදානම් මානයන් 7 පිළිබඳ ගැඹුරු විග්රහය:
-
සාවද්ය තොරතුරු මවාපෑම (Hallucination): * තාක්ෂණික ස්වභාවය: ආකෘතියට සන්දර්භීය හිඩැසක් හෝ අවිනිශ්චිතතාවක් හමු වූ විට, වාග්විද්යාත්මකව අතිශය අලංකාර එහෙත් භෞතිකව නොපවතින කරුණු නිපදවීම. * රාජ්ය අංශයේ බලපෑම: සැබෑ ලෝකයේ නොපවතින රාජ්ය පරිපාලන චක්රලේඛ අංක, මනඃකල්පිත ශ්රේෂ්ඨාධිකරණ නඩු තීන්දු හෝ ව්යාජ ජනවිකාස සංඛ්යාලේඛන නිල ලේඛනවලට ඇතුළත් වීම. අමාත්යාංශ ලේකම්වරයෙකු හෝ ප්රාදේශීය ලේකම්වරයෙකු මෙවැනි ලේඛනයකට අත්සන් තැබුවහොත් එය නීතිමය සහ පරිපාලනමය ව්යසනයක් බවට පත්වේ.
-
පක්ෂග්රාහීත්වය සහ සමාජ අසාධාරණත්වය (Bias & Inequity): * තාක්ෂණික ස්වභාවය: ආකෘතිය පුහුණු කිරීමට යොදාගත් ඓතිහාසික අන්තර්ජාල දත්තවල පවතින සමාජ, ආර්ථික, සංස්කෘතික සහ භාෂාමය අසමතුලිතතා ආකෘතියේ තීරණ කෙරෙහි සෘජුවම බලපෑම. * රාජ්ය අංශයේ බලපෑම: අස්වැසුම හෝ සමෘද්ධි වැනි සුබසාධන ප්රතිලාභ හිමිකම් තක්සේරු කිරීමේදී හෝ රාජ්ය සේවා බඳවාගැනීම් කෙටි ලැයිස්තුගත කිරීමේදී, ආන්තික ප්රජාවන්, කාන්තා ගෘහමූලික පවුල් හෝ දුෂ්කර පළාත්වල ජනතාව ස්වයංක්රීයවම අසාධාරණයට ලක්වීම. යුරෝපා සංගමයේ AI පනත (EU AI Act - Regulation 2024/1689) මගින් රාජ්ය සුබසාධන සහ මහජන සේවා තීරණ "ඉහළ අවදානම් සහිත AI" (High-Risk AI) ලෙස වර්ගීකරණය කර ඇත්තේ මේ හේතුවෙනි.
-
රාජ්ය රහස්යභාවය සහ දත්ත කාන්දු වීම (Confidentiality & Privacy Leakage): * තාක්ෂණික ස්වභාවය: පොදු වෙබ් AI මෙවලම් (Consumer AI) වෙත ඇතුළත් කරන දත්ත, ආකෘති හිමිකාර සමාගම් විසින් තම ඊළඟ පරම්පරාවේ ආකෘති නැවත පුහුණු කිරීම (Model Retraining) සඳහා ගබඩා කරගැනීම. * රාජ්ය අංශයේ බලපෑම: පුරවැසියන්ගේ ජාතික හැඳුනුම්පත් අංක (NIC), ඉඩම් ඔප්පු තොරතුරු, වෛද්ය වාර්තා හෝ අමාත්ය මණ්ඩල රහස්ය සංදේශ විවෘත AI පද්ධතිවලට ඇතුළත් කිරීම. ශ්රී ලංකාවේ 2022 අංක 9 දරන පුද්ගලික දත්ත ආරක්ෂණ පනත (Personal Data Protection Act - PDPA) යටතේ පුරවැසි දත්ත ආරක්ෂා කිරීම රාජ්ය දත්ත පාලකයාගේ (Data Controller) පරම නීතිමය වගකීමකි.
-
නීතිමය, ප්රකාශන හිමිකම් සහ නියාමන වගවීම (Legal & Regulatory Liability): * තාක්ෂණික ස්වභාවය: වාණිජ හෝ බුද්ධිමය දේපළ අයිතිය සහිත ලේඛන අවසරයකින් තොරව උපුටා ගැනීම සහ AI මගින් නිපදවන ප්රතිදානයන් සඳහා ප්රකාශන හිමිකමක් හිමි නොවීම. * රාජ්ය අංශයේ බලපෑම: ටෙන්ඩර් ලියකියවිලි, ප්රතිපත්ති කෙටුම්පත් හෝ විෂයමාලා සැකසීමේදී බුද්ධිමය දේපළ උල්ලංඝනය වීම. පරිපාලන නීතියට අනුව, රාජ්ය තීන්දුවක් පිටුපස නිශ්චිත මානව තාර්කික විනිශ්චයක් (Human Reasoned Determination) තිබිය යුතු අතර, කළු පෙට්ටියක් (Black-box) බඳු AI තීරණ අධිකරණය හමුවේ නීතිවිරෝධී විය හැක.
-
අනිසි භාවිතය සහ සයිබර් තර්ජන (Misuse & Deepfakes): * තාක්ෂණික ස්වභාවය: බහුමාධ්ය AI මෙවලම් යොදාගෙන කටහඬ අනුකරණය (Voice Cloning), ව්යාජ වීඩියෝ (Deepfakes), සහ ස්වයංක්රීය සමාජ ඉංජිනේරු ප්රහාර (Social Engineering Attacks) ක්ෂණිකව නිර්මාණය කිරීමේ හැකියාව. * රාජ්ය අංශයේ බලපෑම: දිස්ත්රික් ලේකම්වරයෙකුගේ හෝ අමාත්යාංශ ලේකම්වරයෙකුගේ කටහඬ ව්යාජ ලෙස සකසා මුදල් නිදහස් කිරීමට දුරකථන ඇමතුම් දීම, නිල ලේඛන ව්යාජ ලෙස ක්ෂණිකව ජනනය කිරීම. එමෙන්ම, MOSIP (Modular Open Source Identity Platform) වැනි රාමු හෝ පැරණි රාජ්ය වෙබ් ද්වාරවල ඇති කේත දුර්වලතා (Software Vulnerabilities) ස්වයංක්රීයව හඳුනාගෙන බිඳ දැමීමට සයිබර් අපරාධකරුවන් AI අවියක් ලෙස යොදා ගැනීම.
-
පමණ ඉක්මවා යැපීම සහ මානව නිපුණතා ගිලිහී යාම (Over-reliance & Deskilling): * තාක්ෂණික ස්වභාවය: ස්වයංක්රීයකරණයේ පහසුව නිසා මිනිසා සතු ගැඹුරු චින්තනය, විශ්ලේෂණය සහ විවේචනාත්මක බුද්ධිය මෙවලමට පවරා නිහඬ වීම. * රාජ්ය අංශයේ බලපෑම: කැල්කියුලේටරය පැමිණි පසු මනෝමයෙන් ගණනය කිරීමේ හැකියාව ගිලිහී ගියාක් මෙන්, රාජ්ය නිලධාරියා සංකීර්ණ පනත් සහ චක්රලේඛ කියවීම අත්හැර AI සාරාංශ මත පමණක් යැපෙන්නට පටන් ගැනීම. මෙයින් රාජ්ය සේවයේ බුද්ධිමය මට්ටම අතිශය පහත වැටේ.
-
ටෝකන් ආර්ථික විද්යාව සහ අනපේක්ෂිත පිරිවැය (Cost & Token Economics): * තාක්ෂණික ස්වභාවය: වාණිජ මට්ටමේ API ඉන්ෆරන්ස් (Inference), සන්දර්භ මතකය (Context Window Caching), සහ නියෝජිත ලූප (Agentic Loops) ධාවනය කිරීමේදී වැයවන අධික ටෝකන් පරිභෝජනය. * රාජ්ය අංශයේ බලපෑම: නිසි පද්ධති නිර්මාණ සැලැස්මකින් සහ අයවැය පාලනයකින් තොරව පද්ධති ක්රියාත්මක කළහොත්, රාජ්ය ආයතනයකට දරාගත නොහැකි මාසික මෙහෙයුම් වියදම් (OPEX) නිර්මාණය වීම.
2. ඩෙලොයිට් (Deloitte) සමාගමේ ඩොලර් 440,000 ක පාඩම
AI සාවද්ය තොරතුරු (Hallucinations) නිසා ජාත්යන්තර මට්ටමේ දැවැන්ත උපදේශන සමාගම් පවා දරුණු ලැජ්ජාවට සහ නීතිමය දඩුවම්වලට ලක්වූ ආකාරය පිළිබඳ ලොව හොඳම උදාහරණය ඕස්ට්රේලියානු රජයේ අත්දැකීමයි:
 රූපය 8.2: Deloitte's AI Fallout Explained — The $440,000 Report That Backfired (ඕස්ට්රේලියානු ෆෙඩරල් රජයේ නිල වාර්තාවට අත් වූ ඉරණම).
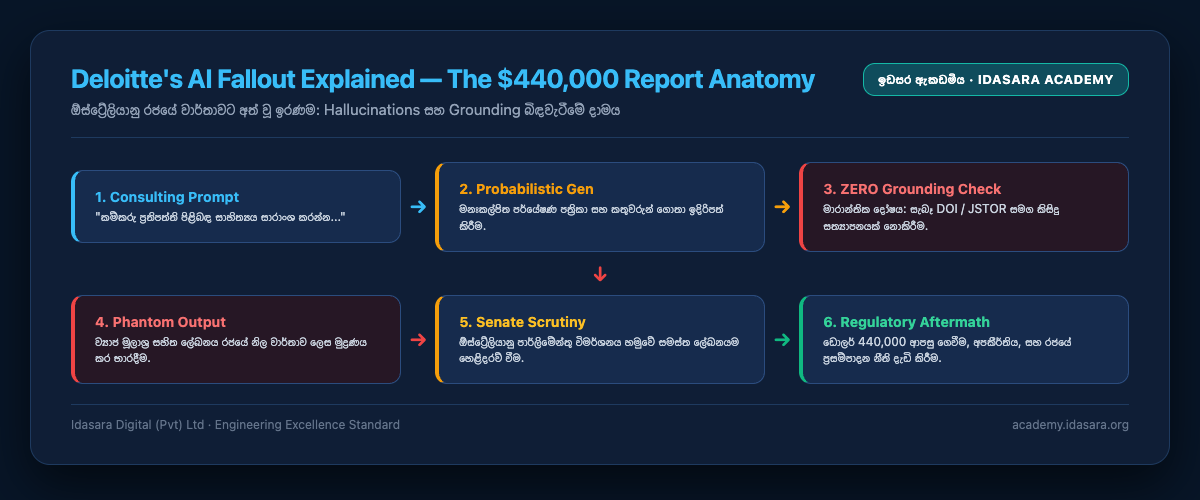 රූපය: Deloitte's AI Fallout Explained — The $440,000 Report Anatomy — ඉඩසර ඇකඩමිය (Idasara Academy)
සිදුවීමේ පසුබිම සහ පද්ධතිමය බිඳවැටීම:
2025 අගභාගයේදී, ලොව ප්රමුඛතම කළමනාකරණ උපදේශන සමාගමක් වන Deloitte විසින් ඕස්ට්රේලියානු රජයේ රැකීරක්ෂා සහ සේවාස්ථාන සබඳතා දෙපාර්තමේන්තුව (Department of Employment and Workplace Relations) වෙනුවෙන් ඕස්ට්රේලියානු ඩොලර් 440,000ක (රුපියල් කෝටි 13කට අධික මුදලක) ගිවිසුමක් යටතේ ප්රතිපත්ති පර්යේෂණ වාර්තාවක් සකස් කරන ලදී (Deloitte's AI Fallout Explained: The $440,000 Report That Backfired).
වාර්තාව සම්පාදනය කළ උපදේශක කණ්ඩායම සාහිත්ය විමර්ශනය (Literature Review) සහ ආර්ථික දත්ත සාරාංශ කිරීම සඳහා උත්පාදක AI භාවිත කර තිබුණි. එහෙත් වාර්තාව ඕස්ට්රේලියානු පාර්ලිමේන්තුවේ සෙනෙට් කමිටුව හමුවට ඉදිරිපත් කළ පසු හෙළි වූයේ: * වාර්තාවේ උපුටා දක්වා තිබූ අධ්යයන පත්රිකා, කතුවරුන්ගේ නම්, සහ ආයතනික සමීක්ෂණ වාර්තා බොහොමයක් සැබෑ ලෝකයේ කිසිදා පළ නොවූ, AI විසින් සම්පූර්ණයෙන්ම මවාපෑ (Hallucinated) මනඃකල්පිත මූලාශ්ර බවයි! * සමාගමේ ඉහළ පෙළේ උපදේශකයින් කිසිවෙකුත් මෙම මූලාශ්ර සැබෑ ලෝකයේ පවතින්නේදැයි පරීක්ෂා කර තිබුණේ නැත. * අවසානයේ Deloitte සමාගමට තම උපදේශන ගාස්තුවෙන් කොටසක් ආපසු රජයට ගෙවීමටත්, පාර්ලිමේන්තුව හමුවේ ප්රසිද්ධියේ සමාව අයැදීමටත් සිදුවිය. ඕස්ට්රේලියානු රජය මින් ඉදිරියට සියලුම රාජ්ය උපදේශන ගිවිසුම් සඳහා දැඩි AI භාවිත සහ මානව වගවීමේ වගන්ති ඇතුළත් කිරීමට නීති පැනවීය.
Important
ශ්රී ලාංකිකයන් වන අප සැමට ලැබෙන පාඩම:
AI විසින් කෙතරම් විද්යාත්මක සහ බලධාරී ඉංග්රීසියෙන් වාර්තාවක් ලියා දුන්නද, ඔබ ඊට අත්සන තැබූ මොහොතේ සිට එහි ඇති සෑම වචනයකම සම්පූර්ණ වගකීම ඔබ සතුය. "AI වැරැද්දක් කළා" යැයි කීම විභාග මණ්ඩලය, සේවායෝජකයා, රාජ්ය සේවා කොමිෂන් සභාව හෝ අධිකරණය හමුවේ වලංගු නිදහසට කරුණක් නොවේ!
3. කියවීම යනු මානවයා පාලනය රඳවා ගන්නා එකම අතුරුමුහුණතයි
මා විසින් රචිත ලිපියක මා අවධාරණය කළේ මෙම මූලික සංජානන මූලධර්මයයි:
 රූපය 8.3: In the Age of Generative AI, Reading Is What Keeps the Human in the Loop — කියවීම යනු හුදු නිෂ්ක්රීය ක්රියාවක් නොව, බුද්ධිය පාලනය කරන මානව අතුරුමුහුණතයි (සමිස අබේසිංහ).
"යන්ත්රවලට තත්පර කිහිපයකින් පිටු සිය ගණනක් ලිවිය හැක. ලිවීමේ වේගය මත්වන සුළුය. එහෙත් එම ස්වයංක්රීය මැවීම් හමුවේ අපගේ බුද්ධිමය යටත්වීම වළක්වන එකම පවුර වන්නේ ගැඹුරු, විමසිලිමත් සහ විවේචනාත්මක කියවීමයි (Deep, Deliberate, and Discerning Reading). ඔබ කියවීම නතර කළ දිනයේදී ඔබ යන්ත්රයේ වහලෙකු බවට පත්වේ."
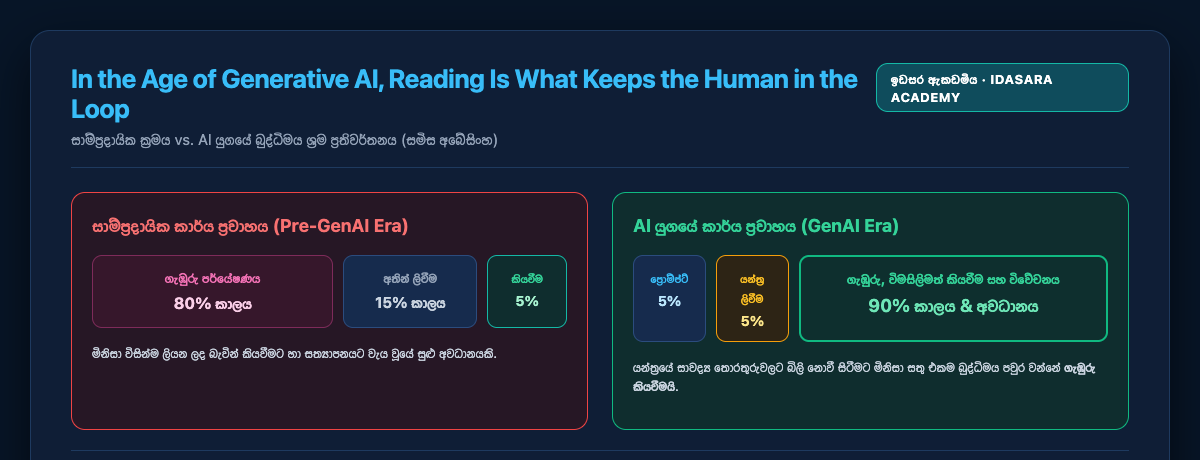 රූපය: In the Age of Generative AI, Reading Is What Keeps the Human in the Loop — ඉඩසර ඇකඩමිය (Idasara Academy)
ක්රමවේද දෙකක වෙනස:
- නිකරුණේ අනුචලනය කිරීම (Skimming / Scrolling — අසාර්ථක මාදිලිය): AI විසින් දුන් පිටු 10ක වාර්තාවේ භාෂාව අලංකාර යැයි සිතා, උඩින් පල්ලෙන් බලා අත්සන් තැබීම. Deloitte සමාගම ව්යසනයට පත්වූයේ මෙලෙසිනි.
- ගැඹුරු විවේචනාත්මක කියවීම (Discerning Reading — සැබෑ ආරක්ෂක පවුර): 1. තාර්කික සබැඳියාව පිරික්සීම (Logical Trace): මුල් කරුණු A සහ B මගින් අවසාන නිගමනය C සැබවින්ම සනාථ වන්නේද, නැතහොත් AI විසින් අසත්ය පාලමක් නිර්මාණය කර ඇත්දැයි බැලීම. 2. සීමාකාරී කොන්දේසි පරීක්ෂාව (Constraint Compliance): ඔබ ප්රොම්ප්ට් එකේ දැමූ සෘණාත්මක සීමා (Negative Constraints) සහ නීතිමය කොන්දේසි ආකෘතිය විසින් 100%ක් පිළිපැද තිබේදැයි පිරික්සීම. 3. මානුෂීය සහ සංවේදී ගැලපීම (Empathetic Alignment): වාර්තාවේ ඇති භාෂාව සැබෑ පුරවැසියාගේ වේදනාවට සහ රාජ්ය සේවයේ ගෞරවයට ගැළපේදැයි පරිපාලනමය විචාර බුද්ධියෙන් තක්සේරු කිරීම.
4. AI පක්ෂග්රාහීත්වය (Bias) තේරුම් ගැනීම සහ වැළැක්වීමේ ක්රමවේදය
කෘත්රිම බුද්ධියේ ඇති තවත් දරුණු අනතුරක් වන්නේ සමාජයේ පවතින පක්ෂග්රාහීත්වයන් අතිශය විශ්වාසනීය සහ පක්ෂපාතී නොවන ස්වරූපයකින් නැවත උත්පාදනය කිරීමයි.
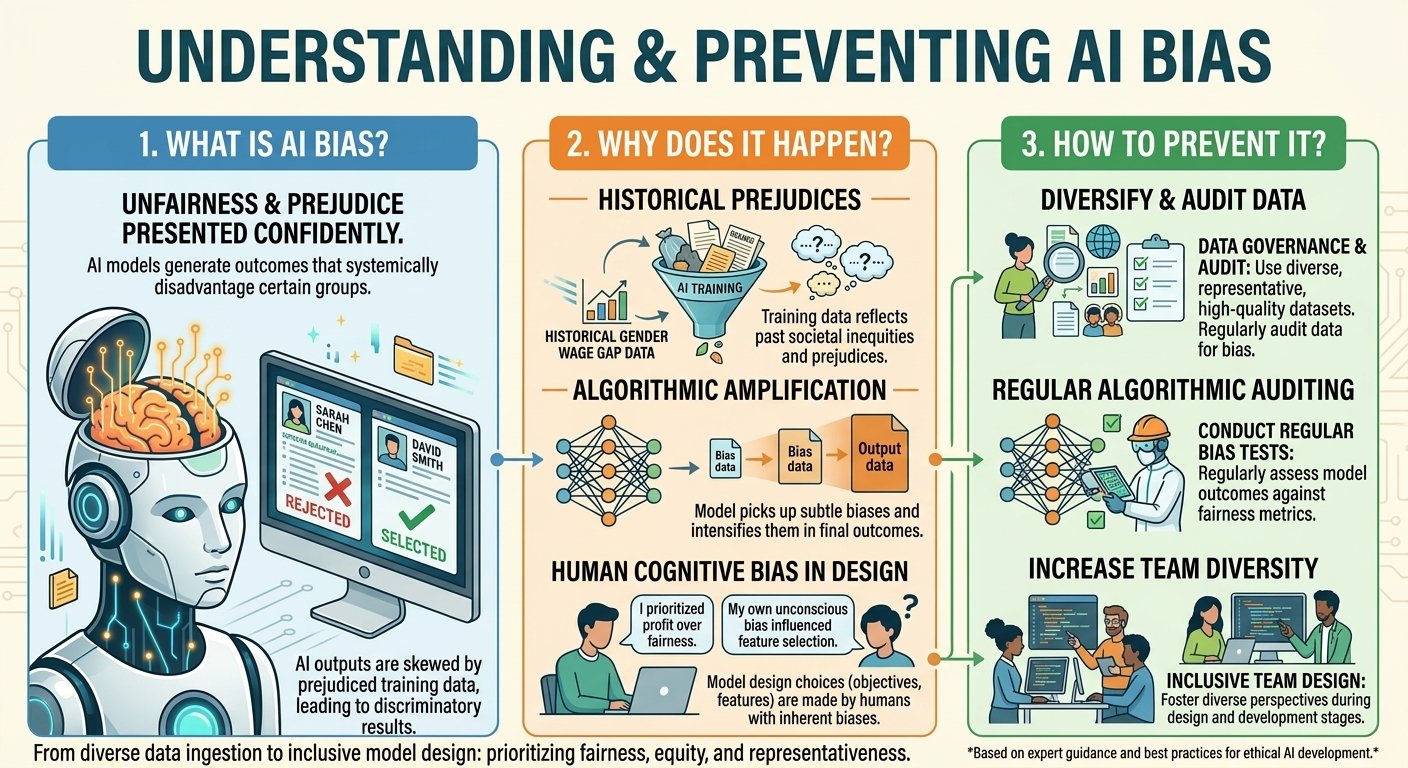 රූපය 8.4: Understanding & Preventing AI Bias — පක්ෂග්රාහීත්වය හටගන්නා හේතු 3 (ඓතිහාසික අසාධාරණකම්, ඇල්ගොරිතමික විශාලනය, මානව සැලසුම් පක්ෂග්රාහීත්වය) සහ වැළැක්වීමේ පියවර 3.
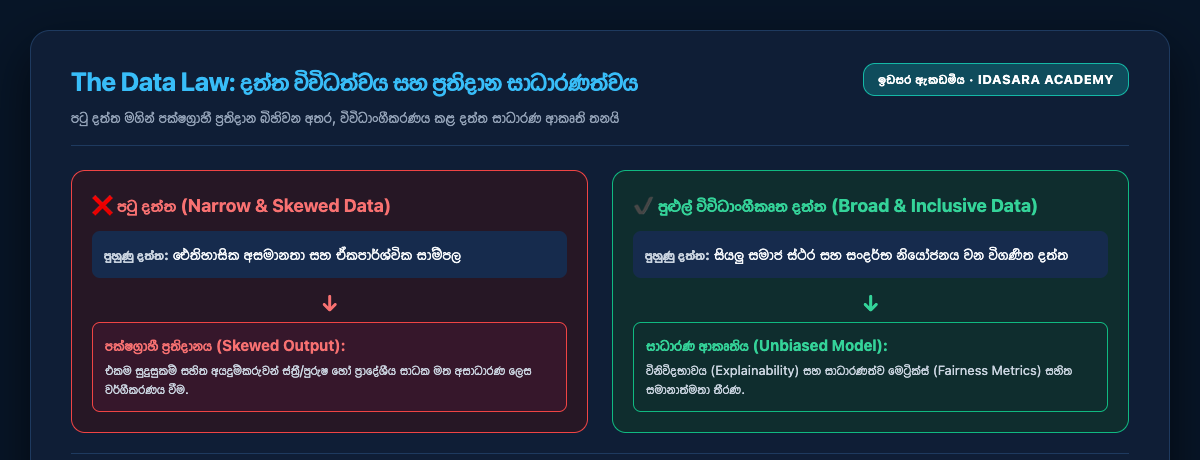 රූපය: The Data Law: දත්ත විවිධත්වය සහ ප්රතිදාන සාධාරණත්වය — ඉඩසර ඇකඩමිය (Idasara Academy)
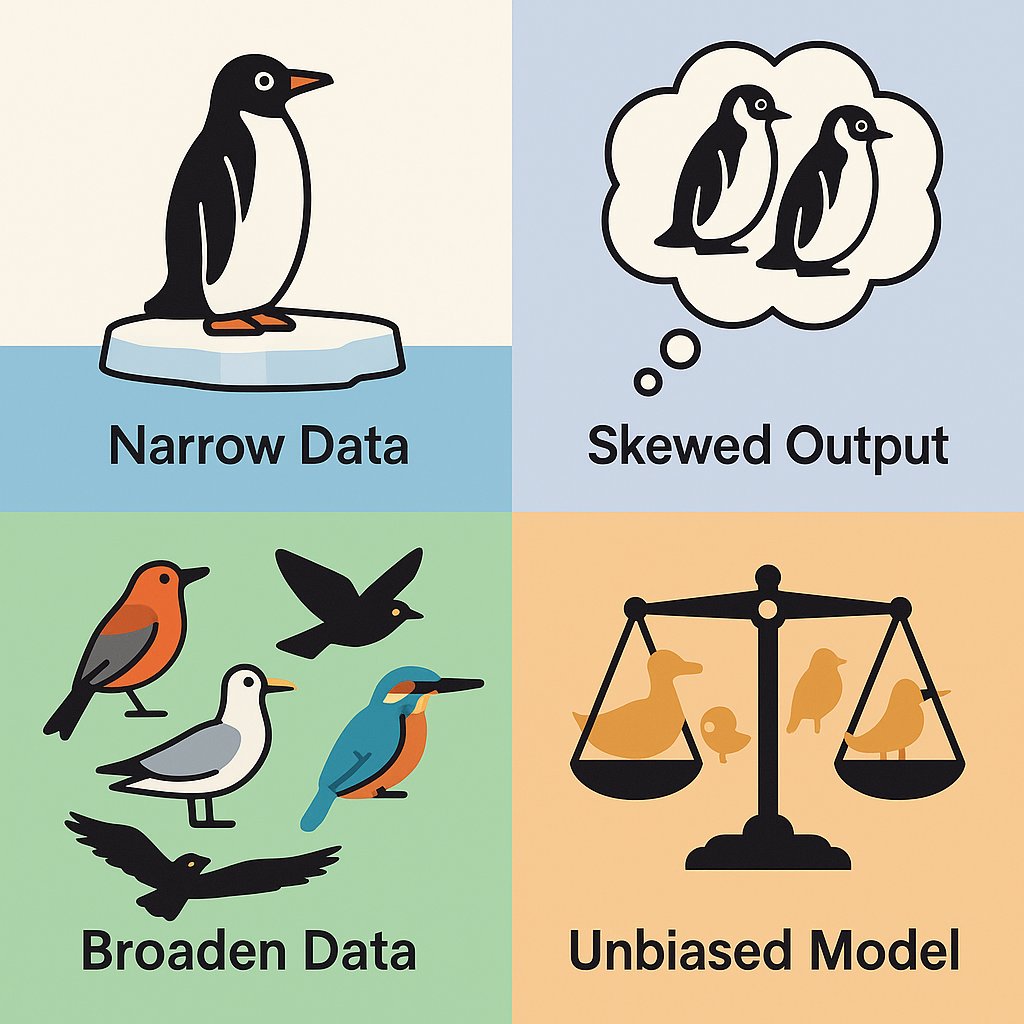 රූපය 8.5: The Data Law — පටු දත්ත මගින් පක්ෂග්රාහී ප්රතිදාන ලැබෙන අතර, විවිධාංගීකරණය කළ දත්ත මගින් සාධාරණ ආකෘතියක් බිහිවේ.
1. කුමක්ද මේ AI පක්ෂග්රාහීත්වය? (What is AI Bias?)
ආකෘතියක් විසින් යම් සමාජ කණ්ඩායමකට, ජාතියකට, ස්ත්රී-පුරුෂ භාවයකට හෝ ප්රදේශයකට අගතියක් වන අන්දමින් ක්රමානුකූලව අසමාන තීරණ ජනනය කිරීමයි. * රූපයේ දැක්වෙන උදාහරණය: එකම සුදුසුකම් සහිත "Sarah Chen" නම් කාන්තා අයදුම්කාරිය ප්රතික්ෂේප වී (Rejected), "David Smith" නම් පිරිමි අයදුම්කරු තෝරාගැනීම (Selected).
2. පක්ෂග්රාහීත්වය හටගන්නේ ඇයි? (Why Does It Happen?)
- පුහුණු දත්තවල ඇති ඓතිහාසික අසාධාරණකම් (Historical Prejudices): අතීතයේ පැවති ස්ත්රී පුරුෂ වැටුප් විෂමතා හෝ සමාජ අසමානතා සහිත දත්ත මත ආකෘතිය පුහුණු වූ විට, ආකෘතිය එම අතීත වැරදි නීත්යානුකූල ස්ථිර රීතීන් ලෙස වටහා ගනී.
- ඇල්ගොරිතමික විශාලනය (Algorithmic Amplification): දත්තවල ඇති සුළු පක්ෂපාතීත්වයක් වුවද, සංඛ්යානමය වශයෙන් ප්රශස්ත කිරීමේදී (Optimization) ආකෘතිය මගින් එය තව තවත් විශාල කර අන්තගාමී තීරණ බවට පත්කරයි.
- පද්ධති නිර්මාණකරුවන්ගේ මානසික පක්ෂග්රාහීත්වය (Human Cognitive Bias in Design): මෘදුකාංගය සැලසුම් කරන ඉංජිනේරුවන් තමන්ගේම යටිසිතේ ඇති පක්ෂග්රාහී අදහස් අනුව විශේෂාංග (Features) තෝරාගැනීම සහ ලාභය සාධාරණත්වයට වඩා ඉහළින් තැබීම.
3. පක්ෂග්රාහීත්වය වළක්වා ගන්නේ කෙසේද? (How to Prevent It?)
- දත්ත පාලනය සහ විගණනය (Diversify & Audit Data): ආයතනය භාවිත කරන දත්ත කට්ටල විවිධ සමාජ කොටස් නියෝජනය කරන බවට පූර්ව විගණනයක් සිදුකිරීම.
- ක්රමවත් ඇල්ගොරිතමික විගණනය (Regular Algorithmic Auditing): ආකෘතිය ලබා දෙන තීරණ සාධාරණත්ව මෙට්රික්ස් (Fairness Metrics) සමග නිරන්තරයෙන් පරීක්ෂා කිරීම.
- කණ්ඩායම් විවිධත්වය ඉහළ නැංවීම (Inclusive Team Design): තාක්ෂණික කණ්ඩායම තුළ විවිධ සමාජ පසුබිම්, ක්ෂේත්ර සහ සංවේදීතා සහිත වෘත්තිකයන් ඇතුළත් කරගැනීම.
5. AI සාවද්ය තොරතුරු (Hallucinations) ගැඹුරින් වැළැක්වීමේ පද්ධති නිර්මාණ සැලැස්ම
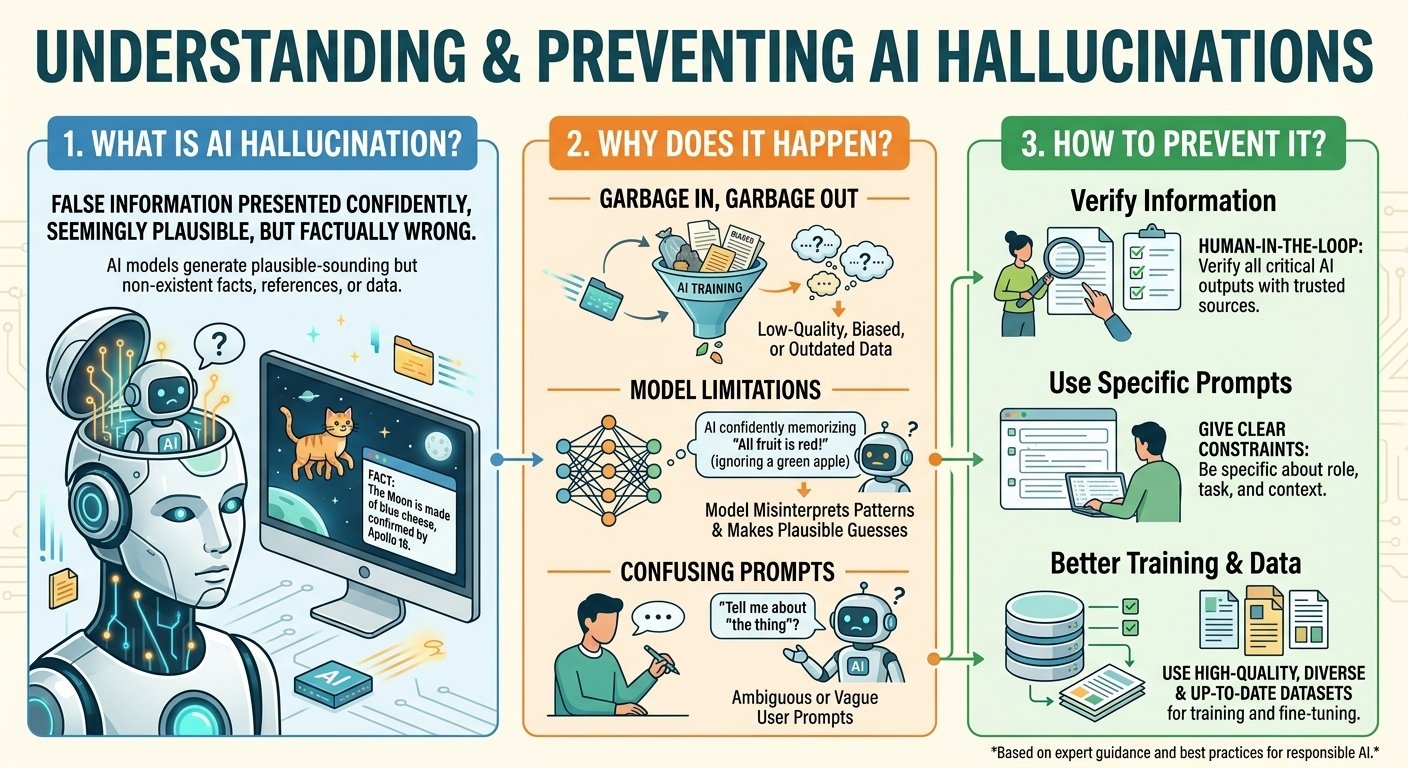 රූපය 8.6: Understanding & Preventing AI Hallucinations — සාවද්ය තොරතුරු නිර්මාණය වීමට බලපාන හේතු 3 (Garbage In, Garbage Out / Model Limitations / Confusing Prompts) සහ ඒවා වැළැක්වීමේ පිළියම් 3.
සාවද්ය තොරතුරු හටගැනීමේ ත්රිත්ව දෝෂය සහ විසඳුම් න්යාසය:
| දෝෂයේ මූලය | තාක්ෂණික පසුබිම | රාජ්ය සේවයේ සැබෑ අවදානම | ඉංජිනේරුමය පිළියම |
|---|---|---|---|
| Garbage In, Garbage Out | අඩු ගුණාත්මක, පක්ෂග්රාහී හෝ යල්පැන ගිය පුහුණු දත්ත. | 1985 ඉඩම් චක්රලේඛයක් මත පදනම්ව, 2024 ගැසට් පත්රය නොසලකා වන්දි ගණනය කිරීම. | උසස් තත්ත්වයේ දත්ත (Better Training & RAG): ආකෘතියේ විවෘත මතකය වෙනුවට යාවත්කාලීන නිල ලේඛන පමණක් භාවිත කිරීම. |
| ආකෘතියේ සීමාවන් (Model Limitations) | රටා වැරදියට අර්ථකථනය කර සම්භාවිතාව මත අනුමාන කිරීම ("All fruit is red!" කියා සිතා කොළ ඇපල් ප්රතික්ෂේප කිරීම). | නීතිමය පූර්වාදර්ශ 10ක් ඉල්ලූ විට සැබෑ විනිසුරුවරුන්ගේ නම් සමග ව්යාජ නඩු අංක ඒකාබද්ධ කර පෙන්වීම. | මානව සත්යාපනය (Human-in-the-Loop): සෑම නිල ලේඛනයක්ම නිකුත් කිරීමට පෙර නිලධාරියෙකු විසින් මූලික ලේඛනය හා සැසඳීම. |
| අපැහැදිලි ප්රොම්ප්ට් (Confusing Prompts) | සීමාවන්, භූමිකාව සහ සන්දර්භය නොමැතිව සාමාන්ය වචනවලින් විමසීම ("Tell me about the thing?"). | සහන ආධාර මුදලක් ගැන විමසූ විට නිශ්චිත චක්රලේඛ නොබලා මනඃකල්පිත මුදලක් ආකෘතිය විසින් නිර්දේශ කිරීම. | පැහැදිලි සීමා පැනවීම (Clear Constraints): භූමිකාව, සන්දර්භය සහ "නොදන්නේ නම් 'නොදනී' යැයි කියන්න" යන සෘණාත්මක සීමා පැනවීම. |
6. ත්රිත්ව ස්ථර තහවුරු කිරීමේ ක්රමවේදය (The 3-Tier Verification Workflow)
සැසිවාරවලදී බොහෝ දෙනෙකු මාගෙන් අසන්නේ: "සමිස, ඔබ පෞද්ගලිකව මේ Hallucinations වළක්වාගෙන නිෂ්පාදන මට්ටමේ පද්ධති තුළ විශ්වාසවන්තව AI භාවිත කරන්නේ කොහොමද?" කියාය.
මගේ ඉංජිනේරු ජීවිතයේදී මා යොදාගන්නා ත්රිත්ව ස්ථර සත්යාපන නල මාර්ගය (3-Tier Verification Pipeline) මෙසේය:
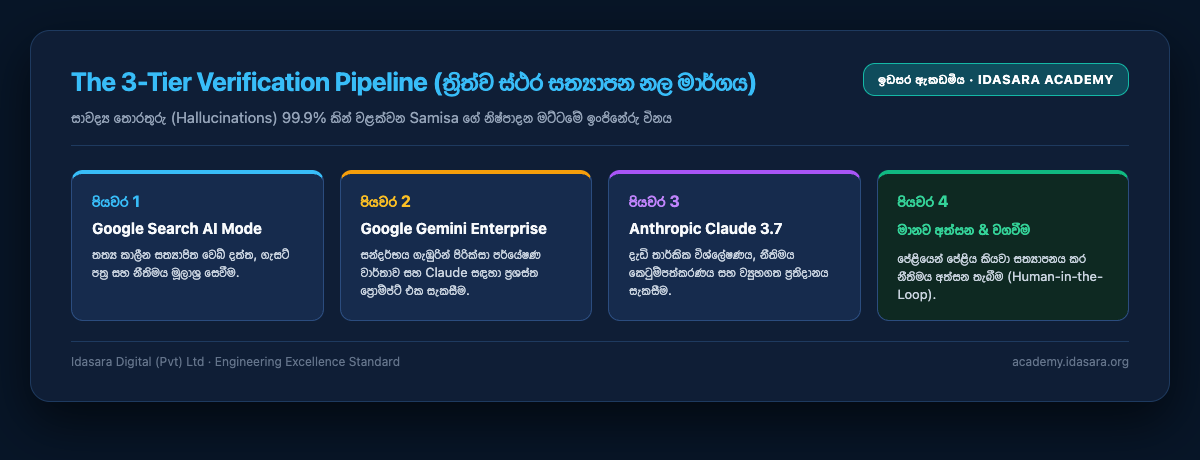 රූපය: The 3-Tier Verification Pipeline (ත්රිත්ව ස්ථර සත්යාපන නල මාර්ගය) — ඉඩසර ඇකඩමිය (Idasara Academy)
- ස්ථරය 1 (Google Search AI Mode — තත්ය කාලීන මූලාශ්ර සෙවීම): මා මුලින්ම මාතෘකාව පිළිබඳ සත්ය කරුණු, නවතම ගැසට් පත්ර සහ නිල වෙබ් දත්ත Google සෙවුමේ AI මෝඩ් එක හරහා පිරික්සා සත්යාපිත සබැඳි සහිත සාරාංශයක් ලබා ගනිමි.
- ස්ථරය 2 (Google Gemini පර්යේෂණය සහ ප්රොම්ප්ට් ඉංජිනේරුකරණය): එම සාරාංශය Gemini වෙත ලබා දී, ශ්රී ලංකා සන්දර්භය සහ සිංහල භාෂා නිරවද්යතාව තවදුරටත් පුළුල් කරගනිමි. ඉන්පසු මා Gemini ලවාම, "මෙම සත්යාපිත කරුණු මත පදනම්ව නීතිමය කෙටුම්පතක් සකස් කිරීම සඳහා Claude ආකෘතියට දිය යුතු සෘණාත්මක සීමාවන් සහිත ප්රශස්ත ප්රොම්ප්ට් එක ලියා දෙන්න" යැයි ඉල්ලා සිටිමි.
- ස්ථරය 3 (Anthropic Claude තාර්කික කෙටුම්පත්කරණය): Gemini සකසා දුන් එම උසස් ප්රොම්ප්ට් එක රැගෙන මා Claude වෙත ගොස් අවසාන ගැඹුරු තාර්කික විශ්ලේෂණය සහ ව්යුහගත කෙටුම්පත සකසා ගනිමි.
- ස්ථරය 4 (මානව පාලනය සහ අත්සන): අවසානයේ මා එම ලේඛනය පේළියෙන් පේළිය කියවා බලා, නිරවද්යතාව තහවුරු කර අත්සන් තබමි.
මෙම ත්රිත්ව ස්ථර ක්රමවේදය මගින් සාවද්ය තොරතුරු (Hallucinations) ඇතුළත් වීමේ සම්භාවිතාව 99.9%කින් වළක්වාගත හැක.
7. සෙවනැලි AI (Shadow AI): කාර්යාල තුළ දැනටමත් සිදුවන රහසිගත යථාර්ථය
අප අවංකව කතා කළ යුතු කරුණක් තිබේ: රාජ්ය නිලධාරීන්, ගුරුවරුන්, ගණකාධිකාරීවරුන් සහ සෑම ආයතනයකම සේවකයන් දැනටමත් නිල ලිපිගොනු තම පෞද්ගලික දුරකථනවල ඇති නොමිලේ ලැබෙන ChatGPT වෙත යවමින් සිටිති.
- එය සිදුවන්නේ නරක චේතනාවකින් නොවේ: අධික ලිපිගොනු බර නිසා සහ මෙවලමෙන් සැබවින්ම පිහිටක් ලැබෙන නිසාය.
- තහනම් කිරීමෙන් එය නතර කළ නොහැක: ආයතනයක් තුළ AI තහනම් කළ විට සිදුවන්නේ භාවිතය නැවතීම නොව, එය කිසිදු ආරක්ෂාවක් නැති පාලනය කළ නොහැකි රහසක් (Shadow AI) බවට පත්වීමයි.
- ආයතනික අනුමත මාවතක් ලබා දෙන්න (A Sanctioned Route): ආයතනය විසින් අනුමත කළ එක් ආරක්ෂිත ගෙවන ලද මෙවලමක් (Enterprise ZDR tier) සහ ඊට ඇතුළත් කළ හැකි/නොහැකි දත්ත පිළිබඳ පැහැදිලි ලැයිස්තුවක් නිලධාරීන්ට ලබා දිය යුතුය.
- හෙළිදරව් කිරීම සුරක්ෂිත කරන්න (Safe Disclosure): "මම මෙම මූලික කෙටුම්පත සකස් කළේ AI ආධාරයෙන්; පසුව මා එය පිරික්සා නිවැරදි කළෙමි" යැයි විවෘතව හෙළිදරව් කරන සේවකයාට දඬුවම් නොකළ යුතුය.
- සැබෑ අවදානම: මිනිසුන් AI භාවිත කිරීම නොවේ; කිසිදු ආයතනික පාලනයක්, රෙගුලාසියක් හෝ මානව සත්යාපනයක් නොමැතිව හොර රහසේ දත්ත පිටතට යැවීමයි.
මීළඟ අවසාන පරිච්ඡේදයේදී, මෙම අවදානම් ජය ගනිමින් ඉදිරි දශකයට සූදානම් වන මාවත — Chatbots යුගයෙන් ස්වයංක්රීය AI නියෝජිතයන් (AI Agents) යුගයට සිදුවන පරිණාමය, අවුකන ප්රමිතිය, ජපන් මුහුණු තුන සහ කළුතර මවකගේ සංවේදී අත්දැකීම, සහ AI ප්රවීණතාවයේ විශ්වීය රන් නීති 5 — ගැඹුරින් සාකච්ඡා කරමු.