තවත් භාෂාවලින්: English · தமிழ்
03. මහා පරිමාණ භාෂා ආකෘති (LLMs), GPTs සහ පද්ධති නිර්මාණ සැලැස්ම
ප්රකාශිත 2026-09-14
මෙම පරිච්ඡේදය CM-02: මහා පරිමාණ භාෂා ආකෘති (LLMs), ස්නායුක ජාල සහ සංජානන ජෛව අනුකරණය හි රාජ්ය නිලධාරීන් සඳහා වූ සංස්කරණයයි. පොදු පැහැදිලි කිරීම එහි ඇත; මෙහි ඇත්තේ රාජ්ය කාර්යාලයක රැකියාවේදී වෙනස් වන දේ පමණි.
AI, Generative AI, LLM සහ GPT අතර ඇති සංකල්පීය වෙනස කුමක්ද?
රාජ්ය සේවයේ නිලධාරීන් නිතර භාවිත කරන මෙම වචන හතර අතර ඇති නිශ්චිත සම්බන්ධය වටහා ගැනීම අතිශය වැදගත්ය. මෙය එකක් තුළ එකක් අඩංගු වන කේන්ද්රීය කව හතරක් (Taxonomy of AI) ලෙස දැක්විය හැක:
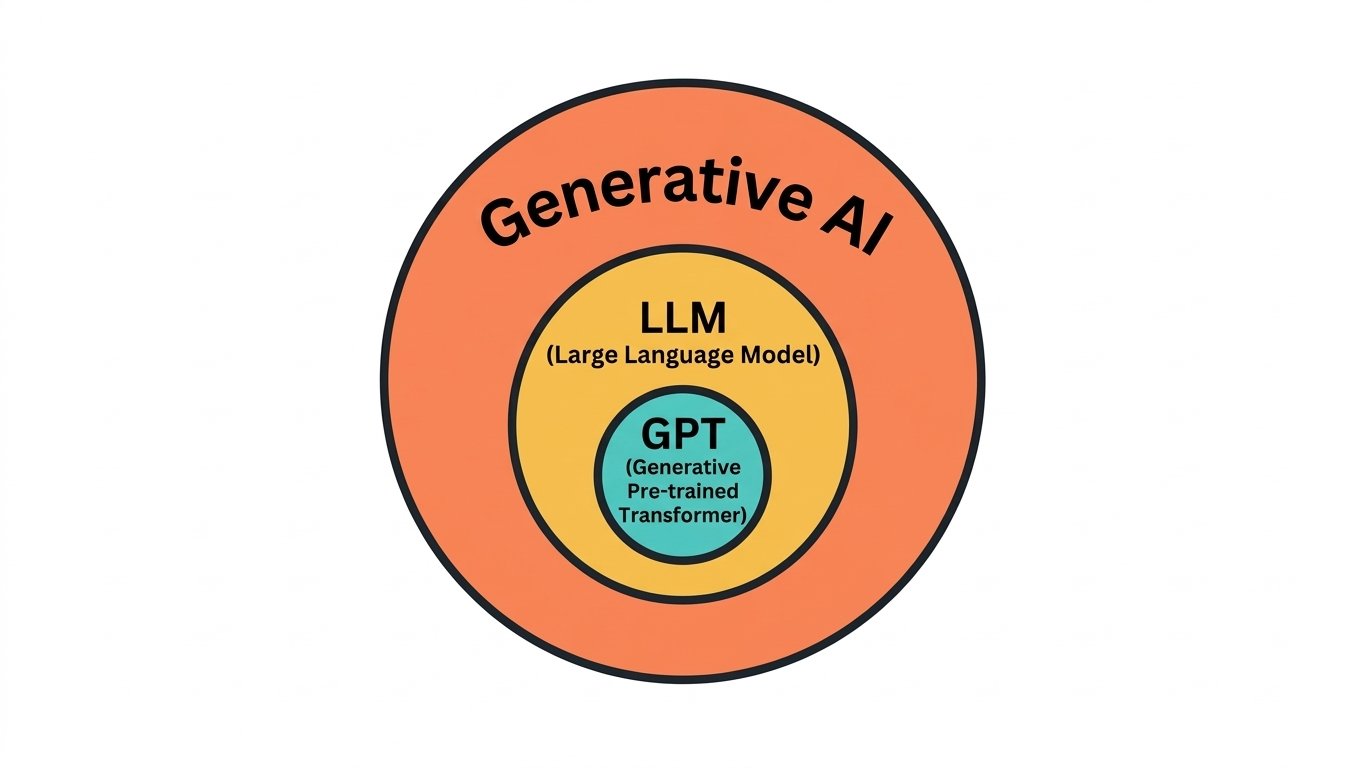 රූපය 3.1: AI, Generative AI, LLMs සහ GPT අතර ධුරාවලි සම්බන්ධතාවය.
ඉංජිනේරුවන් මිනිස් මොළයේ ක්රියාකාරිත්වය ආදර්ශයට ගත්තේ ඇයි?
යාන්ත්රික ජෛව අනුකරණයේ සිට සංජානන ජෛව අනුකරණය දක්වා: ස්නායුක ජාල (Neural Networks)
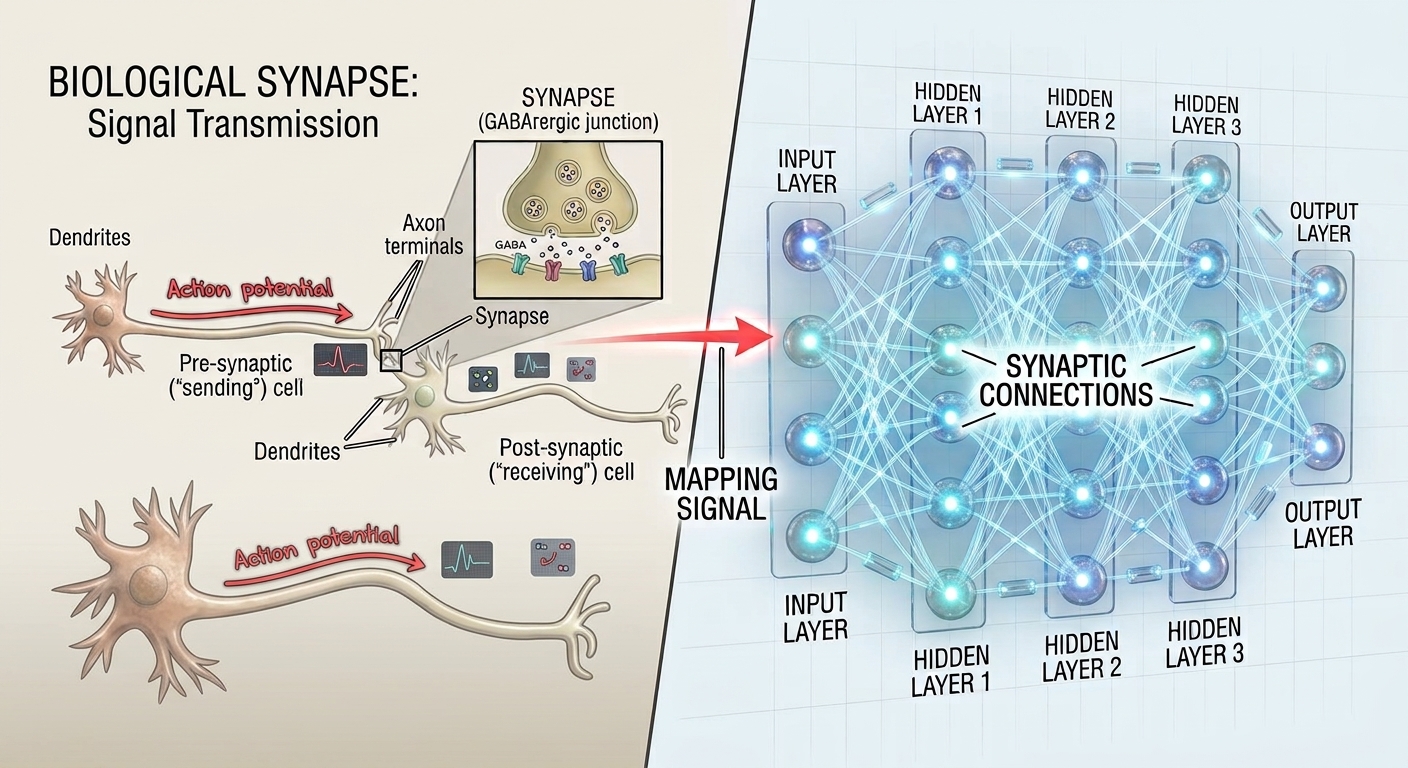 රූපය 3.3: සංජානන ජෛව අනුකරණය — මිනිස් මොළයේ නියුරෝන සහ සයිනැප්ස් ක්රියාකාරිත්වය කෘත්රිම ස්නායුක ජාල (Artificial Neural Network) සමග 1:1 ඉංජිනේරුමය වශයෙන් සමාන්තර වීම.
ජීව විද්යාත්මක මොළය සහ කෘත්රිම ස්නායුක ජාලය (LLM) අතර 1:1 ඉංජිනේරුමය සමාන්තරය:
| ජීව විද්යාත්මක මොළය (Biological Brain) | කෘත්රිම ස්නායුක ජාලය / LLM (Artificial Neural Network) | ඉංජිනේරුමය කාර්යභාරය (Function) |
|---|---|---|
| නියුරෝනය (Neuron) | කෘත්රිම නෝඩය (Node / Artificial Neuron) | තොරතුරු හෝ සංඛ්යාත්මක අගයන් සකසන මූලික ඒකකය |
| ඩෙන්ඩ්රයිට (Dendrites) | ආදාන දෛශික (Input Vectors / Weights) | පෙර ස්ථරවලින් සංඥා ලබා ගන්නා ආදාන මාවත් |
| ඇක්සෝනය (Axon) | සක්රියන ශ්රිතය (Activation Function - ReLU/GELU) | සැකසූ තොරතුරු ඊළඟ ස්ථරයට යවන සංඥා නාලිකාව |
| සයිනැප්ස් (Synapse) | භාර / පරාමිතීන් (Weights & Biases / Parameters) | නියුරෝන අතර සම්බන්ධතාවයේ ප්රබලතාව තීරණය කරන අගයන් |
| ස්නායු ප්ලාස්ටික්තාව (Neuroplasticity) | පසුපසට ප්රචාරණය (Backpropagation & Gradient Descent) | වැරදිවලින් ඉගෙන ගනිමින් පරාමිතීන් යාවත්කාලීන කිරීමේ හැකියාව |
Transformer මොළය තුළ සැබවින්ම පවතින්නේ කුමක්ද?
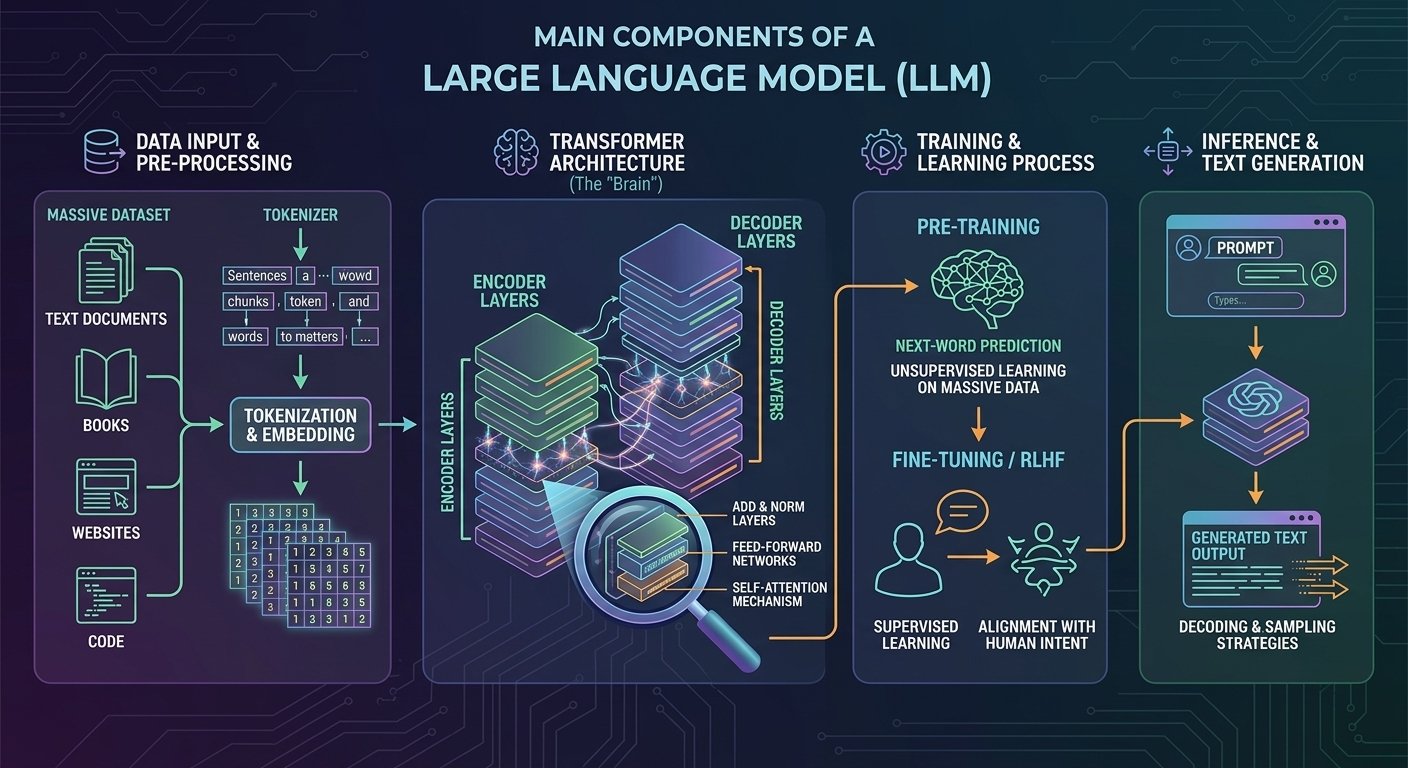 රූපය 3.4: මහා පරිමාණ භාෂා ආකෘතියක (LLM) මූලික පද්ධති නිර්මාණ සැලැස්ම — දැවැන්ත දත්ත සමුදාය, ටෝකනීකරණය සහ එම්බෙඩින්, ට්රාන්ස්ෆෝමර් මොළය, පුහුණු ක්රියාවලිය (Pre-training & RLHF) සහ අනුමාන ප්රතිදානය (Inference).
දෙවන අදියර: ටෝකනීකරණය සහ එම්බෙඩින්ග් (Tokenization & Embedding)
පෙළ දත්ත කුඩා අක්ෂර ඛණ්ඩ හෙවත් ටෝකන (Tokens) බවට කඩා දැමීම මෙහිදී සිදු වේ. අනතුරුව දෛශික එම්බෙඩින් (Vector Embedding) මගින් සෑම ටෝකනයකටම මානයන් දහස් ගණනක් ඇති බහුමාන ගණිතමය අවකාශයක ඛණ්ඩාංක ලබා දේ. අර්ථයෙන් සමාන වචන ("ප්රාදේශීය ලේකම්" සහ "දිසාපති") මෙම අවකාශයේ ඉතා සමීපව ස්ථානගත වේ.
හතරවන අදියර: පුහුණු කිරීම සහ ඉගෙනීම (Training & Learning)
පූර්ව පුහුණුවේදී ට්රිලියන ගණනක් වචන කියවමින්, "ඊළඟ වචනය කුමක්දැයි" අනුමාන කිරීම (Next-Word Prediction) මගින් භාෂාවේ ව්යාකරණ සහ තර්කනය ග්රහණය කරගනී. අනතුරුව මානව ප්රතිපෝෂණ මගින් සුසර කිරීම (RLHF) හරහා රාජ්ය සේවයට හා සමාජයට උචිත, ආරක්ෂිත, විනීත සහ සත්යවාදී පිළිතුරු දීමට ආකෘතිය හැඩගස්වනු ලබයි.
LLM යනු සත්යයේ එන්ජිමක් නොව සම්භාවිතා එන්ජිමක් වන්නේ ඇයි?
රාජ්ය නිලධාරියෙකු තේරුම් ගත යුතු අතිශය තීරණාත්මක පාඩම මෙයයි: * LLM යනු දත්ත සමුදායක් (Database) නොවේ. එය තොරතුරු ගබඩා කරගෙන නැත. * LLM යනු සත්යය දන්නා සත්යයේ එන්ජිමක් (Truth Engine) නොවේ. * එය පිරිසිදු සම්භාවිතා එන්ජිමකි (Plausibility / Probability Engine).
එබැවින්, රාජ්ය සේවයේ ප්රතිපත්තිමය හෝ නීතිමය තීන්දු ගැනීමේදී, AI ලබා දෙන තොරතුරු නැවත සත්යාපනය කිරීමේ (Verification) වගකීම 100% ක්ම මානව නිලධාරියා සතු වේ!
සිංහල සහ දෙමළ භාෂාවලදී ආකෘතිවල ප්රතිඵල වෙනස් වන්නේ ඇයි?
බටහිර දැනුමේ පක්ෂග්රාහීත්වය (Western Knowledge Bias)
ලෝකයේ ප්රමුඛතම LLM පුහුණු කිරීම සඳහා යොදාගත් අන්තර්ජාල දත්තවලින් 85% කට වඩා ඇත්තේ ඉංග්රීසි භාෂාවෙනි. බටහිර ලෝකයේ ඉතිහාසය, නීතිය සහ සංස්කෘතිය මෙම ආකෘති තුළ ගැඹුරින් තැන්පත්ව ඇති මුත්, ශ්රී ලංකාවේ සංස්කෘතිය, චක්රලේඛ හෝ රාජ්ය පරිපාලන ව්යුහය පිළිබඳ ඒවායේ ඇති දැනුම සාපේක්ෂව අඩුය.
සිංහලට වඩා දෙමළ භාෂාව සාර්ථක වීමට හේතුව (Why Tamil Fares Better than Sinhala)
ශ්රී ලංකාවේ දෙමළ භාෂාව භාවිත කරන නිලධාරීන්ට AI මෙවලම් භාවිතය සාපේක්ෂව පහසුය. මන්ද, ඉන්දියාවේ තමිල්නාඩුව ඇතුළු ලොව පුරා කෝටි ගණනක් දෙමළ ජනතාව විසින් අන්තර්ජාලයට එක්කර ඇති අතිවිශාල දෙමළ සාහිත්යයක් සහ ඩිජිටල් දත්ත පද්ධතියක් පවතින බැවිනි. නමුත් සිංහල භාෂාව කතා කරන්නේ ලෝකයේ අපේ රටේ කෝටි දෙකකට ආසන්න ජනතාව පමණි. අප අන්තර්ජාලයට එක්කර ඇති ඩිජිටල් සිංහල අන්තර්ගතය ඉතා සීමිතය. එබැවින් සිංහල භාෂාවෙන් AI භාවිත කිරීමේදී අප විශේෂයෙන් විමසිලිමත් විය යුතුය.
බහු-ආකෘතික AI (Multimodal AI) යන්නෙහි සැබෑ අරුත කුමක්ද?
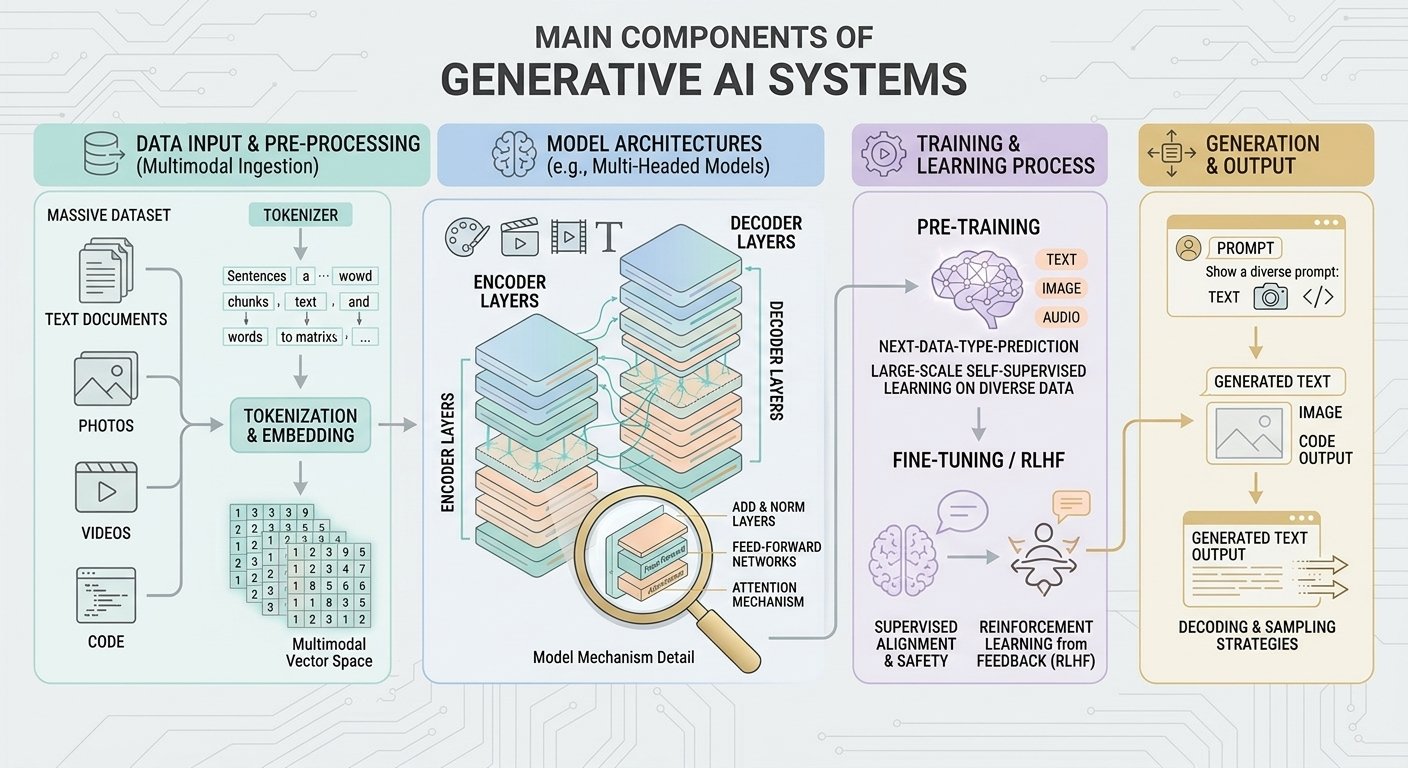 රූපය 3.5: බහු-ආකෘතික උත්පාදක AI පද්ධතියක පද්ධති නිර්මාණ සැලැස්ම — බහු-මාදිලි දත්ත ආදානය, ඒකාබද්ධ බහුමාන දෛශික අවකාශය, බහු-ශීර්ෂ ට්රාන්ස්ෆෝමරය සහ බහු-මාදිලි ප්රතිදානය.
රාජ්ය නිලධාරියාට මෙමගින් ලැබෙන ප්රායෝගික වටිනාකම
- අතින් ලියන ලද පැරණි ඉඩම් ඔප්පුවක හෝ ලිපියක ඡායාරූපයක් ඇතුළත් කර එහි අන්තර්ගතය තත්පරයකින් කියවා ගැනීම (Vision OCR).
- මහජන දිනයේදී පුරවැසියෙකු ඉදිරිපත් කරන ගැටලුවක හඬපටයක් ඇතුළත් කර ක්ෂණික නිල විමර්ශන සටහනක් සකස් කිරීම.
- සංකීර්ණ සංවර්ධන සැලැස්මක සිතියමක් හෝ ප්රස්ථාරයක් විග්රහ කර එහි නොගැළපීම් හඳුනා ගැනීම.
ඊළඟ පරිච්ඡේදයේදී, මෙම ස්වභාවික භාෂා විප්ලවය හේතුවෙන් මානව ශාස්ත්ර නැවත කරලියට පැමිණෙන්නේ කෙසේද, සහ සාමාන්ය පුරවැසියා මුහුණ දෙන ඩිජිටල් පරතරය AI මගින් පියවන්නේ කෙසේද යන්න සාකච්ඡා කරමු.