பிற மொழிகளில்: English · සිංහල
03. பெரிய மொழி மாதிரிகள் (LLMs), GPTs மற்றும் கட்டமைப்பு
வெளியிடப்பட்டது 2026-09-14
இந்த அத்தியாயம் CM-02: பெரிய மொழி மாதிரிகள் (LLMs), நரம்பியல் நெட்வொர்க்குகள் மற்றும் அறிவாற்றல் உயிரியல் போலாக்கம் இன் அரச அலுவலர்களுக்கான பதிப்பு. பொதுவான விளக்கம் அங்கே உள்ளது; அரச அலுவலகத்தில் பணியாற்றும்போது மாறுபடுவதை மட்டுமே இந்தப் பக்கம் வைத்திருக்கிறது.
AI, ஆக்கபூர்வ AI, LLM மற்றும் GPT ஆகியவற்றிற்கு இடையிலான வேறுபாடு யாது?
அரசு அதிகாரிகள் மத்தியில் அடிக்கடி பயன்படுத்தப்படும் இந்த நான்கு சொற்களுக்கு இடையிலான சரியான உறவைப் புரிந்து கொள்வது மிகவும் அவசியமானது. இதனை ஒன்றுக்குள் ஒன்றாக அடங்கும் நான்கு மைய வட்டங்களாகக் (Taxonomy of AI) குறிப்பிடலாம்:
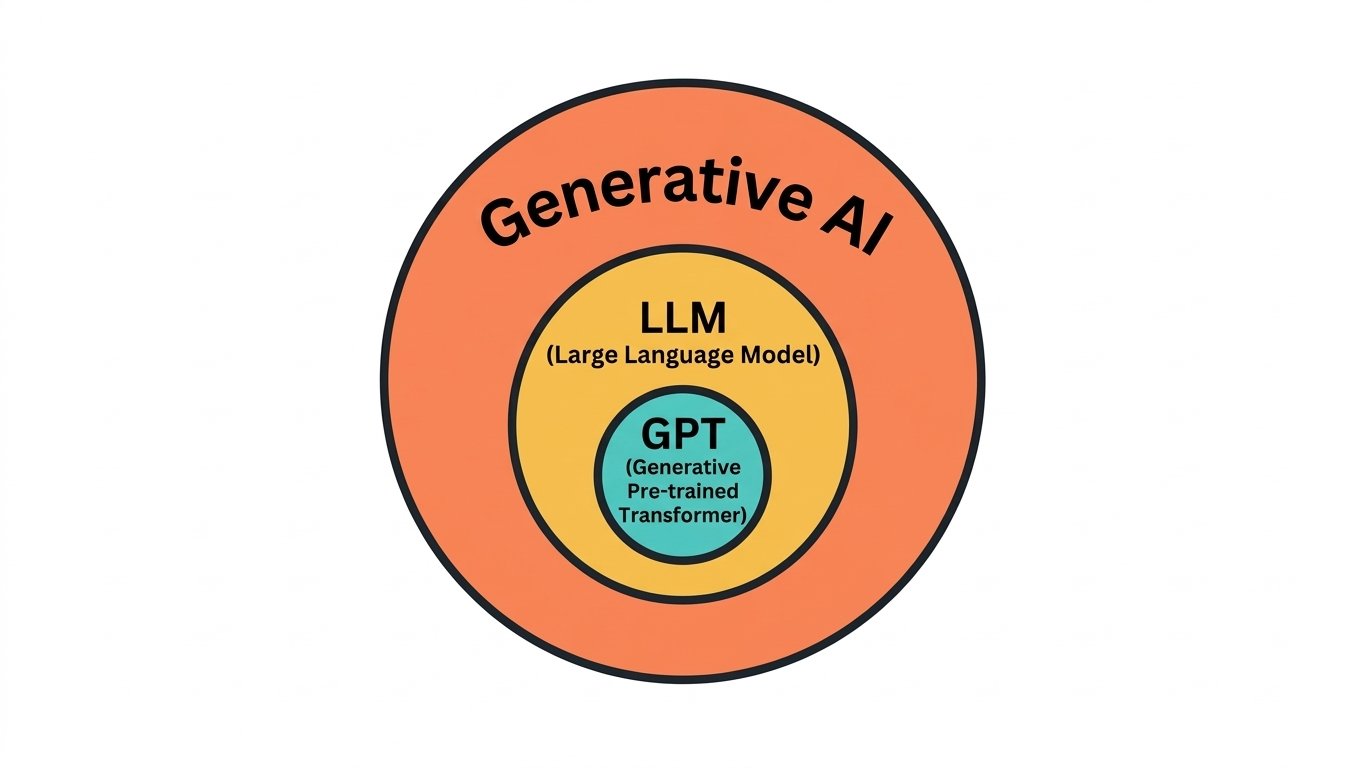 படம் 3.1: AI, Generative AI, LLMs மற்றும் GPT ஆகியவற்றுக்கு இடையிலான படிநிலைத் தொடர்பு.
பொறியியலாளர்கள் மனித மூளையின் செயல்பாட்டை முன்மாதிரியாக எடுத்தது ஏன்?
எந்திரவியல் உயிரியல் போலாக்கத்திலிருந்து அறிவாற்றல் உயிரியல் போலாக்கம் வரை: நரம்பியல் நெட்வொர்க்குகள்
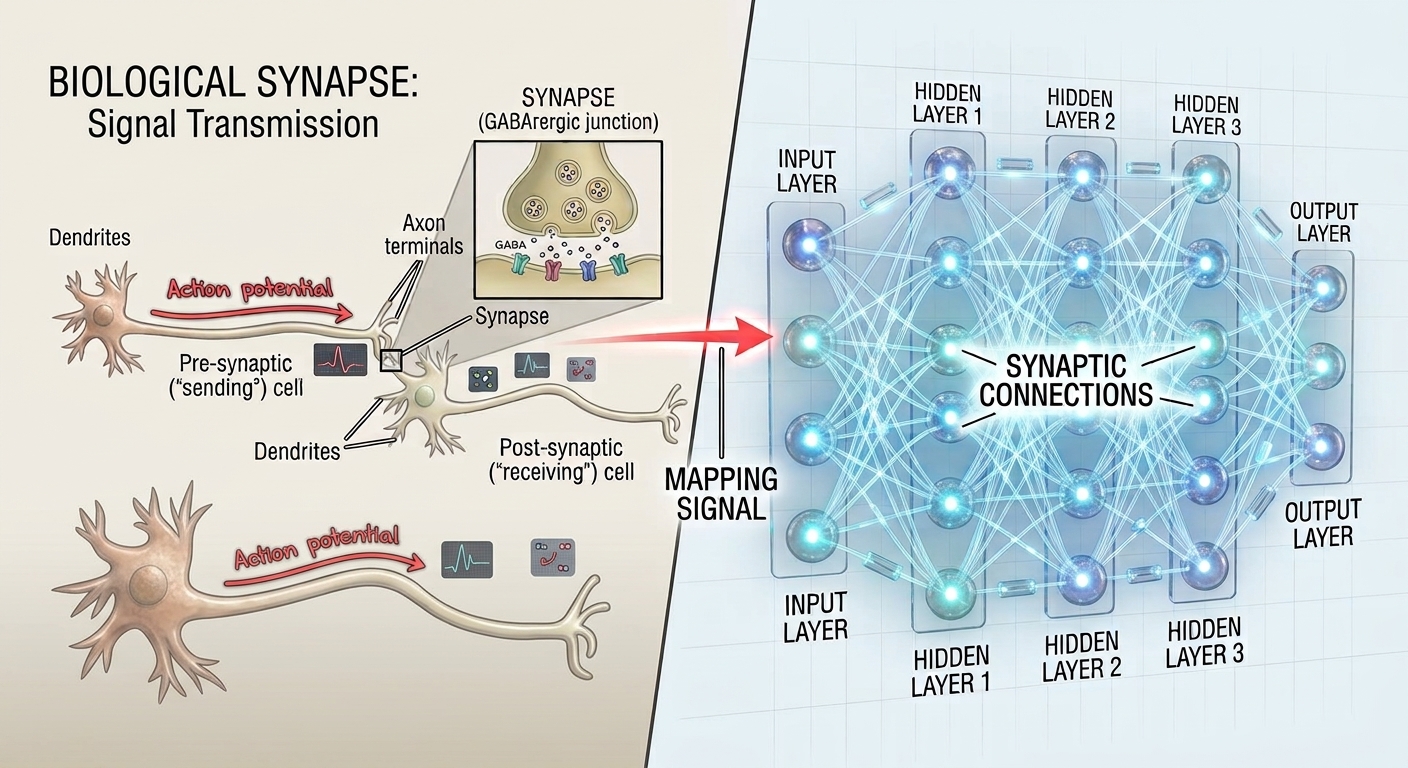 படம் 3.3: அறிவாற்றல் உயிரியல் போலாக்கம் — மனித மூளையின் நியூரான்கள் மற்றும் சினாப்ஸ்களின் செயல்பாடு செயற்கை நரம்பியல் நெட்வொர்க்குடன் (LLM) 1:1 பொறியியல் ரீதியாக இணையாக அமைதல்.
உயிரியல் மூளைக்கும் செயற்கை நரம்பியல் நெட்வொர்க்கிற்கும் (LLM) இடையிலான 1:1 பொறியியல் ஒப்பீடு:
| உயிரியல் மூளை (Biological Brain) | செயற்கை நரம்பியல் நெட்வொர்க் / LLM (Artificial Neural Network) | பொறியியல் செயல்பாடு (Function) |
|---|---|---|
| நியூரான் (Neuron) | செயற்கை முனை (Node / Artificial Neuron) | தகவல்களை அல்லது எண்களைச் செயலாக்கும் அடிப்படை அலகு |
| டென்ட்ரைட்டுகள் (Dendrites) | உள்ளீட்டு திசையன்கள் (Input Vectors / Weights) | முந்தைய அடுக்குகளிலிருந்து சமிக்ஞைகளைப் பெறும் உள்ளீட்டு வழிகள் |
| ஆக்சான் (Axon) | செயல்படுத்தும் செயல்பாடு (Activation Function - ReLU/GELU) | செயலாக்கப்பட்ட தகவலை அடுத்த அடுக்குக்கு அனுப்பும் சேனல் |
| சினாப்ஸ் (Synapse) | எடைகள் / அளவுருக்கள் (Weights & Biases / Parameters) | நியூரான்களுக்கு இடையிலான தொடர்பின் வலிமையைத் தீர்மானிக்கும் மதிப்புகள் |
| நியூரோபிளாஸ்டிசிட்டி (Neuroplasticity) | பின்புறப் பரவல் (Backpropagation & Gradient Descent) | பிழைகளிலிருந்து கற்றுக்கொண்டு அளவுருக்களைப் புதுப்பிக்கும் திறன் |
டிரான்ஸ்ஃபார்மர் மூளையின் உள்ளே உண்மையில் இருப்பது என்ன?
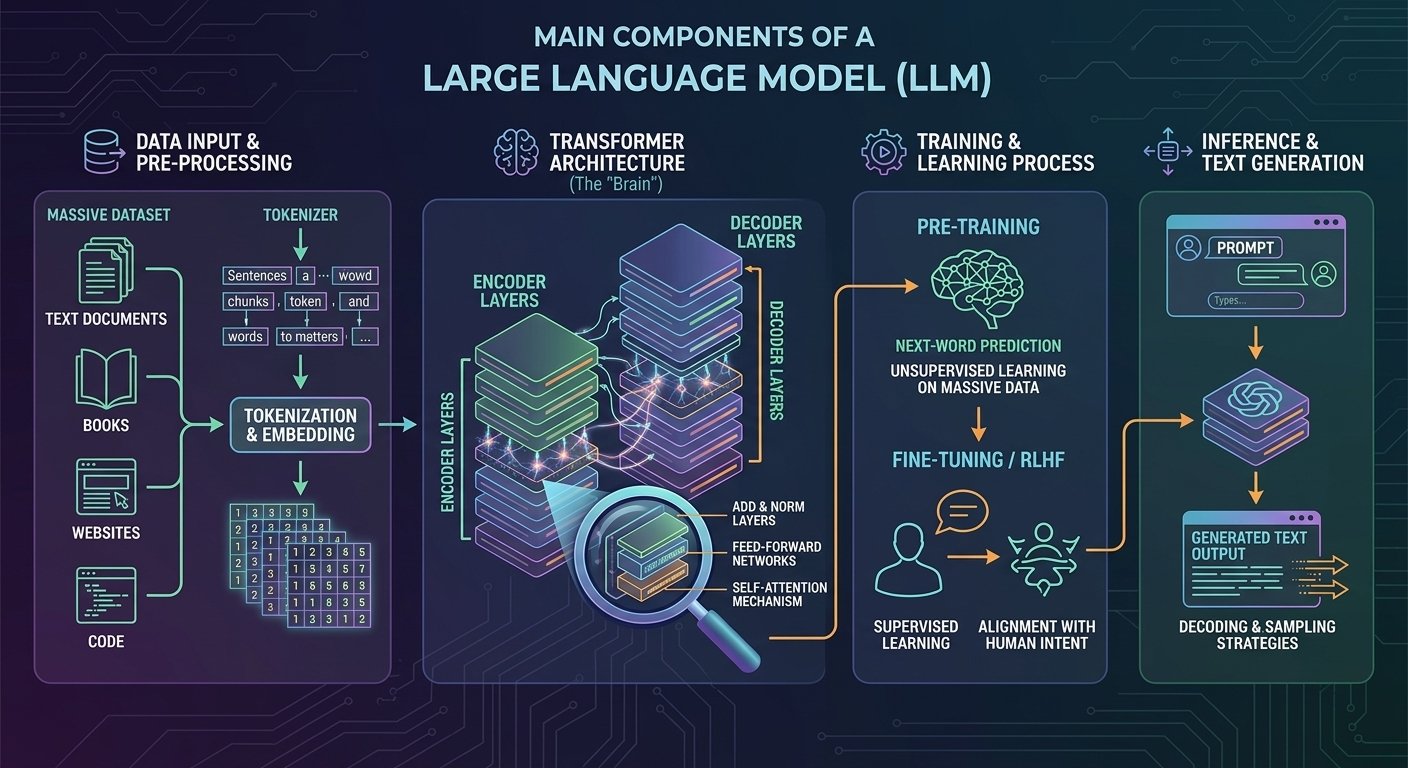 படம் 3.4: ஒரு பெரிய மொழி மாதிரியின் (LLM) அடிப்படைக் கட்டமைப்பு — பிரம்மாண்டமான தரவுத்தொகுப்பு, டோக்கனாக்கம் மற்றும் உட்பொதித்தல், டிரான்ஸ்ஃபார்மர் மூளை, பயிற்சி செயல்முறை (Pre-training & RLHF) மற்றும் அனுமான வெளியீடு (Inference).
இரண்டாம் படி: டோக்கனாக்கம் மற்றும் உட்பொதித்தல் (Tokenization & Embedding)
உரைத் தரவு சிறிய எழுத்துத் துண்டுகளாக அல்லது டோக்கன்களாகப் (Tokens) பிரிக்கப்படுகிறது. பின்னர் திசையன் உட்பொதித்தல் (Vector Embedding) மூலம் ஒவ்வொரு டோக்கனுக்கும் பல்லாயிரக்கணக்கான பரிமாணங்களைக் கொண்ட கணித வெளியில் ஆயத்தொலைவுகள் (coordinates) ஒதுக்கப்படுகின்றன. ஒரே அர்த்தம் கொண்ட சொற்கள் ("பிரதேச செயலாளர்" மற்றும் "மாவட்ட செயலாளர்") இந்த வெளியில் மிக நெருக்கமாக அமைகின்றன.
நான்காம் படி: பயிற்சி மற்றும் கற்றல் (Training & Learning)
முன்-பயிற்சியில் டிரில்லியன் கணக்கான சொற்களைப் படித்து, "அடுத்த சொல் என்ன" என்பதை கணிப்பதன் (Next-Word Prediction) மூலம் மொழியின் இலக்கணம் மற்றும் தர்க்கத்தை உள்வாங்குகிறது. பின்னர் மனிதக் கருத்துகள் மூலம் சரிசெய்தல் (RLHF) வழியாக அரசுத்துறை மற்றும் சமுதாயத்திற்கு உகந்த, பாதுகாப்பான மற்றும் உண்மையான பதில்களைத் தரும் வகையில் மாதிரி சீரமைக்கப்படுகிறது.
LLM என்பது உண்மை இயந்திரம் அல்லாமல் சாத்தியக்கூறு இயந்திரமாக அமைவது ஏன்?
ஓர் அரசு அதிகாரி புரிந்து கொள்ள வேண்டிய மிக முக்கியமான பாடம் இதுவேயாகும்: * LLM என்பது ஒரு தரவுத்தளம் (Database) அல்ல. அது தகவல்களைச் சேமித்து வைத்திருக்கவில்லை. * LLM என்பது உண்மையை மட்டுமே பேசும் உண்மை இயந்திரமும் (Truth Engine) அல்ல. * அது முற்றிலும் ஒரு சாத்தியக்கூறு இயந்திரம் (Plausibility / Probability Engine) மட்டுமே.
எனவே, அரசு சேவையில் கொள்கை அல்லது சட்ட ரீதியான முடிவுகளை எடுக்கும் போது, AI தரும் தகவல்களை மீண்டும் சரிபார்க்கும் (Verification) பொறுப்பு 100% மனித அதிகாரியிடமே உள்ளது!
தமிழ் மற்றும் சிங்கள மொழிகளில் AI மாதிரிகள் வேறுபடுவது ஏன்?
மேற்கத்திய அறிவுப் சார்பு (Western Knowledge Bias)
உலகின் முன்னணி LLM மாதிரிகளைப் பயிற்றுவிக்கப் பயன்படுத்தப்பட்ட இணையத் தரவுகளில் 85% க்கும் அதிகமானவை ஆங்கில மொழியிலேயே உள்ளன. மேற்கத்திய உலகின் வரலாறு, சட்டம் மற்றும் கலாச்சாரம் இம்மாதிரிகளுக்குள் ஆழமாகப் பதிந்துள்ள போதிலும், இலங்கையின் கலாச்சாரம், சுற்றறிக்கைகள் அல்லது அரச நிர்வாகக் கட்டமைப்பு குறித்த அறிவு ஒப்பீட்டளவில் குறைவாகவே உள்ளது.
சிங்களத்தை விட தமிழ் சிறப்பாகச் செயல்படுவது ஏன்? (Why Tamil Fares Better than Sinhala)
இலங்கையில் தமிழ் மொழியைப் பயன்படுத்தும் அரசு அதிகாரிகளுக்கு AI கருவிகளைப் பயன்படுத்துவது ஒப்பீட்டளவில் எளிதானது. ஏனெனில், இந்தியாவின் தமிழ்நாடு உட்பட உலகம் முழுவதும் உள்ள பல கோடி தமிழ் மக்களால் இணையத்தில் சேர்க்கப்பட்ட பிரம்மாண்டமான தமிழ் இலக்கியங்களும் டிஜிட்டல் உள்ளடக்கங்களும் உள்ளன. ஆனால் சிங்கள மொழியைப் பேசுபவர்கள் உலகில் சுமார் இரண்டு கோடி பேர் மட்டுமே. நாம் இணையத்தில் சேர்த்துள்ள டிஜிட்டல் சிங்கள உள்ளடக்கம் மிகவும் குறைவு. எனவே சிங்களத்தில் AI-யைப் பயன்படுத்தும் போது கூடுதல் விழிப்புணர்வு தேவைப்படுகிறது.
பல்தொகுதி AI (Multimodal AI) என்பதன் உண்மையான அர்த்தம் என்ன?
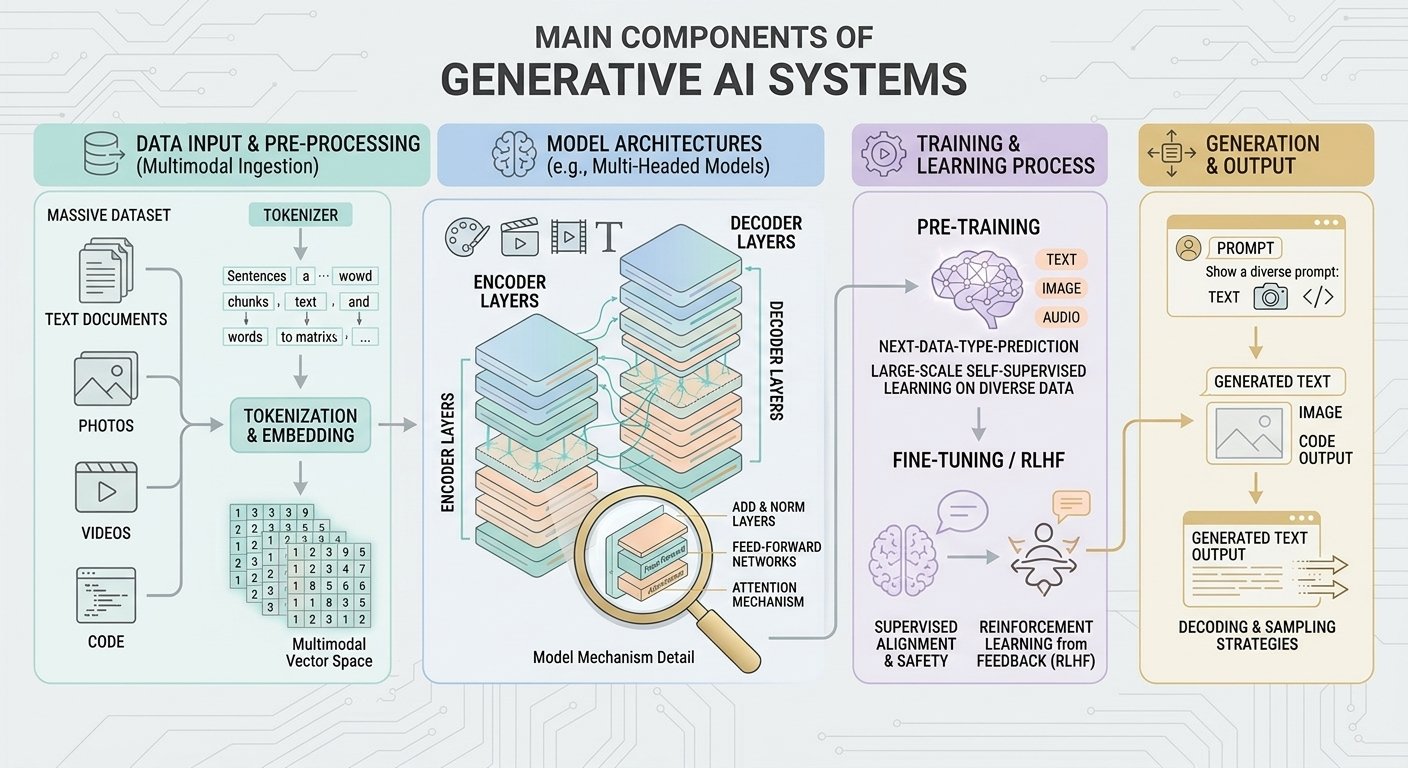 படம் 3.5: பல்தொகுதி ஆக்கபூர்வ AI அமைப்பின் கட்டமைப்பு — பல்தொகுதித் தரவு உள்ளீடு, ஒருங்கிணைந்த பல பரிமாண திசையன் வெளி, பல்தலை டிரான்ஸ்ஃபார்மர் மற்றும் பல்தொகுதி வெளியீடு.
அரசு அதிகாரிக்கான நடைமுறை மதிப்பு
- கையால் எழுதப்பட்ட பழைய நிலப் பத்திரம் அல்லது கடிதத்தின் புகைப்படத்தை உள்ளிட்டு அதன் உள்ளடக்கத்தை நொடிகளில் வாசித்தல் (Vision OCR).
- பொதுமக்கள் தினத்தில் குடிமகன் முன்வைக்கும் புகாரின் ஆடியோ பதிவை உள்ளிட்டு உடனடி உத்தியோகபூர்வ விசாரணைக் குறிப்பைத் தயாரித்தல்.
- சிக்கலான வளர்ச்சித் திட்ட வரைபடம் அல்லது விளக்கப்படத்தை ஆய்வு செய்து அதன் முரண்பாடுகளைக் கண்டறிதல்.
அடுத்த அத்தியாயத்தில், இந்த இயற்கை மொழிப் புரட்சியின் காரணமாக மனிதநேயக் கல்வி எவ்வாறு மீண்டும் முன்னரங்கிற்கு வருகிறது, மற்றும் சாதாரண குடிமக்கள் எதிர்கொள்ளும் டிஜிட்டல் இடைவெளியை AI எவ்வாறு குறைக்கிறது என்பதை விரிவாக ஆராய்வோம்.