තවත් භාෂාවලින්: English · தமிழ்
CM-02: මහා පරිමාණ භාෂා ආකෘති (LLMs), ස්නායුක ජාල සහ සංජානන ජෛව අනුකරණය
ප්රකාශිත 2026-09-14
බොහෝ දෙනා මහා පරිමාණ භාෂා ආකෘති (LLMs) දෙස බලන්නේ මැජික් එකක් ලෙසිනි. නමුත් එහි යටින් ඇත්තේ මිනිස් මොළයේ ක්රියාකාරිත්වය ආදර්ශයට ගනිමින් ගොඩනැගූ ස්නායුක ජාල, උසස් පෙළ සංයුක්ත ගණිතයේ එන න්යාස (Matrices) සහ දෛශික (Vectors), සහ බිලියන ගණනක් වූ සංඛ්යානමය සම්භාවිතාවන්ගේ එකතුවකි.
AI, Generative AI, LLM සහ GPT අතර ඇති සංකල්පීය වෙනස කුමක්ද?
බොහෝ දෙනා නිතර භාවිත කරන මෙම වචන හතර අතර ඇති නිශ්චිත සම්බන්ධය වටහා ගැනීම අතිශය වැදගත්ය. මෙය එකක් තුළ එකක් අඩංගු වන කේන්ද්රීය කව හතරක් (Taxonomy of AI) ලෙස දැක්විය හැක:
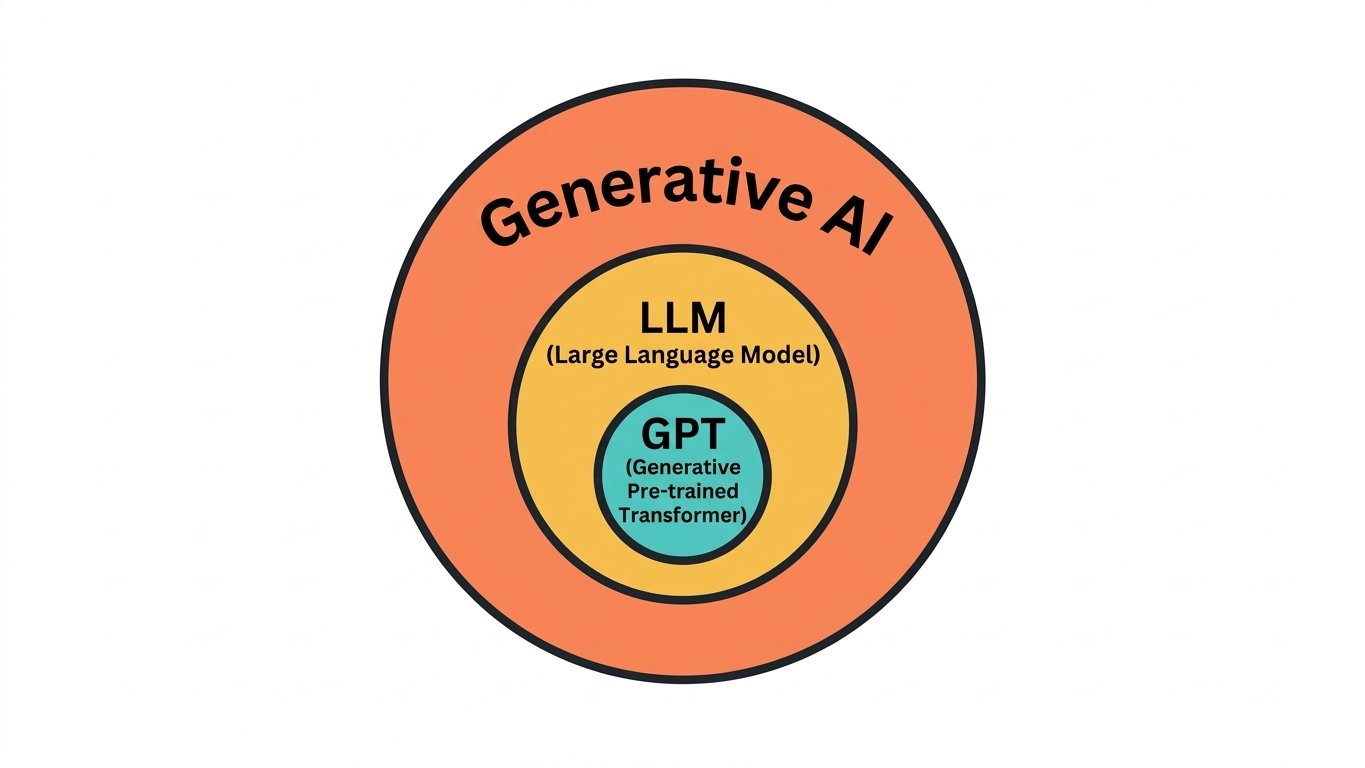 රූපය 3.1: AI, Generative AI, LLMs සහ GPT අතර ධුරාවලි සම්බන්ධතාවය.
- කෘත්රිම බුද්ධිය (Artificial Intelligence - AI): මිනිස් බුද්ධිය පරිගණක මෘදුකාංග සහ දෘඩාංග මගින් අනුකරණය කිරීමේ සමස්ත පුළුල් විෂය පථය (1950 සිට ඇරඹි).
- උත්පාදක කෘත්රිම බුද්ධිය (Generative AI): සාම්ප්රදායික AI මෙන් නොව, අලුතින් යමක් නිර්මාණය කළ හැකි (Synthesizing new original content) උප කුලකය.
- මහා පරිමාණ භාෂා ආකෘති (Large Language Models - LLMs): මිනිස් භාෂාව තේරුම් ගැනීමට සහ ලිවීමට බිලියන/ට්රිලියන ගණනක වදන් මත පූර්ව පුහුණු කරන ලද සුවිශේෂී උත්පාදක AI ආකෘති (උදා: Google Gemini, Meta LLaMA, DeepSeek).
- උත්පාදක පූර්ව-පුහුණු පරිවර්තකය (Generative Pre-trained Transformer - GPT): OpenAI සමාගම විසින් 2018 දී Transformer පද්ධති නිර්මාණ සැලැස්ම භාවිතයෙන් ලොවට හඳුන්වා දුන් නිශ්චිත වාණිජ LLM සන්නාමයකි.
ඉංජිනේරුවන් මිනිස් මොළයේ ක්රියාකාරිත්වය ආදර්ශයට ගත්තේ ඇයි?
මිනිසා විසින් ස්වභාවධර්මයේ සහ ජීව විද්යාවේ නිර්මාණ ආදර්ශයට ගනිමින් ඉංජිනේරු ගැටලු විසඳීම හඳුන්වන්නේ ජෛව අනුකරණය (Biomimicry) නමිනි.
ජපානයේ ෂින්කන්සෙන් (Shinkansen) බුලට් දුම්රිය සහ පිළිහුඩුවාගේ පාඩම
ජපානයේ අධිවේගී බුලට් දුම්රිය (Shinkansen) පැයට කිලෝමීටර් 300ක වේගයෙන් උමං මාර්ගවලින් එළියට එන විට, වායුගෝලීය පීඩනය ක්ෂණිකව වෙනස් වීම නිසා වෙඩි හඬක් බඳු බිහිසුණු ශබ්දයක් (Tunnel Boom) නිර්මාණය විය. කිලෝමීටරයක් ඈතට පවා ඇසුණු මෙම පිපිරුම් හඬ නිසා අවට ගම්වාසීන්ට නිදා ගැනීමට නොහැකි විය; උමං මාර්ග බිඳ වැටීමේ අවදානමක්ද මතු විය.
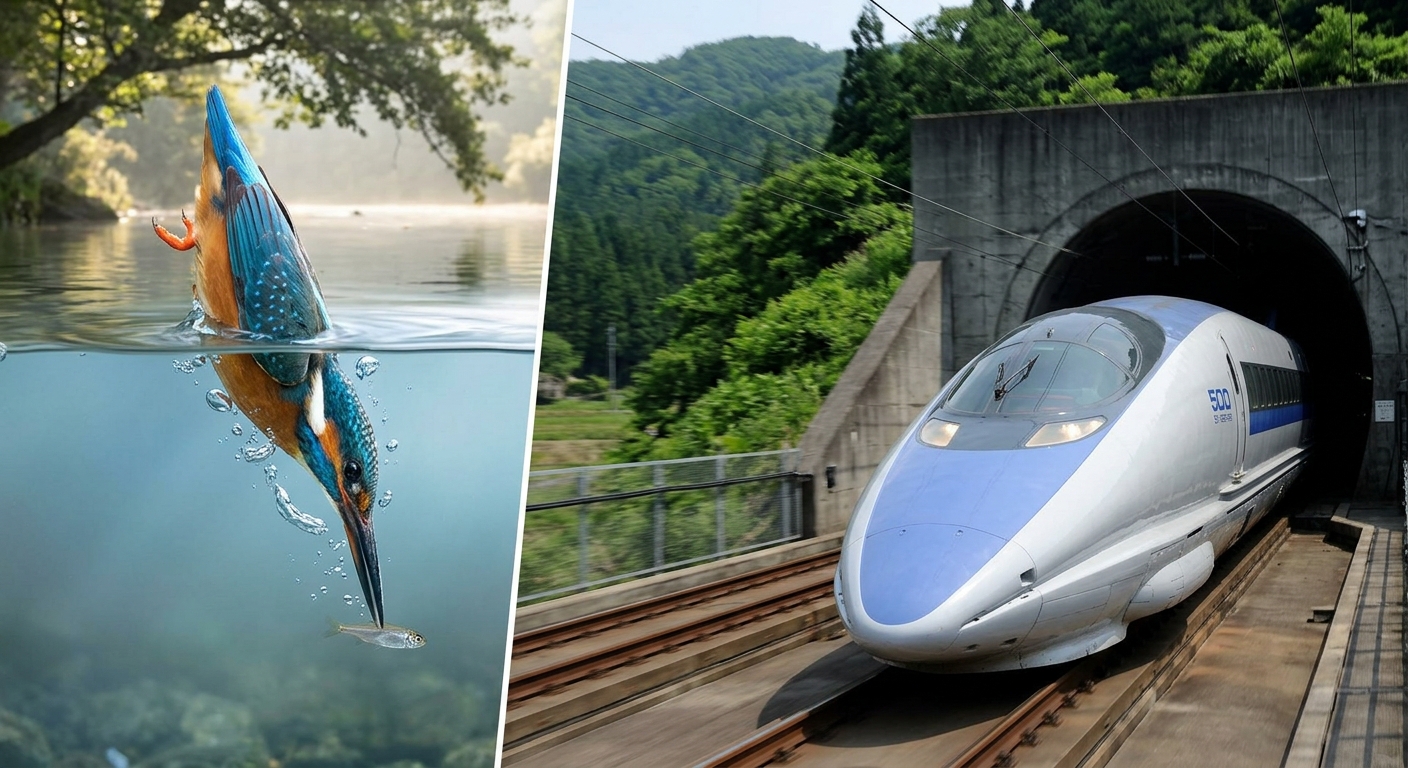 රූපය 3.2: යාන්ත්රික ජෛව අනුකරණය — පිළිහුඩුවාගේ හොට ආදර්ශයට ගනිමින් ජපානයේ Shinkansen බුලට් දුම්රියේ වායුගතික සැලසුම (Aerodynamics) නවීකරණය කිරීම.
එම ගැටලුව විසඳීමට පැමිණි ප්රධාන ඉංජිනේරුවා පක්ෂීන් නිරීක්ෂණය කරන්නෙකු (Birdwatcher) විය. ඔහු එක් අපූරු දෙයක් දුටුවේය: පිළිහුඩුවා (Kingfisher) අහසේ සිට (අඩු ඝනත්ව වාතයේ සිට) එක් දිය බිඳක්වත් නොවිසි වන සේ අධිවේගයෙන් ජලයට (වැඩි ඝනත්ව මාධ්යයකට) කිමිදෙන්නේ කෙසේද?
පිළිහුඩුවාගේ හොට කෙළවර සිහින්ව පටන්ගෙන ක්රමයෙන් හිස දෙසට ඝනකම් වන අද්විතීය ජ්යාමිතික හැඩයකින් යුක්තය. ඉංජිනේරුවන් කළේ බුලට් දුම්රියේ ඉදිරිපස හැඩය පිළිහුඩුවාගේ හොටෙහි හැඩයට අනුව සම්පූර්ණයෙන්ම ප්රතිනිර්මාණය කිරීමයි. ප්රතිඵලය වූයේ: * උමඟෙන් එළියට එන ශබ්දය 100% කින් නැති විය. * දුම්රියේ වේගය 10% කින් වැඩි විය. * විදුලිබල පරිභෝජනය 15% කින් අඩු විය!
යාන්ත්රික ජෛව අනුකරණයේ සිට සංජානන ජෛව අනුකරණය දක්වා: ස්නායුක ජාල (Neural Networks)
පිළිහුඩුවාගේ හොට අනුකරණය කර දුම්රිය හැදුවේ නම්, මිනිස් චින්තනය සහ බුද්ධිය අනුකරණය කිරීමට මිනිස් මොළය ආදර්ශයට නොගන්නේ මන්දැයි පරිගණක විද්යාඥයෝ කල්පනා කළහ. ඒ ඔස්සේ බිහිවූයේ කෘත්රිම ස්නායුක ජාල (Artificial Neural Networks - ANNs) ය.
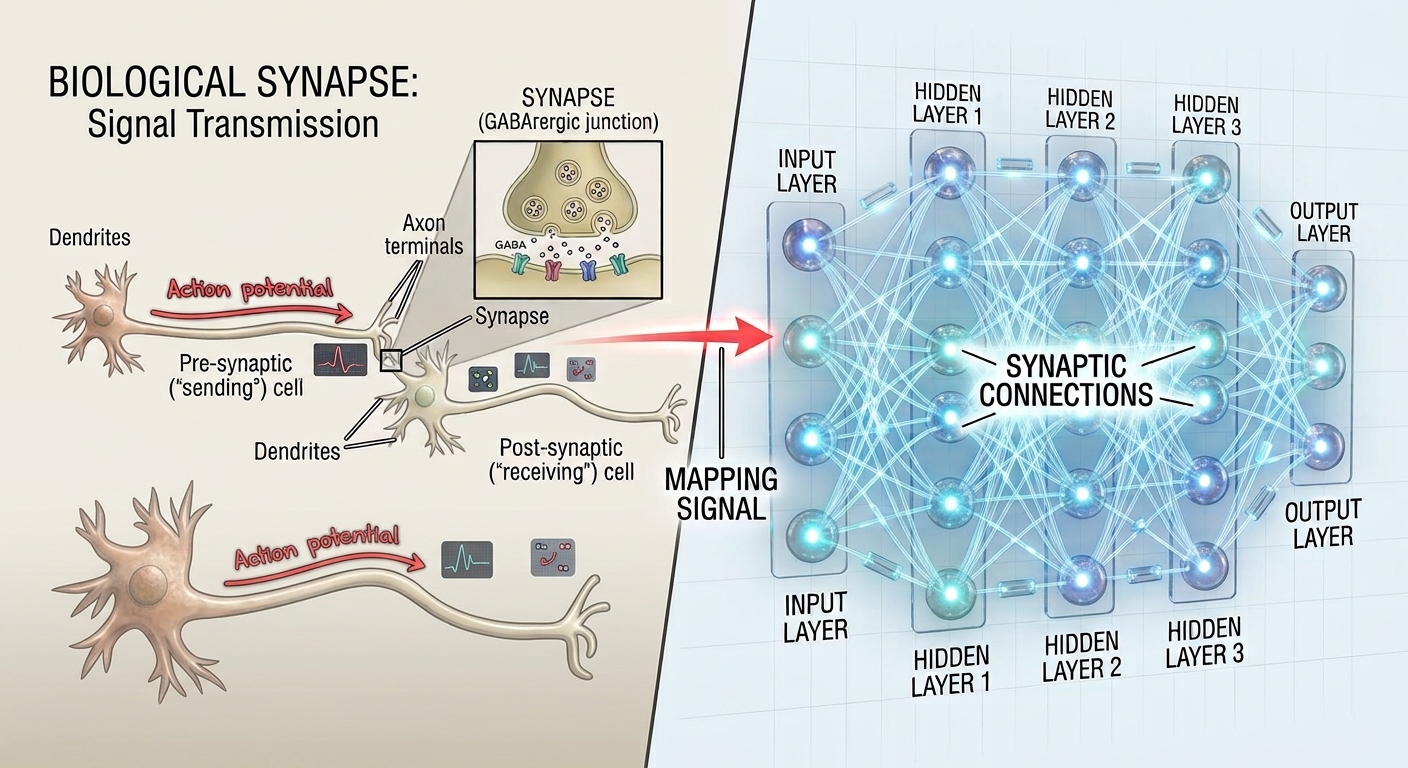 රූපය 3.3: සංජානන ජෛව අනුකරණය — මිනිස් මොළයේ නියුරෝන සහ සයිනැප්ස් ක්රියාකාරිත්වය කෘත්රිම ස්නායුක ජාල (Artificial Neural Network) සමග 1:1 ඉංජිනේරුමය වශයෙන් සමාන්තර වීම.
ජීව විද්යාත්මක මොළය සහ කෘත්රිම ස්නායුක ජාලය (LLM) අතර 1:1 ඉංජිනේරුමය සමාන්තරය:
| ජීව විද්යාත්මක මොළය (Biological Brain) | කෘත්රිම ස්නායුක ජාලය / LLM (Artificial Neural Network) | ඉංජිනේරුමය කාර්යභාරය (Function) |
|---|---|---|
| නියුරෝනය (Neuron) | කෘත්රිම නෝඩය (Node / Artificial Neuron) | තොරතුරු හෝ සංඛ්යාත්මක අගයන් සකසන මූලික ඒකකය |
| ඩෙන්ඩ්රයිට (Dendrites) | ආදාන දෛශික (Input Vectors / Weights) | පෙර ස්ථරවලින් සංඥා ලබා ගන්නා ආදාන මාවත් |
| ඇක්සෝනය (Axon) | සක්රියන ශ්රිතය (Activation Function - ReLU/GELU) | සැකසූ තොරතුරු ඊළඟ ස්ථරයට යවන සංඥා නාලිකාව |
| සයිනැප්ස් (Synapse) | භාර / පරාමිතීන් (Weights & Biases / Parameters) | නියුරෝන අතර සම්බන්ධතාවයේ ප්රබලතාව තීරණය කරන අගයන් |
| ස්නායු ප්ලාස්ටික්තාව (Neuroplasticity) | පසුපසට ප්රචාරණය (Backpropagation & Gradient Descent) | වැරදිවලින් ඉගෙන ගනිමින් පරාමිතීන් යාවත්කාලීන කිරීමේ හැකියාව |
පරිණාමීය ප්රශස්තකරණය සහ තීරණාත්මක සීමා රේඛාව (The Evolutionary Boundary)
මිනිස් මොළය යනු වසර මිලියන සිය ගණනක ස්වභාවික පරිණාමයේ ප්රතිඵලයක් ලෙස බිහිවූ විශිෂ්ටතම බලශක්ති කාර්යක්ෂම පරිගණකයයි. සාමාන්ය මිනිස් මොළයක නියුරෝන බිලියන 86ක් සහ සයිනැප්ස් සම්බන්ධතා ට්රිලියන 100කට අධික ප්රමාණයක් පවතී. නමුත් ඒ සියල්ල ක්රියාත්මක වීමට වැය වන්නේ වොට් 20ක (කුඩා විදුලි බල්බයකට සමාන) විදුලි බලයක් පමණි!
නමුත් අද ලෝකයේ පවතින සුපිරි AI ආකෘති ක්රියාත්මක කිරීමට මෙගාවොට් සිය ගණනක දැවැන්ත විදුලිබලයක් අවශ්ය වේ. මෙයින් අපට පසක් වන එක් මූලික සත්යයක් ඇත: * කෘත්රිම බුද්ධිය යනු මිනිස් මොළයේ ක්රියාකාරිත්වය ඒ අයුරින්ම පිටපත් කිරීමක් නොවේ. * එය හුදෙක් මිනිස් මොළයේ සංඛ්යානමය සහ රටා හඳුනාගැනීමේ මූලධර්ම පමණක් පරිගණකයට උකහා ගැනීමකි. * එබැවින්, AI සතුව හෘද සාක්ෂියක්, චිත්තවේග, සැබෑ ජීව විද්යාත්මක අවබෝධයක් හෝ සදාචාරාත්මක වගකීමක් නොමැත. එය තනිකරම ගණිතමය යන්ත්රයකි.
LLM ආකෘතියක් සැබවින්ම ගොඩනැගෙන්නේ කෙසේද?
මහා පරිමාණ භාෂා ආකෘතියක් ගොඩනැගෙන්නේ අදියර තුනක දැවැන්ත ඉංජිනේරු ක්රියාවලියකිනි:
- පූර්ව පුහුණුව (Pre-training): ලොව පුරා ඇති ට්රිලියන ගණනක් වූ ඩිජිටල් පොත්පත්, වෙබ් අඩවි, විකිපීඩියා ලිපි සහ කේත කියවා භාෂාවේ ව්යාකරණ, රටා සහ ලෝකය පිළිබඳ දැනුම ලබා ගැනීම. (මෙය සිදු කිරීමට ඩොලර් මිලියන සිය ගණනක් සහ මාස ගණනක GPU ධාවන කාලයක් වැය වේ).
- විශේෂඥ සුසර කිරීම (Supervised Fine-Tuning - SFT): ප්රශ්න සහ නිවැරදි පිළිතුරු සහිත විශේෂිත දත්ත කට්ටල මගින් ආකෘතිය සංවාදශීලී සහායකයෙකු බවට පත් කිරීම.
- මානව ප්රතිපෝෂණ මත පදනම් වූ ශක්තිමත් කිරීමේ ඉගෙනුම (RLHF): මිනිස් විශේෂඥයන් විසින් ආකෘතියේ පිළිතුරු ශ්රේණිගත කර, එය ආරක්ෂිත, සදාචාරාත්මක, සහ වගකීම් සහගත ලෙස පිළිතුරු දීමට හැඩගැස්වීම.
Transformer මොළය තුළ සැබවින්ම පවතින්නේ කුමක්ද?
බොහෝ දෙනෙකු අසන ප්රශ්නයක් නම්: "මේ ආකෘතිවල මොළය ක්රියාත්මක වන්නේ කෙසේද?" යන්නයි. මෙහි මොළය වන්නේ බහු ස්ථර ට්රාන්ස්ෆෝමර් පද්ධති නිර්මාණයයි (Multi-layer Transformer Architecture).
ඔබ ශ්රී ලංකාවේ උසස් පෙළ (A/L) සංයුක්ත ගණිතය (Combined Mathematics) හදාරන දරුවෙකුගෙන් විමසුවහොත්, ඔවුන් ඉගෙන ගන්නා න්යාස (Matrices) සහ දෛශික (Vectors) සැබෑ ලෝකයේ ප්රායෝගිකව යොදාගන්නේ කොතැනදැයි බොහෝ විට ඔවුන් නොදන්නවා විය හැක. නමුත් අද මුළු ලෝකයම හොල්ලන කෘත්රිම බුද්ධිය ක්රියාත්මක වන්නේ හරියටම ඒ ගණිතමය මූලධර්ම මතය!
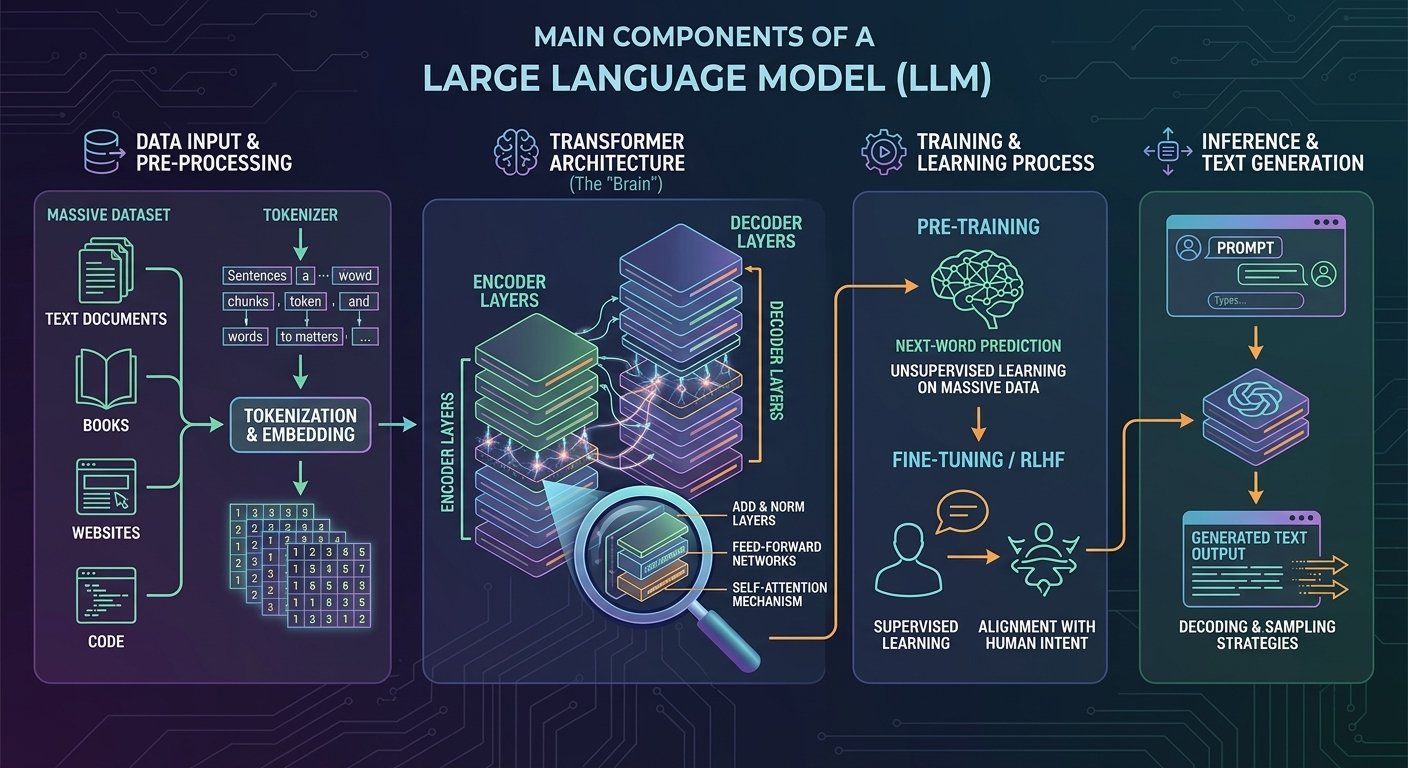 රූපය 3.4: මහා පරිමාණ භාෂා ආකෘතියක (LLM) මූලික පද්ධති නිර්මාණ සැලැස්ම — දැවැන්ත දත්ත සමුදාය, ටෝකනීකරණය සහ එම්බෙඩින්, ට්රාන්ස්ෆෝමර් මොළය, පුහුණු ක්රියාවලිය (Pre-training & RLHF) සහ අනුමාන ප්රතිදානය (Inference).
පළමු අදියර: දැවැන්ත දත්ත සමුදාය (The Massive Dataset)
ඩිජිටල්කරණය කළ පොත්පත්, විශ්වකෝෂ, පරිපාලන ලේඛන, විවෘත අන්තර්ජාල වෙබ් අඩවි සහ පරිගණක කේත මෙයට අමුද්රව්ය ලෙස යොදා ගැනේ. මෙම අතිවිශාල දත්ත පිරිසිදු කර (Deduplication & Quality Filtering), අසත්ය හෝ විෂ සහිත අන්තර්ගත ඉවත් කර ආකෘතිය වෙත යොමු කෙරේ.
දෙවන අදියර: ටෝකනීකරණය සහ එම්බෙඩින්ග් (Tokenization & Embedding)
පෙළ දත්ත කුඩා අක්ෂර ඛණ්ඩ හෙවත් ටෝකන (Tokens) බවට කඩා දැමීම මෙහිදී සිදු වේ. අනතුරුව දෛශික එම්බෙඩින් (Vector Embedding) මගින් සෑම ටෝකනයකටම මානයන් දහස් ගණනක් ඇති බහුමාන ගණිතමය අවකාශයක ඛණ්ඩාංක ලබා දේ. අර්ථයෙන් සමාන වචන ("ප්රවේගය" සහ "වේගය") මෙම අවකාශයේ ඉතා සමීපව ස්ථානගත වේ.
තුන්වන අදියර: Transformer පද්ධති නිර්මාණ සැලැස්ම (The Transformer Architecture)
ස්වයං-අවධානය (Self-Attention Mechanism) හරහා වාක්යයක එක් වචනයක් අනෙක් සියලුම වචන සමග දක්වන සන්දර්භගත සම්බන්ධය ගණනය කෙරේ. සංකේතක සහ විකේතක ස්ථර (Encoder & Decoder Layers), එකතු කිරීම් සහ ප්රමිතිකරණ ස්ථර (Add & Norm Layers), සහ ඉදිරියට-පෝෂණය වන ස්නායුක ජාල (Feed-Forward Networks) ඔස්සේ තොරතුරු ස්ථායීව සකසනු ලබයි.
හතරවන අදියර: පුහුණු කිරීම සහ ඉගෙනීම (Training & Learning)
පූර්ව පුහුණුවේදී ට්රිලියන ගණනක් වචන කියවමින්, "ඊළඟ වචනය කුමක්දැයි" අනුමාන කිරීම (Next-Word Prediction) මගින් භාෂාවේ ව්යාකරණ සහ තර්කනය ග්රහණය කරගනී. අනතුරුව මානව ප්රතිපෝෂණ මගින් සුසර කිරීම (RLHF) හරහා සමාජයට උචිත, ආරක්ෂිත, විනීත සහ සත්යවාදී පිළිතුරු දීමට ආකෘතිය හැඩගස්වනු ලබයි.
පස්වන අදියර: අනුමානය සහ උත්පාදනය (Inference & Generation)
පරිශීලකයා විසින් දෙන ලද විමසුම (Prompt) මත පදනම්ව, ගණිතමය සම්භාවිතා උපායමාර්ග (Decoding & Sampling Strategies — Temperature, Top-p) භාවිත කරමින් වඩාත්ම සුදුසු ප්රතිදානය (Generated Text Output) ක්ෂණිකව උත්පාදනය කෙරේ.
AI ආකෘතියක් ඉගෙනුම ලබන්නේ කෙසේද?
ආකෘතියක් ඉගෙන ගන්නේ අප පාසැලේදී ඉගෙන ගන්නා ආකාරයට නොවේ. එය ඉගෙන ගන්නේ ඊළඟ වචනය අනුමාන කිරීම (Next-Token Prediction) මගිනි:
"ශ්රී ලංකාවේ අගනුවර වන්නේ ශ්රී ජයවර්ධනපුර..." යැයි දුන් විට, ඊළඟට පැමිණිය යුතු වචනය "කෝට්ටේ" වීමේ සම්භාවිතාව 99.8% ක් බව එය ගණිතමය වශයෙන් හඳුනා ගනී.
ආකෘතිය වැරදි අනුමානයක් කළ විට, එහි වූ දෝෂය (Loss Function) මැන බලා, පසුපසට ප්රචාරණය (Backpropagation) නම් ගණිතමය ක්රමවේදය ඔස්සේ ආකෘතියේ බර (Weights) සකස් කරමින් ස්වයංව නිවැරදි කර ගනී. ට්රිලියන ගණනක් වාර මෙම ක්රියාවලිය සිදු වන විට, භාෂාවේ නීතිරීති සහ සංකල්ප ආකෘතිය තුළ තැන්පත් වේ.
LLM යනු සත්යයේ එන්ජිමක් නොව සම්භාවිතා එන්ජිමක් වන්නේ ඇයි?
ඔබ ශිෂ්යයෙකු, ගුරුවරයෙකු, දෙමාපියෙකු හෝ වෘත්තිකයෙකු වුවද, තේරුම් ගත යුතු අතිශය තීරණාත්මක පාඩම මෙයයි: * LLM යනු දත්ත සමුදායක් (Database) නොවේ. එය තොරතුරු ගබඩා කරගෙන නැත. * LLM යනු සත්යය දන්නා සත්යයේ එන්ජිමක් (Truth Engine) නොවේ. * එය පිරිසිදු සම්භාවිතා එන්ජිමකි (Plausibility / Probability Engine).
එහි කාර්යය වන්නේ ඔබ අසන ප්රශ්නයට වඩාත්ම ගැළපෙන, කියවීමට ප්රිය උපදවන, භාෂාමය වශයෙන් සුමටම පිළිතුර ගොඩනැගීමයි. එහිදී එය සත්යය නොදන්නේ නම්, අතිශය විශ්වාසනීය මුහුණුවරකින් සම්පූර්ණ අසත්ය කරුණු පවා ගොතා ඉදිරිපත් කළ හැක. මෙය AI ක්ෂේත්රයේ මුළාවීම් හෙවත් ප්රවාද (Hallucinations) ලෙස හැඳින්වේ.
එබැවින්, ඕනෑම වැදගත් තීරණයක් ගැනීමේදී, AI ලබා දෙන තොරතුරු නැවත සත්යාපනය කිරීමේ (Verification) වගකීම 100% ක්ම එය භාවිත කරන මිනිසා සතු වේ!
සිංහල සහ දෙමළ භාෂාවලදී ආකෘතිවල ප්රතිඵල වෙනස් වන්නේ ඇයි?
බොහෝ දෙනෙකු අත්විඳින ගැටලුවක් නම්: ඉංග්රීසියෙන් ඉතා දක්ෂ ලෙස ක්රියාත්මක වන ChatGPT හෝ Gemini, සිංහලෙන් හෝ දෙමළෙන් ප්රශ්න ඇසූ විට සමහර විට වැරදි හෝ විකාරරූපී පිළිතුරු ලබා දීමයි. මෙයට හේතු සතරක් ඇත:
බටහිර දැනුමේ පක්ෂග්රාහීත්වය (Western Knowledge Bias)
ලෝකයේ ප්රමුඛතම LLM පුහුණු කිරීම සඳහා යොදාගත් අන්තර්ජාල දත්තවලින් 85% කට වඩා ඇත්තේ ඉංග්රීසි භාෂාවෙනි. බටහිර ලෝකයේ ඉතිහාසය, නීතිය සහ සංස්කෘතිය මෙම ආකෘති තුළ ගැඹුරින් තැන්පත්ව ඇති මුත්, ශ්රී ලංකාවේ සංස්කෘතිය, අපේ පාසල් විෂය නිර්දේශය හෝ දේශීය කරුණු පිළිබඳ ඒවායේ ඇති දැනුම සාපේක්ෂව අඩුය.
Google Gemini හි සිංහල භාෂා වාසිය (Google Gemini's Sinhala Advantage)
Google සමාගම වසර ගණනාවක් පුරා Google Translate සහ Android පද්ධති හරහා සිංහල සහ දෙමළ දත්ත එක්රැස් කර ඇති බැවින්, දේශීය භාෂා හැසිරවීමේදී Gemini ආකෘතිය බොහෝ විට ChatGPT (OpenAI) ට වඩා ඉහළ නිරවද්යතාවක් සහ ස්වභාවික භාෂා විලාසයක් ප්රදර්ශනය කරයි.
චීනයේ DeepSeek ආකෘතියේ විස්මය (The Surprise of China's DeepSeek)
චීනයෙන් බිහිවූ DeepSeek-R1 ආකෘතිය විවෘත මූලාශ්රයක් (Open Source) ලෙස අඩු පිරිවැයකින් ලබාගත හැකි අතර, තර්කන ශක්තිය අතින් එය OpenAI හි o1 ආකෘතියට සමාන මට්ටමක පවතී. නමුත් භාෂාමය වශයෙන් සිංහල සහ දෙමළ හැසිරවීමේදී එය තවමත් මුල් අදියරේ පසුවේ.
සිංහලට වඩා දෙමළ භාෂාව සාර්ථක වීමට හේතුව (Why Tamil Fares Better than Sinhala)
ශ්රී ලංකාවේ දෙමළ භාෂාව කතා කරන්නන්ට AI මෙවලම් භාවිතය සාපේක්ෂව පහසුය. මන්ද, ඉන්දියාවේ තමිල්නාඩුව ඇතුළු ලොව පුරා කෝටි ගණනක් දෙමළ ජනතාව විසින් අන්තර්ජාලයට එක්කර ඇති අතිවිශාල දෙමළ සාහිත්යයක් සහ ඩිජිටල් දත්ත පද්ධතියක් පවතින බැවිනි. නමුත් සිංහල භාෂාව කතා කරන්නේ ලෝකයේ අපේ රටේ කෝටි දෙකකට ආසන්න ජනතාව පමණි. අප අන්තර්ජාලයට එක්කර ඇති ඩිජිටල් සිංහල අන්තර්ගතය ඉතා සීමිතය. එබැවින් සිංහල භාෂාවෙන් AI භාවිත කිරීමේදී අප විශේෂයෙන් විමසිලිමත් විය යුතුය.
බහු-ආකෘතික AI (Multimodal AI) යන්නෙහි සැබෑ අරුත කුමක්ද?
අද වන විට මෙම ආකෘති හුදු පෙළ (Text) වලට පමණක් සීමා වී නොමැත. නවීන Frontier ආකෘති ක්රියාත්මක වන්නේ පූර්ණ බහු-මාදිලි (Multimodal) පද්ධති වශයෙනි.
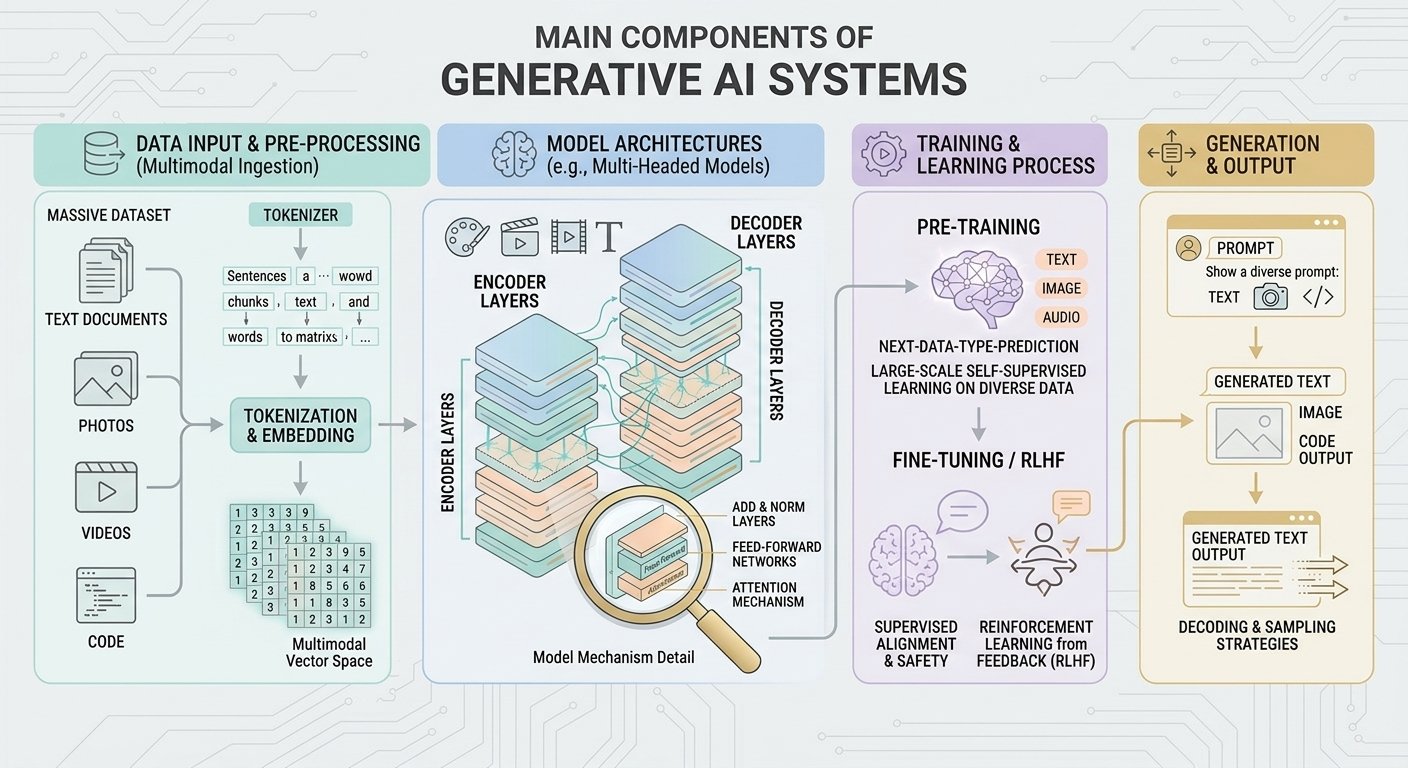 රූපය 3.5: බහු-ආකෘතික උත්පාදක AI පද්ධතියක පද්ධති නිර්මාණ සැලැස්ම — බහු-මාදිලි දත්ත ආදානය, ඒකාබද්ධ බහුමාන දෛශික අවකාශය, බහු-ශීර්ෂ ට්රාන්ස්ෆෝමරය සහ බහු-මාදිලි ප්රතිදානය.
පෙළ බාධකයකින් තොරව සෘජු ආදානය (Ingestion Without a Text Bottleneck)
පැරණි ක්රමයේදී මෙන් රූපයක් දුටු විට එය අකුරුවලට පෙරළන්නේ නැත. ඡායාරූප සහ වීඩියෝ රාමු කුඩා පික්සල් කොටු (16x16 Patches) ලෙස කඩා දෘශ්ය ටෝකන බවටද, ශ්රව්ය තරංග සංඛ්යාත වර්ණාවලි (Spectrograms) හරහා ශ්රව්ය ටෝකන බවටද සෘජුව පරිවර්තනය කරයි.
ඒකාබද්ධ දෛශික අවකාශය (The Unified Vector Space)
මෙය සමස්ත පද්ධතියේ විශිෂ්ටතම ඉංජිනේරු ජයග්රහණයයි! ශ්රී ලංකා ජාතික හැඳුනුම්පතක ඡායාරූපය, සිංහලෙන් කියන "ජාතික හැඳුනුම්පත" යන හඬපටය, සහ ඉංග්රීසියෙන් ලියූ "National Identity Card" යන පෙළ යන සියල්ලම මෙම බහුමාන ගණිතමය අවකාශයේ ස්ථානගත වන්නේ එකම ඛණ්ඩාංක කලාපයකය. එමගින් යන්ත්රයට මාදිලි අතර බාධාවකින් තොරව සංසන්දනය කිරීමේ හැකියාව ලැබේ.
විවිධ මාධ්ය අතර හරස් අවධානය (Cross-Attention Between Modalities)
විවිධ මාධ්ය අතර හරස්-අවධානය (Cross-Attention) ක්රියාත්මක වේ. නිදසුනක් ලෙස, පරිලෝකනය කළ ඔප්පුවක ඇති අත්සන දෙස බලන අතරතුරම, එහි ලියා ඇති ඉඩම් හිමිකරුගේ නම පෙළ සමග සසඳා බැලීමට ආකෘතියට හැකියාව ලැබේ.
බහු-ආකෘතික පුහුණුව සහ ආරක්ෂණ පෙළගැස්ම (Multimodal Training & Safety Alignment)
ඊළඟ දත්ත වර්ගය අනුමාන කිරීම ඔස්සේ වීඩියෝ, ශබ්ද සහ පෙළ මිශ්ර දත්ත මත පුහුණු වීම සහ ආරක්ෂිත මාර්ගෝපදේශ හා ව්යාජ නිර්මාණ (Deepfakes) වැළැක්වීමේ ආරක්ෂිත පෙරහන් මෙහිදී ක්රියාත්මක වේ.
ඕනෑම මාධ්යයකින් ප්රතිදාන උත්පාදනය (Generation in Any Medium)
පරිශීලකයාට ඕනෑම මාධ්යයකින් විමසුමක් ලබා දිය හැක (උදා: පැමිණිල්ලක හඬපටයක් + ආපදා ඡායාරූපයක්). පද්ධතිය විසින් සම්භාවිතා උපායමාර්ග ඔස්සේ සිංහල නිල වාර්තාවක්, හානිය ලකුණු කළ සිතියමක්, හෝ විසඳුම් කේතයක් ක්ෂණිකව උත්පාදනය කර ලබා දෙයි.
මෙමගින් ඔබට ලැබෙන ප්රායෝගික වටිනාකම
- අතින් ලියන ලද පැරණි ලිපියක හෝ වාර්තාවක ඡායාරූපයක් ඇතුළත් කර එහි අන්තර්ගතය තත්පරයකින් කියවා ගැනීම (Vision OCR).
- ශිෂ්යයෙකුගේ අත් අකුරින් ලියූ පිළිතුරු පත්රයක් ඡායාරූපගත කර, ක්රමයට ලැබෙන ලකුණු සහ නිවැරදිතාවට ලැබෙන ලකුණු වෙන වෙනම විශ්ලේෂණය කරවා ගැනීම.
- හමුවකදී දෙමාපියෙකු ඉදිරිපත් කරන ගැටලුවක හඬපටයක් ඇතුළත් කර, ඔවුන් කාමරයෙන් පිටවීමට පෙර පසු විපරම් සටහනක් සකස් කිරීම.
- පරිච්ඡේදයක ඇති රූප සටහනක් හෝ ප්රස්ථාරයක් විග්රහ කර එහි නොගැළපීම් හඳුනා ගැනීම.
මීළඟ මොඩියුලයේදී, මෙම ස්වභාවික භාෂා විප්ලවය හේතුවෙන් මානව ශාස්ත්ර නැවත කරලියට පැමිණෙන්නේ කෙසේද, සහ සාමාන්ය පුරවැසියා මුහුණ දෙන ඩිජිටල් පරතරය AI මගින් පියවන්නේ කෙසේද යන්න සාකච්ඡා කරමු.