பிற மொழிகளில்: English · සිංහල
CM-02: பெரிய மொழி மாதிரிகள் (LLMs), நரம்பியல் நெட்வொர்க்குகள் மற்றும் அறிவாற்றல் உயிரியல் போலாக்கம்
வெளியிடப்பட்டது 2026-09-14
பலர் பெரிய மொழி மாதிரிகளை (LLMs) ஒரு மாயாஜாலமாகப் பார்க்கிறார்கள். ஆனால் அதற்குப் பின்னால் இருப்பது மனித மூளையின் செயல்பாட்டை முன்மாதிரியாகக் கொண்டு கட்டமைக்கப்பட்ட நரம்பியல் நெட்வொர்க்குகள், உயர்தர ஒருங்கிணைந்த கணிதத்தின் அணிகோவைகள் (Matrices) மற்றும் திசையன்கள் (Vectors), மற்றும் பில்லியன் கணக்கான புள்ளியியல் சாத்தியக்கூறுகளின் கலவையாகும்.
AI, ஆக்கபூர்வ AI, LLM மற்றும் GPT ஆகியவற்றிற்கு இடையிலான வேறுபாடு யாது?
பலராலும் அடிக்கடி பயன்படுத்தப்படும் இந்த நான்கு சொற்களுக்கு இடையிலான சரியான உறவைப் புரிந்து கொள்வது மிகவும் அவசியமானது. இதனை ஒன்றுக்குள் ஒன்றாக அடங்கும் நான்கு மைய வட்டங்களாகக் (Taxonomy of AI) குறிப்பிடலாம்:
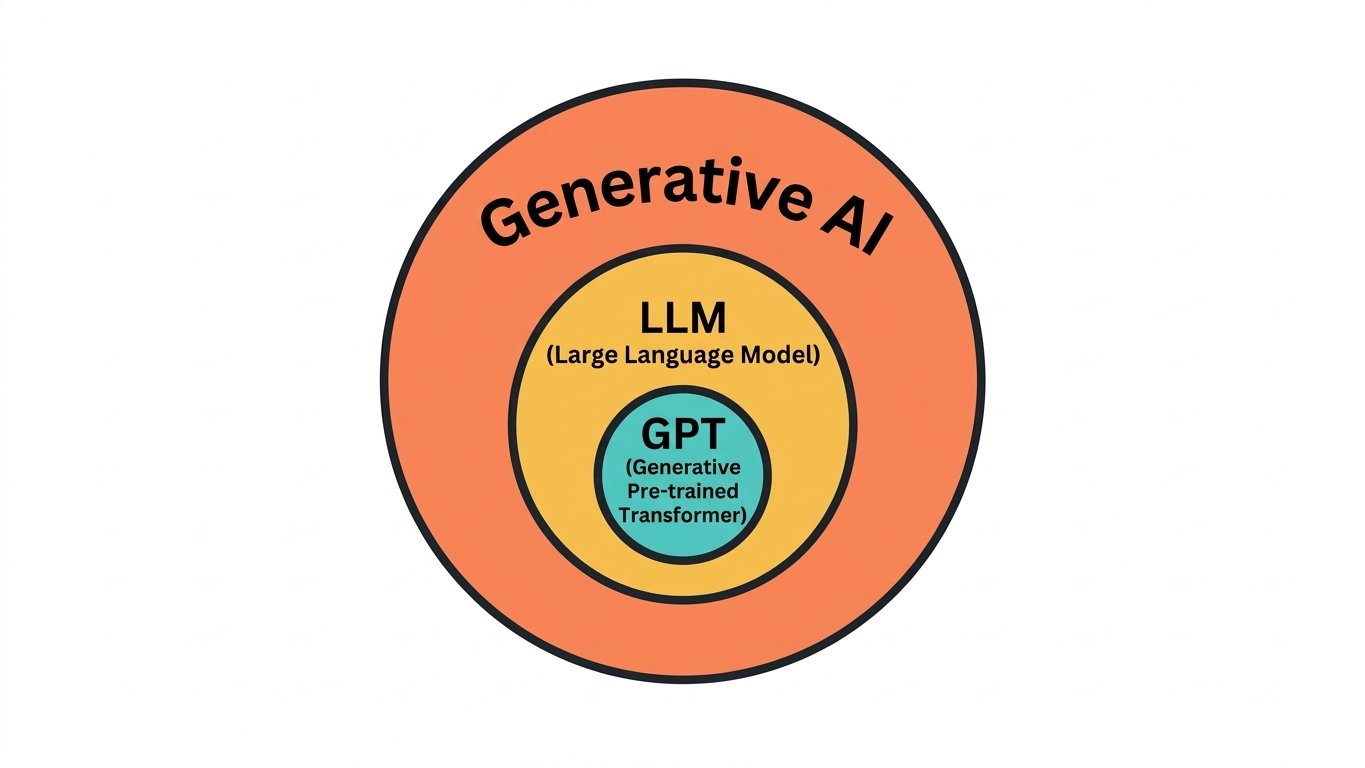 படம் 3.1: AI, Generative AI, LLMs மற்றும் GPT ஆகியவற்றுக்கு இடையிலான படிநிலைத் தொடர்பு.
- செயற்கை நுண்ணறிவு (Artificial Intelligence - AI): மனித நுண்ணறிவைக் கணினி மென்பொருள் மற்றும் வன்பொருளால் பிரதிபலிக்கும் ஒட்டுமொத்தப் பரந்த களம் (1950 முதல் தொடங்கியது).
- ஆக்கபூர்வ செயற்கை நுண்ணறிவு (Generative AI): பாரம்பரிய AI போலன்றி, புதிய உள்ளடக்கத்தை புதிதாக உருவாக்கக்கூடிய (Synthesizing new original content) ஒரு துணைப் பிரிவு.
- பெரிய மொழி மாதிரிகள் (Large Language Models - LLMs): மனித மொழியைப் புரிந்து கொள்ளவும் எழுதவும் பில்லியன் கணக்கான/டிரில்லியன் கணக்கான சொற்களில் முன்கூட்டியே பயிற்சியளிக்கப்பட்ட தனித்துவமான ஆக்கபூர்வ AI மாதிரிகள் (எ.கா: Google Gemini, Meta LLaMA, DeepSeek).
- ஜெனரேட்டிவ் ப்ரீ-ட்ரெயினட் டிரான்ஸ்ஃபார்மர் (Generative Pre-trained Transformer - GPT): OpenAI நிறுவனத்தால் 2018 ஆம் ஆண்டில் டிரான்ஸ்ஃபார்மர் கட்டமைப்பைப் பயன்படுத்தி அறிமுகப்படுத்தப்பட்ட குறிப்பிட்ட வணிகரீதியான LLM வர்த்தகப் பெயர்.
பொறியியலாளர்கள் மனித மூளையின் செயல்பாட்டை முன்மாதிரியாக எடுத்தது ஏன்?
இயற்கை மற்றும் உயிரியலின் படைப்புகளை முன்மாதிரியாகக் கொண்டு மனிதன் பொறியியல் சவால்களைத் தீர்ப்பது உயிரியல் போலாக்கம் (Biomimicry) என்று அழைக்கப்படுகிறது.
ஜப்பானின் ஷிங்கன்சென் (Shinkansen) புல்லட் ரயிலும் மீன்கொத்தியின் பாடமும்
ஜப்பானின் அதிவேக புல்லட் ரயில் (Shinkansen) மணிக்கு 300 கிமீ வேகத்தில் சுரங்கப் பாதைகளிலிருந்து வெளியே வரும் போது, வளிமண்டல அழுத்தத்தின் திடீர் மாற்றத்தால் துப்பாக்கி வெடிப்பது போன்ற பயங்கரமான இரைச்சல் (Tunnel Boom) உருவானது. ஒரு கிலோமீட்டர் தூரத்திற்கு அப்பாலும் கேட்ட இந்த வெடிப்புச் சத்தத்தால் அருகில் இருந்த கிராம மக்களால் தூங்க முடியவில்லை; சுரங்கப் பாதைகளுக்கும் சேதம் ஏற்படும் அபாயம் உருவானது.
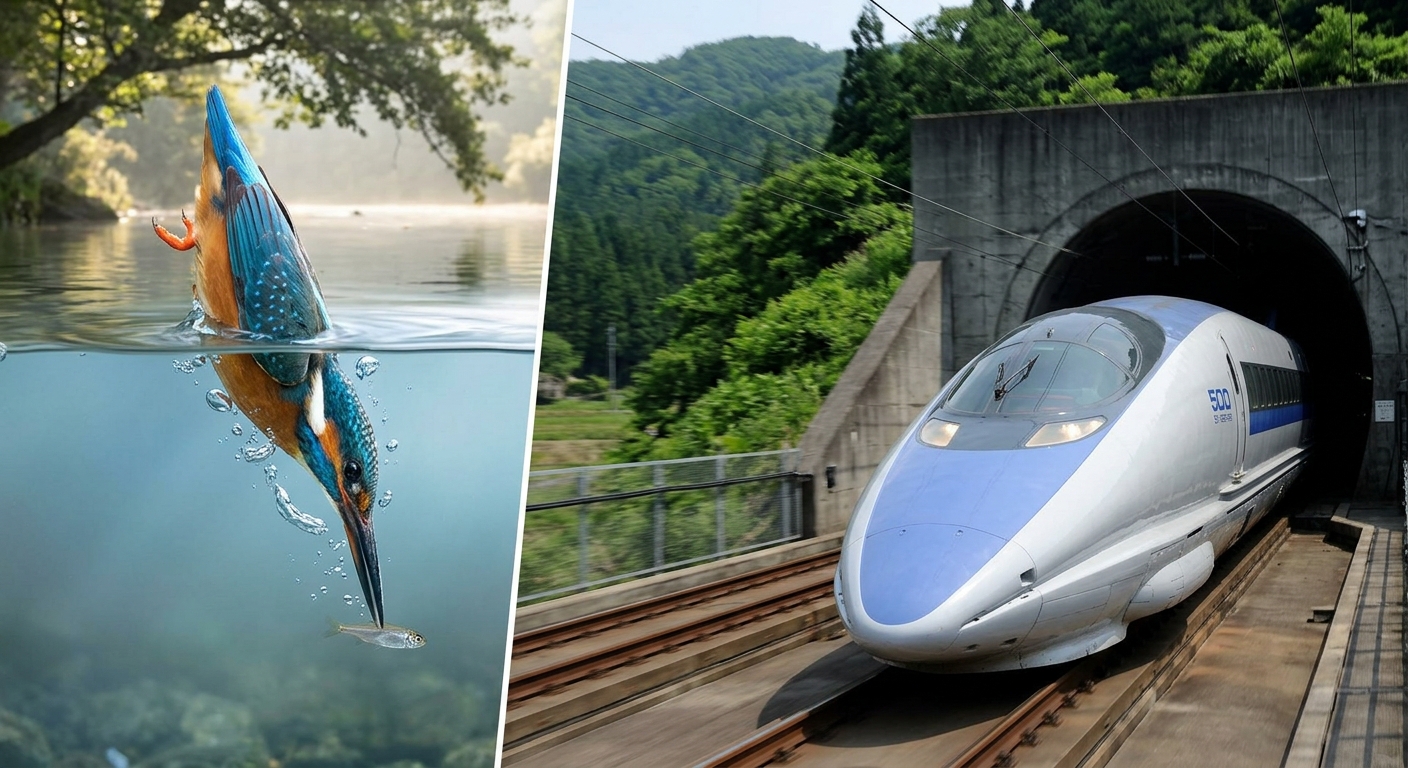 படம் 3.2: எந்திரவியல் உயிரியல் போலாக்கம் — மீன்கொத்தியின் அலகை முன்மாதிரியாகக் கொண்டு ஜப்பானின் Shinkansen புல்லட் ரயிலின் காற்றியக்க வடிவமைப்பை (Aerodynamics) மறுவடிவமைப்பு செய்தல்.
இப்பிரச்சினையைத் தீர்க்க நியமிக்கப்பட்ட தலைமைப் பொறியாளர் ஒரு பறவை பார்வையாளராகவும் (Birdwatcher) இருந்தார். அவர் ஓர் ஆச்சரியமான உண்மையைக் கவனித்தார்: மீன்கொத்திப் பறவை (Kingfisher) காற்றில் இருந்து (குறைந்த அடர்த்தி ஊடகம்) ஒரு துளி நீரும் தெறிக்காமல் அதிவேகமாக தண்ணீருக்குள் (அதிக அடர்த்தி ஊடகம்) எவ்வாறு பாய்கிறது?
மீன்கொத்தியின் அலகு நுனியில் மெலிதாகத் தொடங்கி தலை நோக்கிச் செல்லச் செல்ல தடிமனாகும் ஒரு தனித்துவமான வடிவியல் அமைப்பைக் கொண்டுள்ளது. பொறியியலாளர்கள் புல்லட் ரயிலின் முன்பகுதியை மீன்கொத்தியின் அலகின் வடிவத்திற்கு ஏற்ப முழுமையாக மாற்றியமைத்தனர். அதன் விளைவுகள்: * சுரங்கத்திலிருந்து வெளியே வரும் பெரும் சத்தம் 100% நீங்கியது. * ரயிலின் வேகம் 10% அதிகரித்தது. * மின்சாரப் பயன்பாடு 15% குறைந்தது!
எந்திரவியல் உயிரியல் போலாக்கத்திலிருந்து அறிவாற்றல் உயிரியல் போலாக்கம் வரை: நரம்பியல் நெட்வொர்க்குகள்
மீன்கொத்தியின் அலகை முன்மாதிரியாகக் கொண்டு ரயிலை உருவாக்க முடிந்தால், மனித சிந்தனையையும் அறிவையும் பிரதிபலிக்க மனித மூளையை ஏன் முன்மாதிரியாகக் கொள்ளக்கூடாது என்று கணினி விஞ்ஞானிகள் சிந்தித்தனர். அதிலிருந்து பிறந்தவையே செயற்கை நரம்பியல் நெட்வொர்க்குகள் (Artificial Neural Networks - ANNs) ஆகும்.
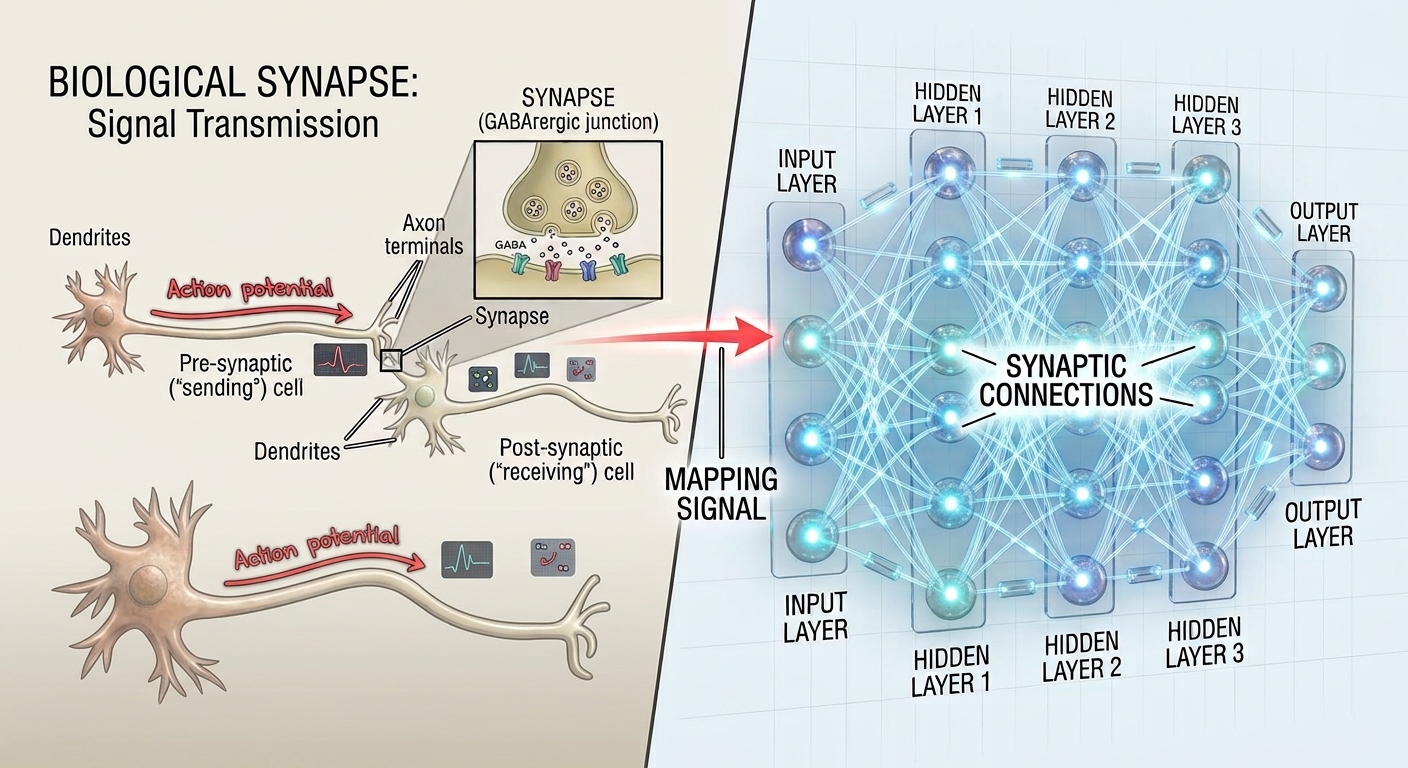 படம் 3.3: அறிவாற்றல் உயிரியல் போலாக்கம் — மனித மூளையின் நியூரான்கள் மற்றும் சினாப்ஸ்களின் செயல்பாடு செயற்கை நரம்பியல் நெட்வொர்க்குடன் (LLM) 1:1 பொறியியல் ரீதியாக இணையாக அமைதல்.
உயிரியல் மூளைக்கும் செயற்கை நரம்பியல் நெட்வொர்க்கிற்கும் (LLM) இடையிலான 1:1 பொறியியல் ஒப்பீடு:
| உயிரியல் மூளை (Biological Brain) | செயற்கை நரம்பியல் நெட்வொர்க் / LLM (Artificial Neural Network) | பொறியியல் செயல்பாடு (Function) |
|---|---|---|
| நியூரான் (Neuron) | செயற்கை முனை (Node / Artificial Neuron) | தகவல்களை அல்லது எண்களைச் செயலாக்கும் அடிப்படை அலகு |
| டென்ட்ரைட்டுகள் (Dendrites) | உள்ளீட்டு திசையன்கள் (Input Vectors / Weights) | முந்தைய அடுக்குகளிலிருந்து சமிக்ஞைகளைப் பெறும் உள்ளீட்டு வழிகள் |
| ஆக்சான் (Axon) | செயல்படுத்தும் செயல்பாடு (Activation Function - ReLU/GELU) | செயலாக்கப்பட்ட தகவலை அடுத்த அடுக்குக்கு அனுப்பும் சேனல் |
| சினாப்ஸ் (Synapse) | எடைகள் / அளவுருக்கள் (Weights & Biases / Parameters) | நியூரான்களுக்கு இடையிலான தொடர்பின் வலிமையைத் தீர்மானிக்கும் மதிப்புகள் |
| நியூரோபிளாஸ்டிசிட்டி (Neuroplasticity) | பின்புறப் பரவல் (Backpropagation & Gradient Descent) | பிழைகளிலிருந்து கற்றுக்கொண்டு அளவுருக்களைப் புதுப்பிக்கும் திறன் |
பரிணாம உகப்பாக்கம் (Evolutionary Optimization) மற்றும் முக்கியமான எல்லைக்கோடு
மனித மூளை என்பது மில்லியன் கணக்கான ஆண்டுகால இயற்கை பரிணாம வளர்ச்சியின் பயனாக உருவான மிகச் சிறந்த ஆற்றல் திறன் வாய்ந்த கணினியாகும். ஒரு சாதாரண மனித மூளையில் 86 பில்லியன் நியூரான்களும் 100 டிரில்லியனுக்கும் அதிகமான சினாப்ஸ் இணைப்புகளும் உள்ளன. ஆனால் இவை அனைத்தும் செயல்படத் தேவைப்படுவது வெறும் 20 வாட்ஸ் (ஒரு சிறிய மின்விளக்கிற்கு இணையான) மின்சாரம் மட்டுமே!
ஆனால் இன்று உலகில் உள்ள சூப்பர் AI மாடல்களை இயக்க மெகாவாட் கணக்கில் பிரம்மாண்டமான மின்சாரம் தேவைப்படுகிறது. இதிலிருந்து நாம் ஒரு முக்கியமான உண்மையை உணர்கிறோம்: * செயற்கை நுண்ணறிவு என்பது மனித மூளையின் செயல்பாட்டை அப்படியே நகலெடுப்பது அல்ல. * இது வெறும் மனித மூளையின் புள்ளியியல் மற்றும் வடிவம் அறிதல் கோட்பாடுகளை மட்டுமே கணினிக்குள் புகுத்தியுள்ளது. * எனவே, AI-க்கு மனசாட்சி, உணர்ச்சிகள், உண்மையான உயிரியல் புரிதல் அல்லது தார்மீகப் பொறுப்புணர்வு கிடையாது. அது முற்றிலும் ஒரு கணித இயந்திரம் மட்டுமே.
ஒரு LLM உண்மையில் எவ்வாறு கட்டியெழுப்பப்படுகிறது?
ஒரு பெரிய மொழி மாதிரி மூன்று முக்கியப் பொறியியல் கட்டங்களில் உருவாக்கப்படுகிறது:
- முன்-பயிற்சி (Pre-training): உலகெங்கிலும் உள்ள டிரில்லியன் கணக்கான டிஜிட்டல் புத்தகங்கள், வலைத்தளங்கள், விக்கிபீடியா கட்டுரைகள் மற்றும் குறியீடுகளைப் படித்து மொழியின் இலக்கணம், வடிவங்கள் மற்றும் உலக அறிவைப் பெறுதல். (இதைச் செய்ய நூற்றுக்கணக்கான மில்லியன் டாலர்களும் பல மாத கால GPU இயக்க நேரமும் செலவாகிறது).
- மேற்பார்வையிடப்பட்ட நுண்ணிய சரிசெய்தல் (Supervised Fine-Tuning - SFT): கேள்விகள் மற்றும் சரியான பதில்களைக் கொண்ட பிரத்யேகத் தரவுத்தொகுப்புகள் மூலம் மாதிரியை ஓர் உரையாடல் உதவியாளராக மாற்றுதல்.
- மனிதக் கருத்துகளின் அடிப்படையிலான வலுவூட்டல் கற்றல் (RLHF): மனித வல்லுநர்கள் மாதிரியின் பதில்களைத் தரவரிசைப்படுத்தி, அது பாதுகாப்பான, தார்மீக மற்றும் பொறுப்பான பதில்களை வழங்குமாறு வழிநடத்துதல்.
டிரான்ஸ்ஃபார்மர் மூளையின் உள்ளே உண்மையில் இருப்பது என்ன?
பலர் கேட்கும் ஒரு கேள்வி: "இந்த மாதிரிகளின் மூளை எவ்வாறு செயல்படுகிறது?" என்பதாகும். இதன் மூளை என்பது பல்-அடுக்கு டிரான்ஸ்ஃபார்மர் கட்டமைப்பு (Multi-layer Transformer Architecture) ஆகும்.
உயர்தர ஒருங்கிணைந்த கணிதம் (Combined Mathematics) கற்கும் ஒரு மாணவரிடம் கேட்டால், அவர்கள் கற்கும் அணிகோவைகள் (Matrices) மற்றும் திசையன்கள் (Vectors) நிஜ உலகில் எங்கு பயன்படுகின்றன என்பது பெரும்பாலும் அவர்களுக்குத் தெரியாது. ஆனால் இன்று உலகையே வியப்பில் ஆழ்த்தும் செயற்கை நுண்ணறிவு துல்லியமாக அந்த கணிதக் கோட்பாடுகளின் அடிப்படையில்தான் செயல்படுகிறது!
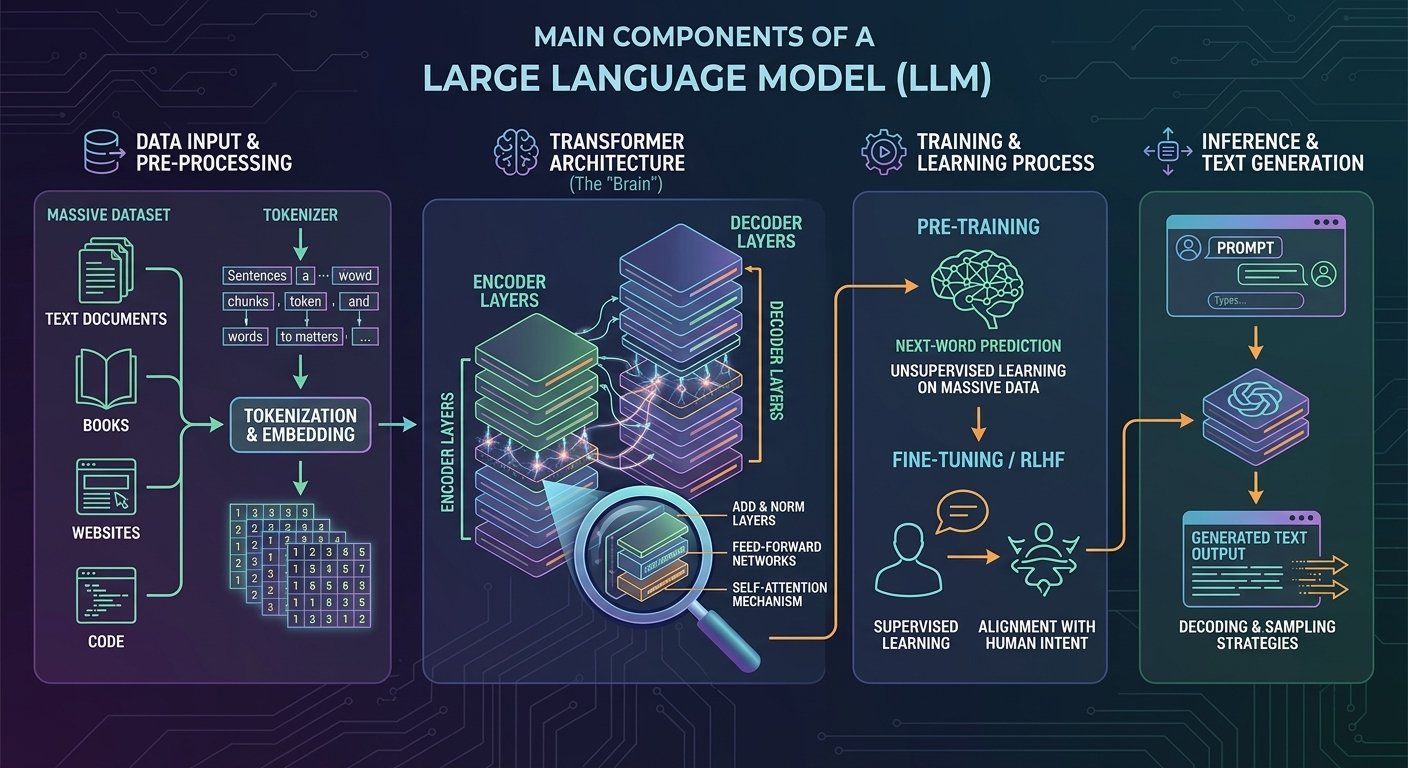 படம் 3.4: ஒரு பெரிய மொழி மாதிரியின் (LLM) அடிப்படைக் கட்டமைப்பு — பிரம்மாண்டமான தரவுத்தொகுப்பு, டோக்கனாக்கம் மற்றும் உட்பொதித்தல், டிரான்ஸ்ஃபார்மர் மூளை, பயிற்சி செயல்முறை (Pre-training & RLHF) மற்றும் அனுமான வெளியீடு (Inference).
முதல் படி: பிரம்மாண்டமான தரவுத்தொகுப்பு (The Massive Dataset)
டிஜிட்டல் மயமாக்கப்பட்ட புத்தகங்கள், கலைக்களஞ்சியங்கள், நிர்வாக ஆவணங்கள், திறந்த இணையதளங்கள் மற்றும் கணினிக் குறியீடுகள் இதற்கு மூலப்பொருட்களாகப் பயன்படுத்தப்படுகின்றன. இந்த பிரம்மாண்டமான தரவு நகல் நீக்கப்பட்டு (Deduplication & Quality Filtering), தவறான அல்லது நச்சுத் தன்மையுடைய தகவல்கள் களையப்பட்டு மாதிரிக்கு ஊட்டப்படுகிறது.
இரண்டாம் படி: டோக்கனாக்கம் மற்றும் உட்பொதித்தல் (Tokenization & Embedding)
உரைத் தரவு சிறிய எழுத்துத் துண்டுகளாக அல்லது டோக்கன்களாகப் (Tokens) பிரிக்கப்படுகிறது. பின்னர் திசையன் உட்பொதித்தல் (Vector Embedding) மூலம் ஒவ்வொரு டோக்கனுக்கும் பல்லாயிரக்கணக்கான பரிமாணங்களைக் கொண்ட கணித வெளியில் ஆயத்தொலைவுகள் (coordinates) ஒதுக்கப்படுகின்றன. ஒரே அர்த்தம் கொண்ட சொற்கள் ("வேகம்" மற்றும் "கதி") இந்த வெளியில் மிக நெருக்கமாக அமைகின்றன.
மூன்றாம் படி: டிரான்ஸ்ஃபார்மர் கட்டமைப்பு (The Transformer Architecture)
சுய-கவனம் (Self-Attention Mechanism) மூலம் வாக்கியத்தில் உள்ள ஒரு சொல் மற்ற அனைத்துச் சொற்களுடனும் கொண்டுள்ள சூழல்சார் தொடர்பைக் கணக்கிடுகிறது. குறியாக்கி மற்றும் குறிவிலக்கி அடுக்குகள் (Encoder & Decoder Layers), கூட்டல் மற்றும் இயல்பாக்க அடுக்குகள் (Add & Norm Layers) மற்றும் முன்னோக்கிச் செலுத்தும் நரம்பியல் நெட்வொர்க்குகள் (Feed-Forward Networks) மூலம் தகவல்கள் நிலையாகச் செயலாக்கப்படுகின்றன.
நான்காம் படி: பயிற்சி மற்றும் கற்றல் (Training & Learning)
முன்-பயிற்சியில் டிரில்லியன் கணக்கான சொற்களைப் படித்து, "அடுத்த சொல் என்ன" என்பதை கணிப்பதன் (Next-Word Prediction) மூலம் மொழியின் இலக்கணம் மற்றும் தர்க்கத்தை உள்வாங்குகிறது. பின்னர் மனிதக் கருத்துகள் மூலம் சரிசெய்தல் (RLHF) வழியாக சமுதாயத்திற்கு உகந்த, பாதுகாப்பான மற்றும் உண்மையான பதில்களைத் தரும் வகையில் மாதிரி சீரமைக்கப்படுகிறது.
ஐந்தாம் படி: அனுமானம் மற்றும் உருவாக்கம் (Inference & Generation)
பயனர் வழங்கும் தூண்டுதல் குறிப்பின் (Prompt) அடிப்படையில், புள்ளியியல் நிகழ்தகவு உத்திகளைப் (Decoding & Sampling Strategies — Temperature, Top-p) பயன்படுத்தி மிகவும் பொருத்தமான வெளியீட்டு உரையை (Generated Text Output) உடனடியாக உருவாக்குகிறது.
ஓர் AI மாதிரி எவ்வாறு கற்றுக் கொள்கிறது?
ஓர் AI மாதிரி நாம் பள்ளியில் கற்பது போலக் கற்பதில்லை. அது அடுத்த சொல்லைக் கணிப்பதன் மூலம் (Next-Token Prediction) மட்டுமே கற்கிறது:
"இலங்கையின் தலைநகரம் ஸ்ரீ ஜெயவர்த்தனபுர..." என்று கொடுக்கும்போது, அடுத்து வர வேண்டிய சொல் "கோட்டே" என்பதற்கான நிகழ்தகவு 99.8% என்பதை அது கணித ரீதியாகக் கண்டறிகிறது.
மாதிரி ஒரு தவறான கணிப்பைச் செய்யும்போது, அதன் பிழையை (Loss Function) அளவிட்டு, பின்புறப் பரவல் (Backpropagation) என்ற கணித முறை மூலம் மாதிரியின் எடைகளைச் (Weights) சரிசெய்து தன்னைத்தானே திருத்திக் கொள்கிறது. டிரில்லியன் கணக்கான முறை இந்த செயல்முறை நிகழும்போது, மொழியின் விதிகளும் கருத்துக்களும் மாதிரிக்குள் ஆழமாகப் பதிகின்றன.
LLM என்பது உண்மை இயந்திரம் அல்லாமல் சாத்தியக்கூறு இயந்திரமாக அமைவது ஏன்?
நீங்கள் ஒரு மாணவராக, ஆசிரியராக, பெற்றோராக அல்லது தொழில் வல்லுநராக இருந்தாலும், புரிந்து கொள்ள வேண்டிய மிக முக்கியமான பாடம் இதுவேயாகும்: * LLM என்பது ஒரு தரவுத்தளம் (Database) அல்ல. அது தகவல்களைச் சேமித்து வைத்திருக்கவில்லை. * LLM என்பது உண்மையை மட்டுமே பேசும் உண்மை இயந்திரமும் (Truth Engine) அல்ல. * அது முற்றிலும் ஒரு சாத்தியக்கூறு இயந்திரம் (Plausibility / Probability Engine) மட்டுமே.
அதன் நோக்கம் உங்கள் கேள்விக்கு மிகவும் பொருத்தமான, படிக்க இனிமையான, மொழியியல் ரீதியாகச் சீரான பதிலை உருவாக்குவது மட்டுமே. அதில் அதற்கு உண்மை தெரியாவிட்டால், மிகவும் நம்பிக்கையான தொனியில் முழுப் பொய்யான தகவல்களைக் கூட இட்டுக்கட்டி வழங்கிவிடும். இது AI துறையில் மாயத்தோற்றம் (Hallucinations) என்று அழைக்கப்படுகிறது.
எனவே, எந்தவொரு முக்கியமான முடிவையும் எடுக்கும் போது, AI தரும் தகவல்களை மீண்டும் சரிபார்க்கும் (Verification) பொறுப்பு 100% அதைப் பயன்படுத்தும் மனிதரிடமே உள்ளது!
தமிழ் மற்றும் சிங்கள மொழிகளில் AI மாதிரிகள் வேறுபடுவது ஏன்?
பலரும் எதிர்கொள்ளும் ஒரு சிக்கல்: ஆங்கிலத்தில் மிகச் சிறப்பாகச் செயல்படும் ChatGPT அல்லது Gemini, தமிழ் அல்லது சிங்களத்தில் கேள்விகள் கேட்கும் போது சில நேரங்களில் தவறான அல்லது விசித்திரமான பதில்களை வழங்குவது ஏன் என்பதாகும். இதற்கு நான்கு காரணங்கள் உண்டு:
மேற்கத்திய அறிவுப் சார்பு (Western Knowledge Bias)
உலகின் முன்னணி LLM மாதிரிகளைப் பயிற்றுவிக்கப் பயன்படுத்தப்பட்ட இணையத் தரவுகளில் 85% க்கும் அதிகமானவை ஆங்கில மொழியிலேயே உள்ளன. மேற்கத்திய உலகின் வரலாறு, சட்டம் மற்றும் கலாச்சாரம் இம்மாதிரிகளுக்குள் ஆழமாகப் பதிந்துள்ள போதிலும், இலங்கையின் கலாச்சாரம், நமது பாடசாலைப் பாடத்திட்டம் அல்லது உள்ளூர் விடயங்கள் குறித்த அறிவு ஒப்பீட்டளவில் குறைவாகவே உள்ளது.
கூகிள் ஜெமினியின் சிங்கள மொழி நன்மை (Google Gemini's Sinhala Advantage)
கூகிள் நிறுவனம் பல ஆண்டுகளாக Google Translate மற்றும் Android அமைப்புகள் மூலம் சிங்கள மற்றும் தமிழ் மொழித் தரவுகளைச் சேகரித்துள்ளதால், உள்ளூர் மொழிகளைக் கையாள்வதில் Gemini மாதிரி பெரும்பாலும் ChatGPT-யை விட அதிக துல்லியத்தையும் இயல்பான மொழி நடையையும் வெளிப்படுத்துகிறது.
சீனாவின் டீப்ஸீக்கின் (DeepSeek) ஆச்சரியம் (The Surprise of China's DeepSeek)
சீனாவிலிருந்து வெளிவந்த DeepSeek-R1 மாதிரி திறந்த மூலமாக (Open Source) குறைந்த செலவில் கிடைக்கிறது; இதன் தர்க்கரீதியான சிந்திக்கும் திறன் OpenAI-யின் o1 மாதிரிக்கு இணையான மட்டத்தில் உள்ளது. ஆனால் மொழியியல் ரீதியாகத் தமிழ் மற்றும் சிங்களத்தைக் கையாள்வதில் இது இன்னும் ஆரம்ப நிலையிலேயே உள்ளது.
சிங்களத்தை விட தமிழ் சிறப்பாகச் செயல்படுவது ஏன்? (Why Tamil Fares Better than Sinhala)
இலங்கையில் தமிழ் மொழியைப் பேசுபவர்களுக்கு AI கருவிகளைப் பயன்படுத்துவது ஒப்பீட்டளவில் எளிதானது. ஏனெனில், இந்தியாவின் தமிழ்நாடு உட்பட உலகம் முழுவதும் உள்ள பல கோடி தமிழ் மக்களால் இணையத்தில் சேர்க்கப்பட்ட பிரம்மாண்டமான தமிழ் இலக்கியங்களும் டிஜிட்டல் உள்ளடக்கங்களும் உள்ளன. ஆனால் சிங்கள மொழியைப் பேசுபவர்கள் உலகில் சுமார் இரண்டு கோடி பேர் மட்டுமே. நாம் இணையத்தில் சேர்த்துள்ள டிஜிட்டல் சிங்கள உள்ளடக்கம் மிகவும் குறைவு. எனவே சிங்களத்தில் AI-யைப் பயன்படுத்தும் போது கூடுதல் விழிப்புணர்வு தேவைப்படுகிறது.
பல்தொகுதி AI (Multimodal AI) என்பதன் உண்மையான அர்த்தம் என்ன?
இன்று இந்த மாதிரிகள் வெறும் உரையுடன் (Text) மட்டும் நின்றுவிடவில்லை. நவீன முன்னணி மாடல்கள் முழுமையான பல்தொகுதி (Multimodal) அமைப்புகளாகச் செயல்படுகின்றன.
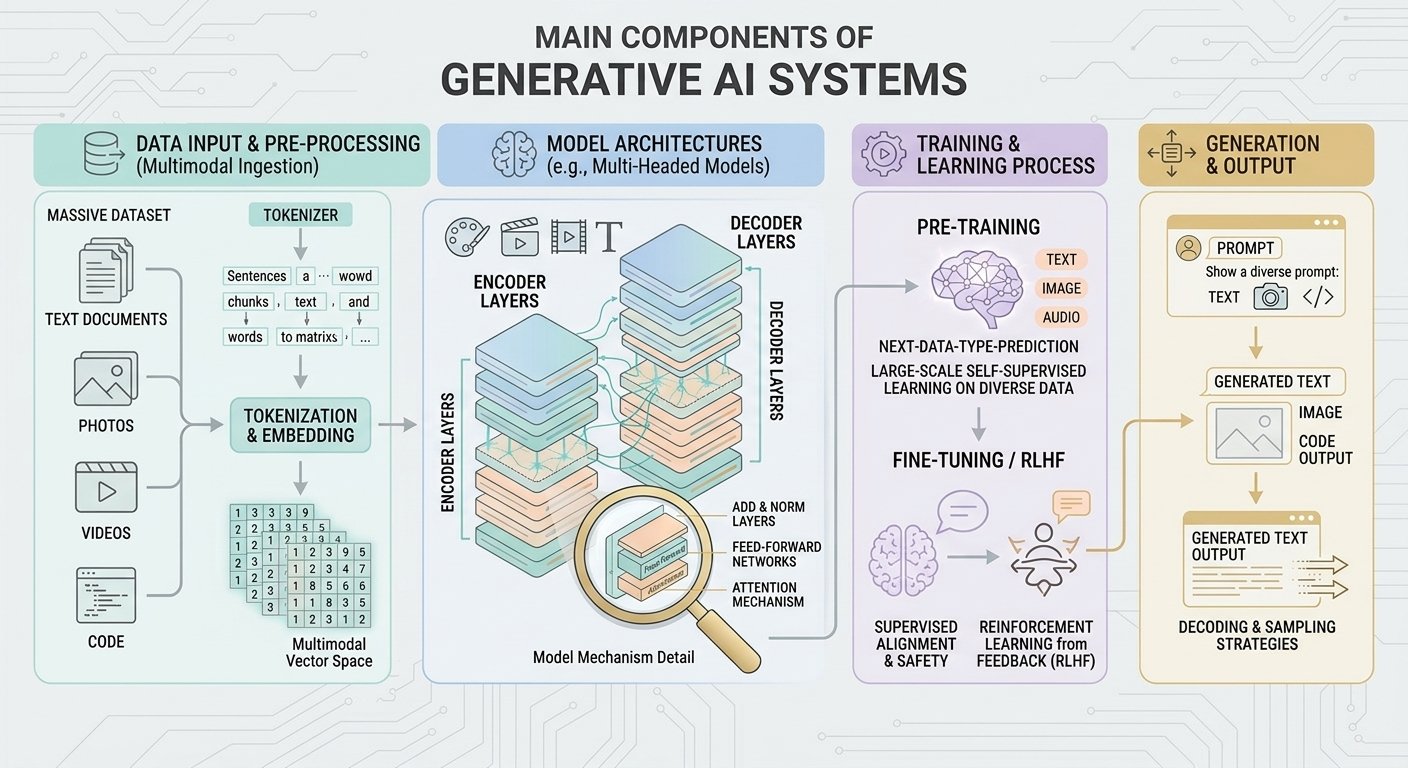 படம் 3.5: பல்தொகுதி ஆக்கபூர்வ AI அமைப்பின் கட்டமைப்பு — பல்தொகுதித் தரவு உள்ளீடு, ஒருங்கிணைந்த பல பரிமாண திசையன் வெளி, பல்தலை டிரான்ஸ்ஃபார்மர் மற்றும் பல்தொகுதி வெளியீடு.
உரைத் தடையில்லாத நேரடி உள்ளீடு (Ingestion Without a Text Bottleneck)
பழைய முறையைப் போல ஒரு படத்தைப் பார்க்கும் போது அதை முதலில் எழுத்தாக மாற்றுவதில்லை. புகைப்படங்கள் மற்றும் வீடியோ பிரேம்களை சிறிய பிக்சல் துண்டுகளாகப் (16x16 Patches) பிரித்து காட்சி டோக்கன்களாகவும் (Visual Tokens), ஒலி அலைகளை அலைவரிசைகள் (Spectrograms) வழியாக ஒலி டோக்கன்களாகவும் (Audio Tokens) நேரடியாக மாற்றுகிறது.
ஒருங்கிணைந்த வெக்டர் வெளி (The Unified Vector Space)
இது முழு அமைப்பின் மிக உன்னதமான பொறியியல் வெற்றியாகும்! இலங்கை தேசிய அடையாள அட்டையின் புகைப்படம், தமிழில் பேசப்படும் "தேசிய அடையாள அட்டை" என்ற குரல் பதிவு, மற்றும் ஆங்கிலத்தில் எழுதப்பட்ட "National Identity Card" என்ற உரை ஆகிய அனைத்தும் இந்த பல பரிமாணக் கணித வெளியில் ஒரே ஆயத்தொலைவுப் பகுதியில் ஒன்றாக அமைகின்றன. இதன் மூலம் இயந்திரத்தால் வெவ்வேறு வடிவங்களுக்கு இடையே தடையின்றிப் புரிதலை ஏற்படுத்த முடிகிறது.
ஊடகங்களுக்கிடையேயான குறுக்கு-கவனம் (Cross-Attention Between Modalities)
வெவ்வேறு ஊடக வடிவங்களுக்கு இடையே குறுக்கு-கவனம் (Cross-Attention) செயல்படுகிறது. உதாரணமாக, ஸ்கேன் செய்யப்பட்ட நிலப் பத்திரத்தில் உள்ள கையொப்பத்தைப் பார்க்கும் அதே வேளையில், அதில் எழுதப்பட்டுள்ள நில உரிமையாளரின் பெயரை உரையுடன் ஒப்பிட்டுப் பார்க்கும் திறன் மாதிரிக்குக் கிடைக்கிறது.
பல்தொகுதிப் பயிற்சி மற்றும் பாதுகாப்பு சீரமைப்பு (Multimodal Training & Safety Alignment)
அடுத்த தரவு வகையைக் கணிப்பதன் மூலம் வீடியோ, ஒலி மற்றும் உரை கலந்த தரவுகளில் பயிற்சி பெறுதல் மற்றும் பாதுகாப்பு வழிகாட்டுதல்கள் மற்றும் போலி ஆக்கங்களைத் (Deepfakes) தடுக்கும் பாதுகாப்பு வடிகட்டிகள் இங்கு செயல்படுத்தப்படுகின்றன.
எந்தவொரு ஊடகத்திலும் வெளியீட்டு உருவாக்கம் (Generation in Any Medium)
பயனர் எந்தவொரு வடிவத்திலும் உள்ளீட்டை வழங்கலாம் (எ.கா: ஒரு புகாரின் ஆடியோ பதிவு + பேரிடர் புகைப்படம்). அமைப்பு புள்ளியியல் நிகழ்தகவு உத்திகள் மூலம் தமிழில் உத்தியோகபூர்வ அறிக்கை, சேதத்தைக் குறிக்கும் வரைபடம் அல்லது தீர்வுக்கான குறியீட்டை உடனடியாக உருவாக்கித் தருகிறது.
உங்களுக்குக் கிடைக்கும் நடைமுறை மதிப்பு
- கையால் எழுதப்பட்ட பழைய கடிதம் அல்லது பதிவேட்டின் புகைப்படத்தை உள்ளிட்டு அதன் உள்ளடக்கத்தை நொடிகளில் வாசித்தல் (Vision OCR).
- ஒரு மாணவரின் கையால் எழுதப்பட்ட விடைத்தாளைப் புகைப்படம் எடுத்து, முறைக்கான புள்ளிகளையும் துல்லியத்திற்கான புள்ளிகளையும் தனித்தனியாகப் பகுப்பாய்வு செய்வித்தல்.
- ஒரு சந்திப்பில் பெற்றோர் முன்வைக்கும் கவலையின் ஆடியோ பதிவை உள்ளிட்டு, அவர்கள் அறையை விட்டு வெளியேறும் முன்பே பின்தொடர்தல் குறிப்பைத் தயாரித்தல்.
- ஓர் அத்தியாயத்திலுள்ள வரைபடம் அல்லது விளக்கப்படத்தை ஆய்வு செய்து அதன் முரண்பாடுகளைக் கண்டறிதல்.
அடுத்த தொகுதியில், இந்த இயற்கை மொழிப் புரட்சியின் காரணமாக மனிதநேயக் கல்வி எவ்வாறு மீண்டும் முன்னரங்கிற்கு வருகிறது, மற்றும் சாதாரண குடிமக்கள் எதிர்கொள்ளும் டிஜிட்டல் இடைவெளியை AI எவ்வாறு குறைக்கிறது என்பதை விரிவாக ஆராய்வோம்.