තවත් භාෂාවලින්: English · தமிழ்
ජනක AI (Generative AI) භාවිතයෙන් බහුභාෂා එන්ජිමක් ගොඩනඟන්නේ කෙසේද?
එක් මූලාශ්රයක්. භාෂා තුනක්. මාදිලි කිහිපයක්. සහ අත්සන් තබන මිනිසෙක්.
ඉඩසර ඩිජිටල් (Idasara Digital), 2026 සැප්තැම්බර්. ජනක AI භාවිතයෙන් එකම ලේඛනයක් සිංහල, දෙමළ සහ ඉංග්රීසි භාෂාවලින් නිවැරදිව ප්රකාශයට පත් කිරීම සඳහා වූ ප්රායෝගික පද්ධති නිර්මාණ සැලැස්මක් (architecture): තනි බලයලත් මූලාශ්රයක් (single authoritative source), හුදු කීර්ති නාමයට වඩා මිණුම් ලකුණු (benchmarks) අනුව තෝරාගන්නා භාෂා මාදිලි එකතුවක් (pool of models), පළමු මාදිලිය පරීක්ෂා කරන දෙවන මාදිලියක්, සහ කිසිවක් ප්රකාශයට පත් කිරීමට පෙර අනුමත කරන මිනිසෙක්. ශ්රී ලංකාවේ භාෂා තුන වෙනුවෙන් ලියැවුණු, එක් භාෂාවකට වඩා වැඩි ගණනකින් ජනතාවට සේවය කරන ඕනෑම ආයතනයක් සඳහා ක්රියාත්මක වන පරිදි ගොඩනඟන ලද්දකි.
කෙටියෙන් කිවහොත්: ජනක AI (Generative AI) මඟින් පරිවර්තනය ලාභදායී කර ඇත. නමුත් එය විශ්වාසදායක කර නැත. ඔබ එක් භාෂාවකට වඩා වැඩි ගණනකින් ජනතාවට සේවය කරන්නේ නම්, ඊට පිළිතුර "ChatGPT එකට paste කිරීම" නොවේ; "පරිපූර්ණ මාදිලියක් පැමිණෙන තුරු බලා සිටීමද" නොවේ. ඊට පිළිතුර වන්නේ පද්ධතිගත එන්ජිමකි (engine): එක් බලයලත් මූලාශ්රයක් (one authoritative source), එක් එක් භාෂාවට සහ ක්ෂේත්රයට අදාළ මනින ලද ප්රතිඵල මඟින් තෝරාගත් මාදිලි එකතුවක් (pool of models), පළමුවැන්න සමාලෝචනය කරන දෙවන මාදිලියක්, වචනවල ඒකාකාරී බව සුරකින පාරිභාෂික ශබ්දකෝෂයක් (terminology bank) සහ පරිවර්තන මතකයක් (translation memory), සෑම පියවරක්ම කවුරුන් කුමකින් කළේදැයි සටහන් වන විගණන ලේඛනයක් (audit log), සහ කියවා බලා අත්සන් තබන මිනිසෙක්. එක් වරක් පරිවර්තනය කරන්න, එක් වරක් වලංගු කරන්න, සෑම තැනකම ප්රකාශයට පත් කරන්න. බහුවිධ මාදිලි (multiple models) භාවිතා කරන්න. අර්ථය වලංගු කරන්න (validate meaning). මිනිස් පාලනය ඉහළින්ම තබා ගන්න.
මම මේ කතාව පුහුණු ශාලාවකින් ආරම්භ කරන්නම්.
පසුගිය වසර පුරා මම යාපනයේ සිට මාතර දක්වා ශ්රී ලංකාව පුරා රාජ්ය නිලධාරීන් දසදහසකට වැඩි පිරිසක් සමඟ එකට හිඳිමින් ජනක AI (Generative AI) ගැන කතා කළෙමි. පාහේ සෑම ශාලාවකදීම, ඉක්මනින් හෝ පසුව, යමෙකු අත ඔසවා එම ප්රශ්නයම අසයි. "සර්, අපි ChatGPT එකෙන් සිංහලෙන් යමක් ඇහුවාම සමහර වෙලාවට විකාර එනවා. ඉංග්රීසියෙන් ඇහුවාම උත්තරේ විශිෂ්ටයි. ඇයි එහෙම වෙන්නේ?"
එය සාධාරණ ප්රශ්නයකි, එමෙන්ම එය රජයට පමණක් අදාළ ප්රශ්නයක් නොවේ. බැංකුවකට සිය පාරිභෝගික ලිපි සම්බන්ධයෙන් ඇත්තේ ද එම ගැටලුවමය. රෝහලකට සිය එකඟතා පත්රිකා (consent forms) සම්බන්ධයෙන් ඇත්තේ ද එයමය. පාසලකට දෙමාපියන් වෙත යවන නිවේදන පත්රිකාව සම්බන්ධයෙන් ඇත්තේ ද එයමය. විවිධ භාෂා කියවන ජනතාවට එකම කරුණ නිවැරදිව පැවසිය යුතු ඕනෑම ආයතනයකට මෙම ගැටලුව තිබේ. ශ්රී ලංකාව තුළ මෙය නොසලකා හැරීමට කිසිසේත්ම නොහැකිය; මන්ද අපේ ආණ්ඩුක්රම ව්යවස්ථාවෙන් සිංහල සහ දෙමළ රාජ්ය භාෂා ලෙසත්, ඉංග්රීසි සම්බන්ධක භාෂාව ලෙසත් නම් කර ඇති බැවිනි. අපේ රටේ භාෂා තුනක් භාවිත කිරීම යනු හුදු කැමැත්තක් නොවේ. එය නීතියයි; වඩාත් වැදගත් වන්නේ, එය සාධාරණත්වයයි.
එබැවින් මෙම ලිපියෙන් මට පිළිතුරු දීමට අවශ්ය වන්නේ ප්රායෝගික ප්රශ්නයකටය. ජනක AI අන්ධ ලෙස විශ්වාස නොකර, බහුභාෂා කටයුතු සඳහා එය ඵලදායී ලෙස භාවිත කරන එන්ජිමක් ගොඩනඟන්නේ කෙසේද?
එසේ නම්, අපි එය එකිනෙක ප්රශ්න වශයෙන් ගෙන විමසා බලමු.
1. "AI මඟින් පරිවර්තනය කර ගැනීම" පමණක් ප්රමාණවත් එන්ජිමක් නොවන්නේ ඇයි?
මන්ද කිසිදු පරීක්ෂාවකින් තොරව එක් මාදිලියක් එක් වරක් පමණක් භාවිත කිරීම, නිහඬ ආකාර තුනකින් අසාර්ථක වන බැවිනි.
එය අර්ථයෙන් බැහැරව පාවී යයි (It drifts in meaning). භාෂා මාදිලියක් සැබවින්ම පරිවර්තනය කරන්නේ නැත; එය කරන්නේ ඊළඟට පැමිණීමට වැඩිම ඉඩක් ඇති වචන පුරෝකථනය කිරීමයි. බොහෝ විට එයින් නිවැරදි අර්ථය මතු වේ. නමුත් ඇතැම් විට එය කියවීමට ඉතා සුමට හා අලංකාර වූ, එහෙත් මූලික අදහසට වඩා මදක් වෙනස් අර්ථයක් දෙන වාක්යයක් ගොඩනඟයි. කවියකදී එය ප්රියජනක විය හැකිය. එහෙත් ඉඩම් බලපත්රයක, ඖෂධ ලේබලයක, හෝ සුබසාධන ප්රතිලාභ හිමිකම් රීතියකදී එය බරපතළ හානියකි.
එය පාරිභාෂික පද සම්බන්ධයෙන් ඒකාකාරී නොවේ (It is inconsistent with terms). සඳුදා දිනක "Divisional Secretariat" යන්න පරිවර්තනය කිරීමට එම මාදිලියටම පවසන්න; නැවත බ්රහස්පතින්දා එයම පවසන්න; එවිට ඔබට සිංහලෙන් වෙනස් වචන දෙකක් ලැබිය හැකිය. ලේඛන දහසක් පුරා මෙය සිදුවන විට, ඔබේ පුරවැසියන් හෝ පාරිභෝගිකයන් සෑම පිටුවකම කියවන්නේ වෙනස් වෙනස් වචන මාලාවන්ය.
එය මිත්යාවන් මවයි (It hallucinates), එමෙන්ම එය ඉතා චතුර ලෙස මවයි. 2025 දී Deloitte Australia සමාගමට ඕස්ට්රේලියානු රජය වෙනුවෙන් සැකසූ වාර්තාවක මුදලින් කොටසක් ආපසු ගෙවීමට සිදු විය. ඒ පර්යේෂකයන් විසින් එහි අඩංගු ගොතන ලද උසාවි උපුටා දැක්වීමක් සහ සැබවින්ම නොපවතින ශාස්ත්රීය පත්රිකා පිළිබඳ තොරතුරු සොයා ගැනීමෙන් පසුවය. කිසිවෙකුත් හිතාමතා රැවටීමට උත්සාහ කළේ නැත. දක්ෂ මාදිලියක් ඉතා විශ්වාසදායක ලෙස පෙළ ජනනය කළ අතර, එය නිල වශයෙන් නිකුත් වීමට පෙර කිසිවෙකු එය ප්රවේශමෙන් කියවා බැලුවේ නැත. පරිවර්තනයේදී සිදුවන්නේද හරියටම එයමය; වෙනසකට ඇත්තේ, අනුමත කරන පුද්ගලයාට කියවීමට නොහැකි භාෂාවකින් එය සිදුවීමයි.
අප වැනි භාෂාවලටම ආවේණික වූ හතරවන අසාර්ථකත්වයක්ද ඇත. මෙම මාදිලි පුහුණු කර ඇත්තේ අතිමහත් ලෙස ඉංග්රීසි භාෂාවෙනි. දෙමළ භාෂාව සාපේක්ෂව හොඳින් ආවරණය වී ඇත; මන්ද ලොව පුරා විසිරී සිටින කෝටි ගණනක් වූ දෙමළ කතා කරන ජනතාව අන්තර්ජාලය තුළ විශාල අන්තර්ගතයක් ලියා ඇති බැවිනි. සිංහල භාෂාව කතා කරන්නේ කෝටි දෙකකට ආසන්න ජනතාවක් පමණක් වන අතර, ඔවුන් සියල්ලන්ම පාහේ සිටින්නේ මෙහිය; තවද අප අන්තර්ජාලයට එක් කර ඇත්තේ ඉතා සුළු ප්රමාණයකි. වාණිජ භාෂා මාදිලි පිළිබඳ පර්යේෂණවලින් පෙනී ගොස් ඇත්තේ බොහෝ භාෂා කතා කරන ජනතාව එක් වාක්යයක් සඳහා වැඩි මුදලක් ගෙවන බවයි (ටෝකන වැඩි ගණනකට කැඩී යන බැවින්), ඒ වෙනුවෙන් ඔවුන්ට ලැබෙන්නේ අඩු ගුණාත්මක ප්රතිඵල බවයි. ශ්රී ලාංකික පර්යේෂකයන් විසින් ගොඩනඟන ලද මෑත කාලීන මිණුම් සලකුණු (benchmarks) මඟින්ද පෙන්වන්නේ එම රටාවමය: ඉංග්රීසියෙන් මනාව තර්ක කරන මාදිලි, එම ගැටලුවම ස්වදේශිකව සිංහලෙන් හෝ දෙමළෙන් ඉදිරිපත් කළ විට කැපී පෙනෙන ලෙස දුර්වල වේ.
සරල වචනයෙන් කිවහොත්: සමස්තයක් ලෙස ලෝකයේ හොඳම මාදිලිය, ඔබේ භාෂාවට, ඔබේ ක්ෂේත්රයට, ඔබේ ලේඛන වර්ගයට හොඳම මාදිලියම විය යුතු නැත. එන්ජිමක අවශ්යතාව පැන නගින්නේ එතැනිනි.
2. සැබෑ එන්ජිමක් ක්රියාත්මක වන්නේ කෙසේද?
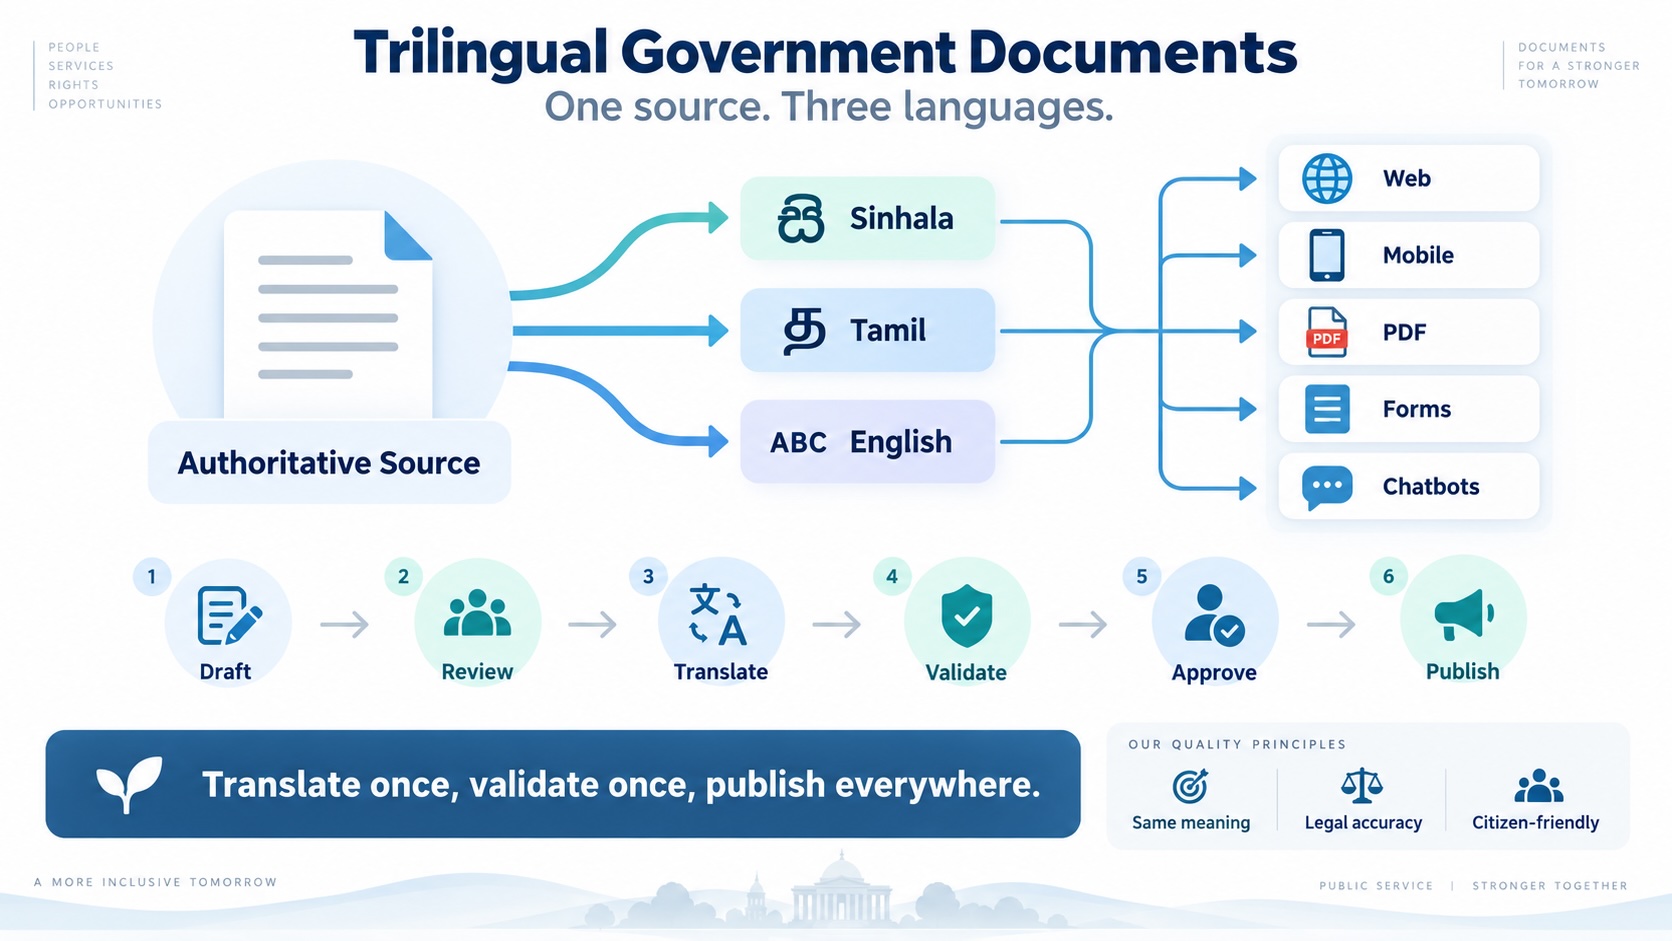
ඉහත දැක්වෙන පළමු සටහනෙන් ආරම්භ කරමු. සමස්ත සංකල්පයම එක් පේළියකට ගොනු කළ හැකිය: එක් වරක් පරිවර්තනය කරන්න, එක් වරක් වලංගු කරන්න, සෑම තැනකම ප්රකාශයට පත් කරන්න (translate once, validate once, publish everywhere).
මෙහි ඇත්තේ එක් බලයලත් මූලාශ්රයක් (authoritative source) පමණි. යමෙකු එක සමාන යැයි බලාපොරොත්තු වන ලේඛන තුනක් නොවේ; එක් භාෂාවකින් ලියැවුණු, සත්යය නියෝජනය කරන තනි ලේඛනයකි. අනෙක් සෑම සංස්කරණයක්ම බිහිවන්නේ එයින් වන අතර, මූලාශ්රය වෙනස් වන විට, සෙසු සංස්කරණද ඒ සමඟම යාවත්කාලීන වේ.
එම මූලාශ්රයෙන්, එන්ජිම විසින් සිංහල, දෙමළ සහ ඉංග්රීසි සංස්කරණ බිහිකරනු ලබයි. එම සංස්කරණවලින් සෑම නාලිකාවක්ම පෝෂණය වේ: වෙබ් අඩවිය, ජංගම යෙදුම (mobile app), PDF ලේඛනය, මුද්රිත ආකෘති පත්රය, සහ චැට්බෝට් (chatbot). මෙහිදී චැට්බෝට් ක්ෂණිකව පරිවර්තනය කරමින් තමන්ගේම අනුවාදයක් මවාගන්නේ නැත. එය කියවන්නේ කලින්ම අනුමත කරන ලද නිල සංස්කරණයයි.
මෙම නල පද්ධතිය (pipeline) පියවර හයකින් සමන්විත වන අතර, සෑම පියවරක්ම හුදු චාරිත්රයකට වඩා දැඩි දොරටුවකි (gate):
- කෙටුම්පත් කිරීම (Draft). මිනිසෙකු විසින් මූලාශ්රය ලියනු ලබයි.
- සමාලෝචනය (Review). මිනිසෙකු විසින් මූලාශ්රය පරීක්ෂා කරනු ලබයි. දුර්වල මූලික ලේඛනයක් පරිවර්තනය කිරීමෙන් කිසිවිටෙකත් ගුණාත්මක ප්රතිඵලයක් ලබාගත නොහැක.
- පරිවර්තනය (Translate). මාදිලි විසින් වෙහෙසකර බර වැඩ කොටස මෙහිදී සිදු කරයි. සතියක ඒකාකාරී වැඩ දිනක් බවට පත්වන්නේ මෙතැනදීය.
- වලංගු කිරීම (Validate). දෙවන මාදිලියක් මඟින් සහ මිනිසෙකු මඟින් අර්ථය, පාරිභාෂික පද සහ නීතිමය අර්ථය පරීක්ෂා කරනු ලබයි.
- අනුමත කිරීම (Approve). නම සඳහන් කළ මිනිසෙකු අත්සන් තබයි. සමස්ත එන්ජිමේම මූලික අරමුණ මෙම අත්සනයි.
- ප්රකාශනය (Publish). එකම අර්ථය සහිතව, නිසි සංස්කරණ අංක සහිතව (versioned) භාෂා තුනේම සංස්කරණ එකවර නිකුත් වේ.
මෙම නල පද්ධතිය යටින් ප්රධාන ගුණාත්මක මූලධර්ම තුනක් ක්රියාත්මක වන අතර, මා නම් ඒවා බිත්තියේ මුද්රණය කර අලවනු ඇත: එකම අර්ථය (same meaning), නීතිමය නිරවද්යතාව (legal accuracy), පුරවැසි හිතකාමී බව (citizen-friendly). ඔබ රජයක් නොවේ නම්: එකම අර්ථය, ඔබේ ක්ෂේත්රයට අදාළ නිරවද්යතාව, සහ ඔබේ පාරිභෝගිකයන් සැබවින්ම කතා කරන ආකාරයට ලිවීමයි.
3. එක් මාදිලියකට වඩා වැඩි ගණනක් භාවිත කරන්නේ ඇයි?
බොහෝ කණ්ඩායම් මඟහරින කොටස මෙය වන අතර, එන්ජිම විශ්වාසදායක එකක් බවට පත්කරන්නේද මෙම කොටසයි.
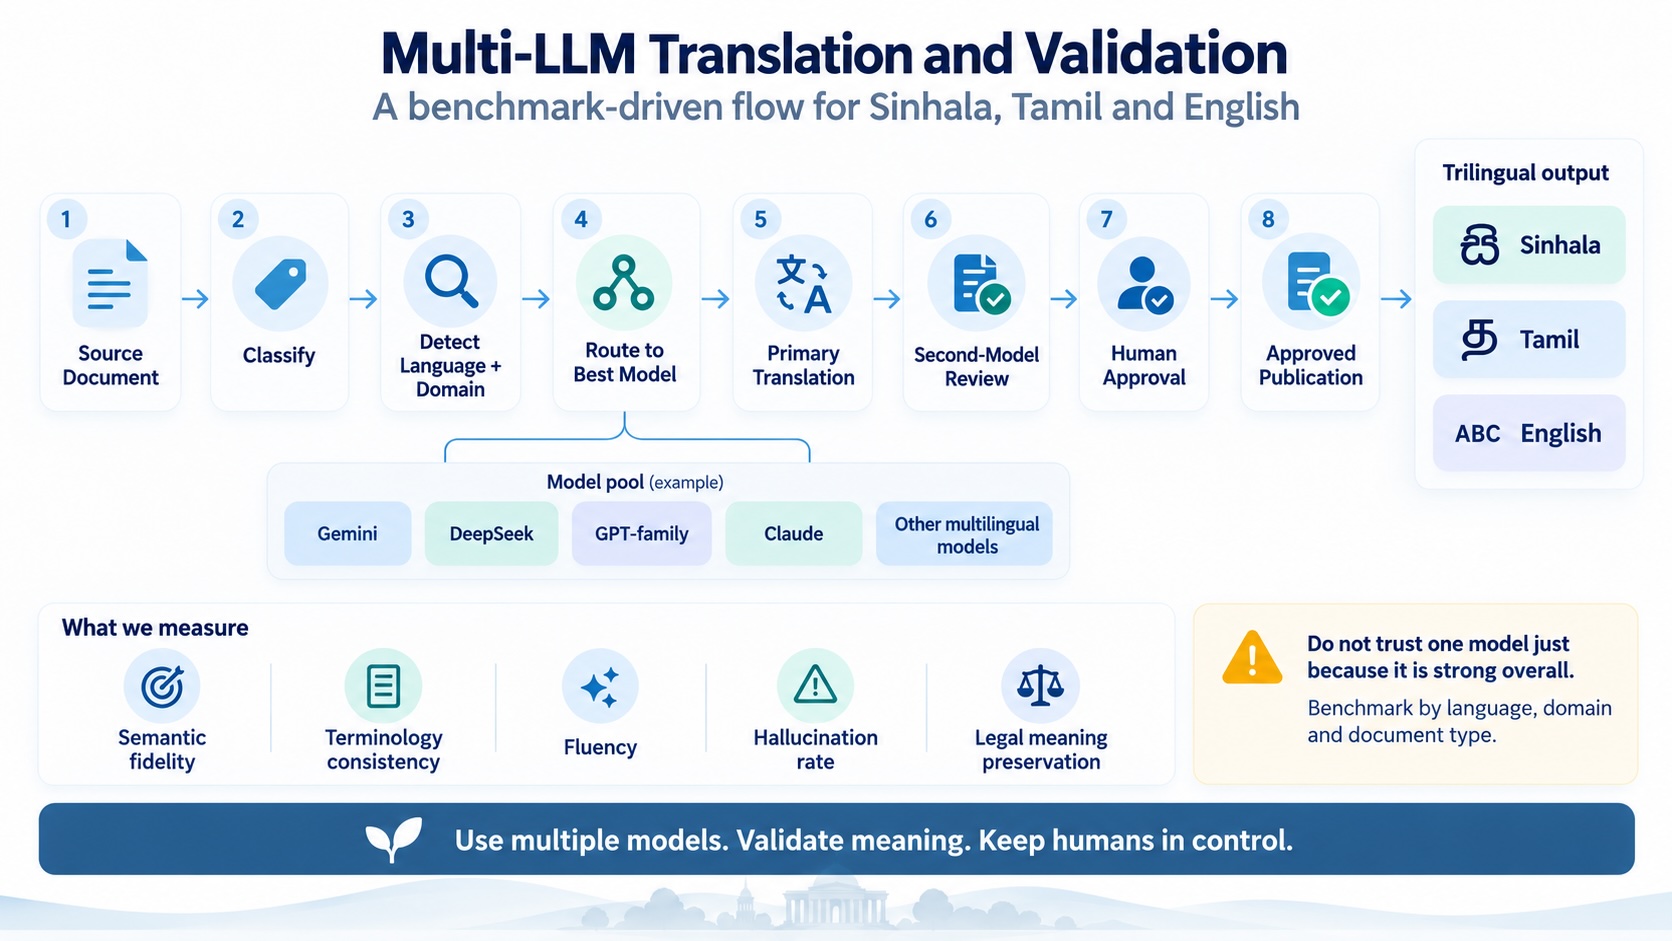
ඉහත දෙවන සටහන දෙස බලන්න. "මූලාශ්ර ලේඛනය" සහ "අනුමත ප්රකාශනය" අතර, තනි මාදිලි පද්ධතියක කිසිදා නොමැති අංග දෙකක් ඇත: මාදිලිය තෝරාගන්නා මාර්ගගතකය (router), සහ පළමුවැන්න සමාලෝචනය කරන දෙවන මාදිලිය (second model).
මාර්ගගතකය (The router). කිසිවක් පරිවර්තනය කිරීමට පෙර, එන්ජිම විසින් ලේඛනය වර්ගීකරණය කරයි, එහි භාෂාව සහ ක්ෂේත්රය (domain) හඳුනා ගනී, ඉන්පසු එම සංයෝජනය සඳහා මැනවින්ම ප්රතිඵල ලබා දුන් මාදිලිය තෝරා ගනී. වඩාත්ම ආකර්ෂණීය වෙළඳපොළ එළිදැක්වීමක් කළ මාදිලිය නොවේ; ඔබේ මිණුම් සලකුණු (benchmark) පරීක්ෂාවේදී, මෙම භාෂාව සඳහා, මෙම ක්ෂේත්රයේ, මෙම ලේඛන වර්ගය සඳහා ඉහළම ලකුණු ලබාගත් මාදිලියයි. මගේම පුහුණු සැසිවලදී, Gemini මාදිලිය සිය ඇමරිකානු සගයන්ට වඩා ස්වභාවිකව සිංහල ව්යාකරණ හසුරුවන අයුරු මම දැක ඇත්තෙමි. මන්ද Google සමාගම වසර විස්සකට වැඩි කාලයක් පුරා සිංහල සහ දෙමළ වෙබ් පිටු සුචිගත කරමින් (indexing) සිටින බැවිනි. DeepSeek මාදිලිය චතුර සිංහල බසින් කාමරයක් මවිතයට පත් කරන අයුරු මම දැක ඇත්තෙමි. මන්ද එය චීන භාෂාව සහ ඉංග්රීසි නොවන පුළුල් දත්ත මත ගැඹුරින් පුහුණු කර ඇති බැවිනි. Claude මාදිලිය ඉංග්රීසි බසින් වඩාත් ප්රවේශම් සහගත නීතිමය කෙටුම්පත් සකසන අයුරු මම දැක ඇත්තෙමි. මෙම කිසිදු නිරීක්ෂණයක් අවසන් තීන්දුවක් නොවේ. ඒවා උපකල්පන පමණක් වන අතර, තීරණය ගනු ලබන්නේ ක්රමානුකූල මිණුම් ලකුණු (benchmark) මඟිනි.
සංචිතය (The pool). එබැවින් එන්ජිම සතුව මාදිලි සංචිතයක් ඇත: Gemini, DeepSeek, GPT පවුල, Claude, සහ ලබන වසරේ පැමිණෙන ඕනෑම ප්රබල බහුභාෂා මාදිලියක්. මෙම සංචිතය ශක්තියක් වන්නේ හරියටම මාදිලි නිරන්තරයෙන් වෙනස් වන බැවිනි. නව මාදිලියක් පැමිණි විට, ඔබ මුළු එන්ජිමම අලුතින් ගොඩනඟන්නේ නැත. ඔබ එය මිණුම් සලකුණු මඟින් පරීක්ෂා කරයි; දෙමළ නීති නිවේදන සඳහා එය ජයග්රහණය කරන්නේ නම්, මාර්ගගතකය විසින් දෙමළ නීති නිවේදන ඊට යොමු කිරීම ආරම්භ කරයි.
දෙවන මාදිලියේ සමාලෝචනය (The second-model review). මූලික පරිවර්තනයෙන් පසුව, වෙනස් මාදිලියක් විසින් මූලාශ්රය සහ පරිවර්තනය එක ළඟ තබා කියවමින් නිශ්චිත ප්රශ්න මාලාවක් අසයි: මෙම වාක්යයෙන් අදහස් වන්නේ අර වාක්යයේ අදහසමද? අනුමත පාරිභාෂික ශබ්දකෝෂයෙන් පිටතට ගිය කිසියම් පදයක් තිබේද? මූලාශ්රයේ නැති යමක් මෙහි අලුතින් එකතු කර තිබේද? විවිධ මාදිලි දෙකක් එකම ස්ථානයේ එකම වරද සිදු කරන්නේ ඉතා කලාතුරකිනි. තනි මාදිලියකට මඟහැරී යන වැරදි මෙම සමාලෝචනය මඟින් හසුවන්නේ එබැවිනි.
ඇත්ත වශයෙන්ම, මෙය මගේම ඉංජිනේරු ජීවිතයේදී මා භාවිත කරන සහ සෑම පුහුණු සැසියකදීම මා උගන්වන පුරුද්දමය. මම එක් මෙවලමකින් කරුණු එක්රැස් කරමි, දෙවැන්නකින් ප්රේරකය (prompt) පුළුල් කර තියුණු කරමි, තෙවැන්නකින් කෙටුම්පත් කරමි, අවසානයේ අත්සන් තැබීමට පෙර සෑම පේළියක්ම මා විසින්ම ප්රවේශමෙන් කියවමි. එන්ජිම මඟින් සිදු කරන්නේ එම විනය ක්රමානුකූල සහ නැවත කළ හැකි (repeatable) එකක් බවට පත් කිරීමයි; එවිට එය හොඳ මනෝභාවයකින් සිටින එක් ප්රවේශම් සහගත පුද්ගලයෙකු මත පමණක් රඳා නොපවතී.
අප මනින්නේ මොනවාද? මිණුම් සලකුණක් (benchmark) අවංක වන්නේ එහි මිනුම් ඒකක අවංක වන තරමට පමණි. අපේ එන්ජිම මෙහිදී සාධක පහක් නිරීක්ෂණය කරයි:
- අර්ථමය විශ්වාසනීයත්වය (Semantic fidelity). පරිවර්තනයෙන් අදහස් වන්නේ මූලාශ්රයේ මුල් අදහසමද?
- පාරිභාෂික පද ඒකාකාරීත්වය (Terminology consistency). අනුමත පද සෑම අවස්ථාවකදීම එකම ආකාරයකින් භාවිත කර තිබේද?
- චතුර බව (Fluency). එය යන්ත්රයකින් පරිවර්තනය කළ එකක් මෙන් නොව, එම භාෂාව මව්බස කරගත් අයෙකු ලියූ ස්වභාවික අයුරින් කියවිය හැකිද?
- මිත්යා ජනන අනුපාතය (Hallucination rate). මූලාශ්රයේ කිසිසේත්ම නොතිබූ අලුත් කරුණු කොතෙක් දුරට මතුවී තිබේද?
- නීතිමය අර්ථය සුරැකීම (Legal meaning preservation). නියාමනය කරන ලද ලියවිලි සඳහා, වගකීම, අයිතිය, හෝ නියමිත කාලසීමාව නොවෙනස්ව ආරක්ෂා වී තිබේද?
ඔබේම සැබෑ ලේඛන උපයෝගී කරගනිමින්, එම භාෂාවන් මව්බස කරගත් ඇගයීම්කරුවන් ලවා, සෑම භාෂාවක් සහ ක්ෂේත්රයක් සඳහාම සෑම මාදිලියක්ම මෙම සාධක පහ ඔස්සේ ලකුණු කරන්න. ඉන්පසු ලැබෙන දත්ත මත පදනම්ව කාර්යයන් බෙදාහරින්න. සමස්තයක් ලෙස ප්රබල වූ පමණින් කිසිදු තනි මාදිලියක් අන්ධ ලෙස විශ්වාස නොකරන්න.
4. එන්ජිම සුරක්ෂිතව සහ පාලනයකින් යුතුව පවත්වා ගන්නේ කෙසේද?
දැන් තෙවන සටහන දෙස බලන්න — පිවිසුම් ද්වාරය (the gateway). ආයතනයකට සැබවින්ම ක්රියාත්මක කළ හැකි ආකෘතිය මෙයයි.
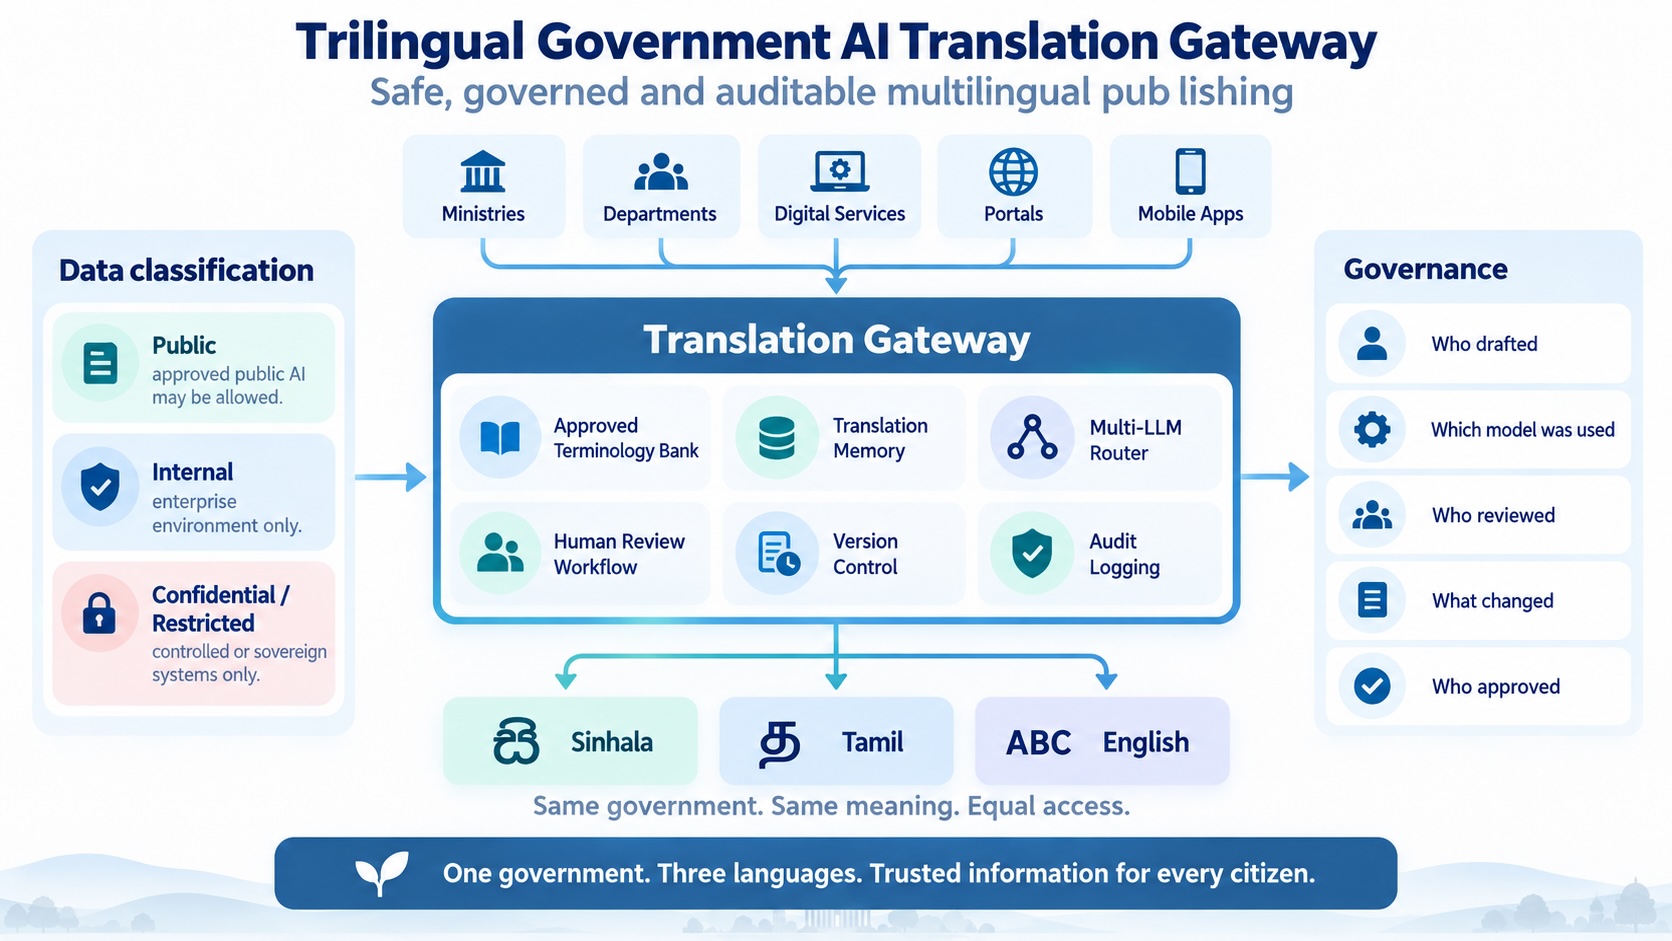
සෑම කණ්ඩායමක්ම තම දුරකථනයේ ඇති නොමිලේ දෙන මෙවලමකට හොරෙන් පෙළ පිටපත් කර දමනවා වෙනුවට, සෑම අමාත්යාංශයක්ම, දෙපාර්තමේන්තුවක්ම, ද්වාරයක්ම සහ යෙදුමක්ම සිය ලේඛන එක් පිවිසුම් ද්වාරයක් (one gateway) හරහා යවයි. අනෙක් සියල්ල කළ හැකි වන්නේ එම තනි දොරටුව නිසාවෙනි. ඒ තුළ ප්රධාන උපාංග හයක් ක්රියාත්මක වේ:
- අනුමත පාරිභාෂික ශබ්දකෝෂයක් (An approved terminology bank). ඔබේ ආයතනය භාවිත කරන සෑම පදයක් සඳහාම නිල සිංහල, දෙමළ සහ ඉංග්රීසි යෙදුම්, මිනිසුන් විසින් පවත්වාගෙන යමින්, මාදිලි මත බලාත්මක කරනු ලැබේ. "සඳුදා සහ බ්රහස්පතින්දා අතර වෙනස් වීමේ" ගැටලුව අවසන් කරන්නේ මෙයයි.
- පරිවර්තන මතකයක් (A translation memory). දැනටමත් අනුමත කර ඇති වාක්ය නැවත නැවත පරිවර්තනය නොකර, නැවත භාවිත කරනු ලැබේ. එය පිරිවැය ඉතිරි කරයි; ඊටත් වඩා වැදගත් වන්නේ, අනුමත කළ වාක්යයක් ලබන මසදී සුළු වෙනසක් සහිතව අලුතින් නිපදවීම ඉන් වළක්වාලීමයි.
- පෙර කොටසේ සාකච්ඡා කළ බහු-LLM මාර්ගගතකය (The multi-LLM router).
- මිනිස් සමාලෝචන වැඩපෙළක් (A human review workflow). එක් එක් භාෂාව සඳහා නම් කරන ලද සමාලෝචකයන්, මූලාශ්රය සහ පරිවර්තනය එක ළඟ තබා, දෙවන මාදිලියේ නිරීක්ෂණද ඉදිරියේ තබාගෙන පරීක්ෂා කරයි.
- අනුවාද පාලනය (Version control). සෑම සංස්කරණයක්ම මූලාශ්රයේ නිශ්චිත අනුවාදයකට බැඳී ඇත. මූලාශ්රය වෙනස් වූ විට, දැන් යල් පැන ගොස් ඇත්තේ කුමන සංස්කරණදැයි එන්ජිම නිවැරදිව හඳුනා ගනී.
- විගණන ලේඛනය (Audit logging). ප්රකාශයට පත් කරන සෑම වාක්යයක් සඳහාම: කෙටුම්පත් කළේ කවුද, භාවිත කළ මාදිලිය කුමක්ද, සමාලෝචනය කළේ කවුද, වෙනස් වූයේ මොනවාද, අනුමත කළේ කවුද යන්න සටහන් වේ. පුරවැසියෙකු හෝ අධිකරණයක් "දෙමළ භාෂාවෙන් මෙසේ කියවෙන්නේ ඇයි?" කියා විමසුවහොත්, මාසයක් නොව විනාඩියකින් ඊට පිළිතුරු දීමට ඔබට හැකියාව ලැබේ.
මෙම පිවිසුම් ද්වාරය වටා දත්ත වර්ගීකරණය (data classification) ක්රියාත්මක වන අතර, එයින් කුමන දත්ත කොතැනට යා හැකිද යන්න තීරණය කරයි:
- ප්රසිද්ධ (Public) තොරතුරු අනුමත ප්රසිද්ධ AI සේවාවන් වෙත යැවිය හැක.
- අභ්යන්තර (Internal) තොරතුරු, දත්ත රඳවා නොගන්නා (no data retention) ව්යවසාය මට්ටමේ පරිසරයක් තුළ පමණක් පවතී.
- රහසිගත හෝ සීමා කළ (Confidential or restricted) තොරතුරු යැවිය හැක්කේ දැඩි පාලනයක් සහිත ස්වෛරී පද්ධති (sovereign systems) වෙත පමණි; නැතහොත් කිසිසේත්ම කිසිදු මාදිලියක් වෙත නොයවනු ලැබේ.
මෙය වැදගත් වන්නේ මන්දැයි මා අවංකව කිව යුතුය. මා යන සෑම කාර්යාලයකම පාහේ, නිලධාරීන් දැනටමත් සිය පෞද්ගලික දුරකථනවල ඇති නොමිලේ දෙන AI මෙවලම් වෙත ලිපිගොනු යවමින් සිටිති. නරක චේතනාවකින් නොවේ. වැඩ බර දරාගත නොහැකි තරම් වන අතර, මෙවලමෙන් පිහිටක් ලැබේ. එය තහනම් කිරීමෙන් එය නතර වන්නේ නැත; එයින් සිදුවන්නේ එය ඇසට නොපෙනී රහසින් සිදුවීම පමණි. පිවිසුම් ද්වාරය යනු නිල වශයෙන් අනුමත කළ ආරක්ෂිත මාවතයි. එය මෙසේ පවසයි: මෙන්න ආරක්ෂිත ක්රමය, සහ මෙන්න ඔබට ඒ හරහා යැවිය හැකි සහ නොහැකි දේවල්.
5. මිනිසුන් රැඳී සිටින්නේ කොතැනද?
විනිශ්චය පවතින සෑම තැනකම මිනිසා රැඳී සිටිය යුතුය.
එන්ජිම විසින් වෙහෙසකර, ඒකාකාරී කොටස භාර ගනී: පරිවර්තනයේ පළමු කෙටුම්පත, ඒකාකාරී බව පරීක්ෂා කිරීම, එක ළඟ තබා සැසඳීම, සහ වාර්තා සටහන් කිරීම. සතියක දින හයක් ගිල දැමුවේ එම කාර්යයන්ය. එන්ජිම විසින් මිනිසාට ආපසු ලබා දෙන්නේ, මිනිසෙකුට පමණක් කළ හැකි කොටස වෙනුවෙන් අවශ්ය වටිනා කාලයයි.
සිංහල ලියවිල්ල සැබවින්ම සිංහල වාගේ ඇසෙන්නේදැයි තවමත් තීරණය කරන්නේ ස්වදේශික පාඨකයෙකි. මෙම පාඩම මගේම සමාගම තුළදී මා ඉගෙන ගත්තේ මෙම මාසයේදීමය. අපි සාමාන්ය පෙළ (O/L) සිසුන් වෙනුවෙන් නොමිලේ ලබා දෙන ඉංග්රීසි පොත් මාලාවක් සූදානම් කරමින් සිටියෙමු; එහි ඉංග්රීසි ආවරණ වැකිය වූයේ "English without the fear" යන්නයි. ඒ සඳහා විශ්වාසවන්ත සිංහල පරිවර්තන තුනක් මට ඉදිරිපත් විය; ඒ සියල්ල නිවැරදිය, සියල්ල වචනයෙන් වචනය පරිවර්තනය කළ ඒවාය, එහෙත් ඒ සියල්ල පණ නැති ඒවා විය. ඒ වෙනුවට මා ලියූ වැකිය වූයේ: බය නැතුව ඉංග්රීසි පේපර් එකට ලියමු ("let's write the English paper without fear") යන්නයි. විභාග ප්රශ්න පත්රය සඳහා සිසුන් සැබවින්ම භාවිත කරන වචනය එයයි, එය කතා කරන බසින් ලියැවුණකි, සහ එය හුදු තත්ත්වයක් නම් කරනවා වෙනුවට ක්රියාවකට ආරාධනා කරයි. කිසිදු AI මාදිලියක් එය යෝජනා කළේ නැත; මන්ද එය ඉංග්රීසි වැකියේ සෘජු පරිවර්තනයක් නොවන බැවිනි. එය පාඨකයාගේ භාෂාව තුළ වෙනස් කාර්යයක් ඉටු කරයි. එන්ජිමකට එවැනි තීන්දු ගත නොහැක. එයට කළ හැක්කේ මිනිසෙකුට එම තීන්දුව ගැනීමට අවශ්ය අවස්ථාව සලසා දීම පමණි.
අනුමත කරන්නා තවමත් අත්සන් තබයි. තර්කණ දාමයන් (chain-of-thought traces), දෙවන මාදිලි සමාලෝචන සහ විගණන ලේඛන පවතින්නේ අත්සන් තබන පුද්ගලයාට තමන් අත්සන් කරන්නේ කුමකටදැයි පැහැදිලිව දැකබලා ගැනීම සඳහාය. ඒවා පවතින්නේ අත්සන ඉවත් කිරීමට නොවේ.
අවසානයේදී, ත්රෛභාෂා ලේඛනයක වැදගත්කම වන්නේ ලිපිගොනු තුනක් පැවතීම නොවේ. යාපනයේ දෙමළ පාඨකයෙකුටත්, මාතර සිංහල පාඨකයෙකුටත්, කොළඹ ඉංග්රීසි පාඨකයෙකුටත් එකම අර්ථය සහ එකම අයිතිවාසිකම් ලැබීමයි. එකම රජය. එකම අර්ථය. සමාන ප්රවේශය. යන්ත්රයකට ඔබට එතැනට වේගයෙන් ළඟා වීමට උදවු කළ හැක. නමුත් ඒ වෙනුවෙන් ඔබට සහතික වීමට යන්ත්රයකට නොහැක.
6. අමාත්යාංශ මට්ටමේ මහා පරිමාණ අයවැයක් නොමැතිව ආරම්භ කරන්නේ කෙසේද?
පළමු දිනයේදීම ඔබට සම්පූර්ණ පිවිසුම් ද්වාරයක් අවශ්ය නොවේ. ඔබට අවශ්ය වන්නේ නිවැරදි පුරුදුයි.
- ඔබගේ සියලු භාෂාවලින් දැනටමත් පවතින, මිනිසුන් විසින් අනුමත කරන ලද සැබෑ ලේඛන පනහක් තෝරාගන්න. එය ඔබගේ මිණුම් සලකුණු කට්ටලයයි (benchmark set).
- පළමුව පාරිභාෂික ශබ්දකෝෂය ලියන්න. වචන දෙසීයක්, භාෂා තුනක්, එක් එක් පදය සඳහා එක අනුමත යෙදුමක්. මෙය ඉතා අඩු වියදමකින් කළ හැකි අතර, කිසිදු මාදිලියක් ධාවනය වීමට පෙර වැරදිවලින් අඩක්ම එයින් ඉවත් කරයි.
- ලේඛන පනහ හරහා මාදිලි තුනක් ධාවනය කරන්න. මව්බස කතා කරන පාඨකයන් ලවා ඉහත මිනුම් පහ ඔස්සේ ඒවාට ලකුණු ලබා දෙන්න. කුමන භාෂාවට ජයග්රහණය කරන්නේ කුමන මාදිලියද යන්න දැක ඔබ පුදුමයට පත් වනු ඇත. එම ප්රතිඵල ලියා තබන්න.
- ඔබ දැනටමත් ප්රකාශයට පත් කරන ඕනෑම දෙයකට දෙවන මාදිලි සමාලෝචනය එක් කරන්න. මාර්ගගතකයක් නොමැතිව වුවද, පළමුවැන්න පරීක්ෂා කරන දෙවන මාදිලියක් මඟින් බරපතළම අර්ථ වෙනස්වීම් හසුකර ගනු ඇත.
- සෑම දෙයක්ම සටහන් කරන්න (Log everything). කවුරුන්ද, කුමන මාදිලියද, සමාලෝචනය කළේ කවුරුන්ද, වෙනස් වූයේ මොනවාද, අනුමත කළේ කවුරුන්ද යන්නයි. ආරම්භයේදී පැතුරුම්පතක් (spreadsheet) වුවද ප්රමාණවත්ය. වැදගත් වන්නේ විනයගත පුරුද්දයි.
- එක් එක් භාෂාවෙන් නම් කරන ලද මිනිස් අනුමැතියකින් තොරව කිසිවිටෙකත් ප්රකාශයට පත් නොකරන්න.
එක් කාර්තුවක් (quarter) පුරා එය ක්රියාත්මක කරන්න; එවිට ඔබට එන්ජිමක් හිමිවනු ඇත. ඔබ විශාල මුදලක් දී එකක් මිලදී ගත් නිසා නොවේ; ඔබ ඒ සඳහා අවශ්ය විනය ගොඩනැඟූ නිසාත්, මෘදුකාංගය හුදෙක් ඒ අනුව ගමන් කළ නිසාත්ය.
මේ සියල්ල පැවසීමෙන් පසු, මා ආරම්භ කළ තැනින්ම — අර පුහුණු ශාලාවෙන්ම මෙය අවසන් කිරීමට මට ඉඩ දෙන්න.
සිංහලෙන් විකාර ලැබෙන්නේ ඇයිදැයි ඇසූ නිලධාරියා ඇසුවේ තාක්ෂණික ප්රශ්නයක් නොවේ. ඔහු විමසුවේ තමා වැනි අයටත්, තමාගේ පුරවැසියන්ටත් අන් සියල්ලන්ට මෙන්ම එක හා සමාන ගුණාත්මක උපකාරයක් ලැබෙන්නේද යන්නයි. අද දවසේ ඊට දිය හැකි අවංක පිළිතුර වන්නේ: එය ඉබේම සිදු නොවන බවයි. ඊට දිය හැකි බලාපොරොත්තු සහගත පිළිතුර වන්නේ: අප පරිවර්තනය යනු බොත්තමක් එබීමක් ලෙස සැලකීම නවත්වා, එය ක්රමානුකූල මිනුම් සහිත, එකිනෙකා විසින් සත්යතාව පරීක්ෂා කරනු ලබන බහුවිධ මාදිලි සහිත, සහ කියවා බලා අත්සන් තබන මිනිසුන් සහිත එන්ජිමක් ලෙස සැලකීමට පටන් ගන්නේ නම්, ඔවුන්ටද එම සාධාරණත්වය හිමි කර දිය හැකි බවයි.
ඉඩසර (Idasara) ආයතනය තුළ අප කරන්නේ එයයි. ඉඩසර ඇකඩමියේ අපගේ Learn to Learn පොත ඉංග්රීසි, සිංහල සහ දෙමළ භාෂා තුනෙන්ම එකවර එළිදැක්විණි; එහි සෑම පරිච්ඡේදයක්ම එක් මූලාශ්රයකින් බිහිවූ අතර ප්රකාශයට පත් කිරීමට පෙර ස්වදේශික පාඨකයෙකු විසින් පරීක්ෂා කරනු ලැබීය. එය කුඩා එන්ජිමකි. නමුත් එයද ක්රියාත්මක වන්නේ එම මූලධර්මය මතමය. ශ්රී ලංකාවේ වේවා, එක් භාෂාවකට වඩා වැඩි ගණනකින් ජනතාව කියවන ලොව ඕනෑම තැනක වේවා, ඔබේ ආයතනයටද එවැනි එන්ජිමක් අවශ්ය නම්, අප මෙහි සිටින්නේ ඒ වෙනුවෙන් සහාය වීමටයි.
බහුවිධ මාදිලි භාවිත කරන්න. අර්ථය වලංගු කරන්න. මිනිස් පාලනය ඉහළින්ම තබා ගන්න.
බැලූ බැල්මට (At a glance)
- බහුභාෂා AI එන්ජිමක් යනු කුමක්ද? භාෂා මාදිලි සංචිතයක්, දෙවන මාදිලි සමාලෝචනයක්, පාරිභාෂික ශබ්දකෝෂයක්, පරිවර්තන මතකයක්, විගණන ලේඛනයක් සහ මිනිස් අනුමැතියක් භාවිත කරමින්, එක් බලයලත් මූලාශ්ර ලේඛනයක් භාෂා කිහිපයකින් අනුමත සංස්කරණ බවට පත් කරන නල පද්ධතියකි (pipeline).
- එක් මාදිලියකට වඩා භාවිත කරන්නේ ඇයි? මන්ද සමස්තයක් ලෙස හොඳම මාදිලිය බොහෝ විට නිශ්චිත භාෂාවකට සහ ක්ෂේත්රයකට හොඳම මාදිලිය නොවන බැවිනි. මිණුම් සලකුණු අනුව මාර්ගගත කිරීම සහ දෙවන මාදිලියකින් පළමුවැන්න සමාලෝචනය කිරීම මඟින් තනි මාදිලියකට හසුනොවන වැරදි අනාවරණය කරගත හැක.
- මනිනු ලබන්නේ මොනවාද? ආයතනයේම ලේඛන මත පදනම්ව මව්බස කතා කරන ඇගයීම්කරුවන් විසින් ලකුණු දෙනු ලබන අර්ථමය විශ්වාසනීයත්වය, පාරිභාෂික පද ඒකාකාරීත්වය, චතුර බව, මිත්යා ජනන අනුපාතය සහ නීතිමය අර්ථය සුරැකීමයි.
- මෙය කා සඳහාද? රජයන්, බැංකු, රෝහල්, පාසල්, ප්රකාශකයන්, සහ එකම කරුණ එක් භාෂාවකට වඩා වැඩි ගණනකින් නිවැරදිව පැවසිය යුතු ඕනෑම ආයතනයක් සඳහාය.
නිතර අසන ප්රශ්න (Frequently asked questions)
නිල ලේඛන පරිවර්තනය කිරීමට මට ChatGPT හෝ Gemini කෙලින්ම භාවිත කළ හැකිද? ඉඩසර ආයතනයේ ස්ථාවරය වන්නේ නිල, නීතිමය හෝ නියාමනය කරන ලද ලියවිලි සඳහා කිසිදු පරීක්ෂාවකින් තොරව තනි මාදිලියක් එක් වරක් පමණක් භාවිත කිරීම ආරක්ෂිත නොවන බවයි. එය දෙවන මාදිලි සමාලෝචනයක් සහ නම් කළ මිනිස් අනුමැතියක් සහිත එන්ජිමක් තුළ පළමු කෙටුම්පත ලෙස භාවිත කරන්න; කිසිවිටෙකත් අවසන් තීරණය ලෙස භාවිත නොකරන්න.
සිංහල හෝ දෙමළ පරිවර්තනය සඳහා වඩාත්ම සුදුසු AI මාදිලිය කුමක්ද? එය ක්ෂේත්රය සහ ලේඛන වර්ගය මත රඳා පවතින අතර, මාදිලි යාවත්කාලීන වන විට වෙනස් වේ. කීර්ති නාමය අනුව තෝරාගන්නවා වෙනුවට, ස්වදේශික ඇගයීම්කරුවන් සමඟ ඔබේම ලේඛන මත මාදිලි කිහිපයක් මිණුම් සලකුණු කර, එක් එක් භාෂාවට සහ ක්ෂේත්රයට ඉහළම ලකුණු ලබා ගන්නා මාදිලිය වෙත යොමු කිරීමට ඉඩසර නිර්දේශ කරයි.
පාරිභාෂික ශබ්දකෝෂයක් යනු කුමක්ද සහ එය වැදගත් වන්නේ ඇයි? පාරිභාෂික ශබ්දකෝෂයක් යනු සෑම භාෂාවකින්ම එක් එක් වැදගත් යෙදුම සඳහා අනුමත කරන ලද නිල වචනයයි. විවිධ ලේඛන පුරා එකම පදය විවිධ ආකාරවලින් පරිවර්තනය වීම වැළැක්වීම සඳහා මාදිලි මත එය බලාත්මක කිරීම වඩාත්ම ලාභදායී සහ සරලම පියවරයි.
විගණන ලේඛනයක (audit log) සටහන් විය යුත්තේ මොනවාද? ප්රකාශයට පත් කරන සෑම සංස්කරණයක් සඳහාම: මූලාශ්රය කෙටුම්පත් කළේ කවුද, එය පරිවර්තනය කළ මාදිලිය කුමක්ද, එය සමාලෝචනය කළේ කවුද, සංස්කරණ අතර වෙනස් වූයේ මොනවාද, සහ එය අනුමත කළේ කවුද යන්නයි. "දෙමළ භාෂාවෙන් මෙසේ සඳහන් වන්නේ ඇයි?" කියා යමෙකු ඇසුවහොත් ආයතනයකට ඉක්මනින් සහ අවංකව පිළිතුරු දීමට ඉඩ සලසන්නේ මෙයයි.
මෙම එන්ජිම මඟින් පරිවර්තකයන් විස්ථාපනය කරන්නේද? නැත. එය විස්ථාපනය කරන්නේ ඒකාකාරී වෙහෙසකර පළමු කෙටුම්පත සකස් කිරීම සහ ඒකාකාරී බව පරීක්ෂා කිරීම පමණි. ස්වදේශික පාඨකයන් සහ අනුමත කරන්නන් අවසාන දොරටුව ලෙස රැඳී සිටින අතර, පාඨකයාට ස්වභාවිකව ඇසෙන වචන තෝරාගැනීම වැනි මාදිලිවලට කළ නොහැකි මානව විනිශ්චය සඳහා ඔවුන්ගේ කාලය නිදහස් වේ.
මෙම ලිපිය පිටුපස ඇති සාක්ෂි පදනම (The evidence behind this piece)
- ශ්රී ලංකා ප්රජාතාන්ත්රික සමාජවාදී ජනරජයේ ආණ්ඩුක්රම ව්යවස්ථාව, IV වන පරිච්ඡේදය, 18 වන වගන්තිය — සිංහල සහ දෙමළ රාජ්ය භාෂා ලෙසත්, ඉංග්රීසි සම්බන්ධක භාෂාව ලෙසත්. ශ්රී ලංකා පාර්ලිමේන්තුව: https://www.parliament.lk/files/pdf/constitution.pdf · මාර්ගගත පෙළ: https://www.constituteproject.org/constitution/Sri_Lanka_2015
- Ahia, Kumar, Gonen, Kasai, Mortensen, Smith & Tsvetkov (2023). "Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models." EMNLP 2023 — බොහෝ භාෂා කතා කරන ජනතාව එක් වාක්යයක් සඳහා වැඩි මුදලක් ගෙවන අතර වාණිජ භාෂා මාදිලි API වලින් අඩු ගුණාත්මක ප්රතිඵල ලබයි. https://aclanthology.org/2023.emnlp-main.614/
- "Large Language Models for Math Education in Low-Resource Languages: A Study in Sinhala and Tamil" (2026) — ගැටලු ඉංග්රීසි වෙනුවට ස්වදේශිකව සිංහලෙන් සහ දෙමළෙන් ඉදිරිපත් කළ විට තර්කණ ගුණාත්මකභාවය පිරිහී යයි. https://arxiv.org/abs/2602.14517
- "SinhalaMMLU: A Comprehensive Benchmark for Evaluating Multitask Language Understanding in Sinhala" (2025) — වර්තමාන මාදිලි හරහා ඉංග්රීසි සහ සිංහල කාර්යසාධනය අතර පරතරය පෙන්වන ස්වදේශික සිංහල මිණුම් සලකුණක්. https://arxiv.org/abs/2509.03162
- Fortune (2025 ඔක්තෝබර් 7), "Deloitte to refund Australian government after AI hallucinations in report" — AI සහාය ඇතිව සකස් කරන ලද රාජ්ය වාර්තාවක ගොතන ලද උසාවි උපුටා දැක්වීමක් සහ නොපවතින ශාස්ත්රීය යොමු කිරීම්. https://fortune.com/2025/10/07/deloitte-ai-australia-government-report-hallucinations-technology-290000-refund
- AI Incident Database, Incident 1193 — ඉහත Deloitte Australia සිදුවීම ලේඛනගත කිරීම. https://incidentdatabase.ai/cite/1193/
- ඉඩසර ඇකඩමිය (Idasara Academy), "Learn to Learn" — එක් මූලාශ්රයකින් ඉංග්රීසි, සිංහල සහ දෙමළ භාෂාවලින් ප්රකාශයට පත් කරන ලද නොමිලේ කියවිය හැකි පොත. https://academy.idasara.org/learn-to-learn/
රූප සටහන්: සමිස අබේසිංහ (Samisa Abeysinghe), ඉඩසර ඩිජිටල් (Idasara Digital), 2026 සැප්තැම්බර්.