பிற மொழிகளில்: English · සිංහල
உற்பத்திசார் AI (Generative AI) மூலம் ஒரு பன்மொழி இயந்திரத்தை உருவாக்குவது எப்படி?
ஒரு மூல ஆவணம். மூன்று மொழிகள். பல மாதிரி அமைப்புகள். கையொப்பமிடும் ஒரு மனிதர்.
இடசர டிஜிட்டல் (Idasara Digital), செப்டம்பர் 2026. உற்பத்திசார் AI (Generative AI) மூலம் ஒரே ஆவணத்தை சிங்களம், தமிழ் மற்றும் ஆங்கிலம் ஆகிய மொழிகளில் துல்லியமாக வெளியிடுவதற்கான ஒரு நடைமுறை கட்டமைப்பு (architecture): ஒரே அதிகாரப்பூர்வ மூலம் (single authoritative source), வெறும் புகழுக்கு அப்பால் மதிப்பீட்டு அளவுகோல்களின் (benchmarks) அடிப்படையில் தேர்ந்தெடுக்கப்படும் மாதிரி அமைப்புகளின் தொகுப்பு (model pool), முதலாவது மாதிரியைச் சரிபார்க்கும் இரண்டாவது மாதிரி அமைப்பு, மற்றும் வெளியிடுவதற்கு முன்னர் சரிபார்த்து அங்கீகரிக்கும் ஒரு மனிதர். இலங்கையின் மூன்று மொழிகளுக்காக எழுதப்பட்டு, ஒன்றுக்கு மேற்பட்ட மொழிகளில் மக்களுக்குச் சேவை செய்யும் எந்தவொரு நிறுவனத்திற்கும் பயன்படும் வகையில் உருவாக்கப்பட்டது.
சுருக்கமாக: உற்பத்திசார் AI (Generative AI) மொழிபெயர்ப்பை மலிவானதாக்கியுள்ளது. ஆனால் அது அதை நம்பகமானதாக மாற்றவில்லை. ஒன்றுக்கு மேற்பட்ட மொழிகளில் நீங்கள் மக்களுக்குச் சேவை செய்கிறீர்கள் என்றால், அதற்கான தீர்வு "ChatGPT இல் பிரதியிட்டு ஒட்டுவது (paste)" அல்ல; அல்லது "ஒரு சரியான மாதிரி அமைப்பு (perfect model) வரும் வரை காத்திருப்பதும்" அல்ல. அதற்கான தீர்வு ஒரு முழுமையான இயந்திரக் கட்டமைப்பு (engine): ஒரேயொரு அதிகாரப்பூர்வ மூலம் (one authoritative source), ஒவ்வொரு மொழிக்கும் துறைக்கும் அளவிடப்பட்ட பெறுபேறுகளின் அடிப்படையில் தேர்ந்தெடுக்கப்பட்ட மாதிரி அமைப்புகளின் தொகுப்பு (model pool), முதலாவது மாதிரியை மறுஆய்வு செய்யும் இரண்டாவது மாதிரி, சொற்களை மாறாமல் ஒரே சீராக வைத்திருக்கும் கலைச்சொல் வங்கி (terminology bank) மற்றும் மொழிபெயர்ப்பு நினைவகம் (translation memory), ஒவ்வொரு படியையும் யார் எதைக்கொண்டு செய்தார்கள் என்பதைப் பதிவு செய்யும் தணிக்கைப் பதிவு (audit log), மற்றும் வாசித்து கையொப்பமிடும் ஒரு மனிதர். ஒருமுறை மொழிபெயருங்கள், ஒருமுறை சரிபாருங்கள், எங்கும் வெளியிடுங்கள். பல மாடல்களைப் பயன்படுத்துங்கள். அர்த்தத்தை உறுதிப்படுத்துங்கள். மனிதக் கட்டுப்பாட்டை நிலைநிறுத்துங்கள்.
ஒரு பயிற்சி மண்டபத்தில் இருந்தே எனது உரையாடலைத் தொடங்குகிறேன்.
கடந்த ஒரு வருடத்தில், யாழ்ப்பாணம் முதல் மாத்தறை வரை இலங்கை முழுவதிலும் உள்ள பத்தாயிரத்திற்கும் மேற்பட்ட அரச அதிகாரிகளுடன் அமர்ந்து, உற்பத்திசார் AI (Generative AI) பற்றி நான் கலந்துரையாடியுள்ளேன். ஏறக்குறைய ஒவ்வொரு மண்டபத்திலும், முன்கூட்டியோ அல்லது பின்னரோ, யாராவது ஒருவர் கையை உயர்த்தி இதே கேள்வியைக் கேட்கிறார்கள்: "சேர், நாங்கள் ChatGPT இல் சிங்களத்தில் அல்லது தமிழில் ஏதாவது கேட்டால், சில வேளைகளில் முரண்பாடான அபத்தங்கள் வருகின்றன. ஆனால் ஆங்கிலத்தில் கேட்டால் விடை மிகச் சிறப்பாக இருக்கிறது. ஏன் அப்படி?"
அது மிகவும் நியாயமான கேள்வி, அத்தோடு அது அரசாங்கத்திற்கு மட்டுமேயான கேள்வியும் அல்ல. ஒரு வங்கி தனது வாடிக்கையாளர் கடிதங்களில் இதே பிரச்சினையை எதிர்கொள்கிறது. ஒரு மருத்துவமனை தனது சம்மதப் படிவங்களில் (consent forms) இதையே எதிர்கொள்கிறது. ஒரு பாடசாலை பெற்றோரின் வீடுகளுக்கு அனுப்பும் அறிவித்தல் கடிதத்திலும் இதே பிரச்சினை உள்ளது. வெவ்வேறு மொழிகளை வாசிக்கும் மக்களுக்கு ஒரே விடயத்தைத் துல்லியமாகக் கூற வேண்டிய எந்தவொரு நிறுவனத்திற்கும் இந்தப் பிரச்சினை உண்டு. இலங்கையைப் பொறுத்தவரை இதை ஒருபோதும் புறக்கணிக்க முடியாது; ஏனெனில் நமது அரசியலமைப்பு சிங்களத்தையும் தமிழையும் அரச கரும மொழிகளாகவும், ஆங்கிலத்தை இணைப்பு மொழியாகவும் பிரகடனப்படுத்தியுள்ளது. இங்கு மூன்று மொழிகள் என்பது ஒரு விருப்பத் தெரிவு அல்ல. அது சட்டம்; அதைவிட முக்கியமாக, அது சமத்துவமும் நீதியுமாகும்.
எனவே இந்தக் கட்டுரையில் நான் பதிலளிக்க விரும்பும் கேள்வி நடைமுறை சார்ந்தது: உற்பத்திசார் AI ஐக் குருட்டுத்தனமாக நம்பாமல், பன்மொழி வேலைகளுக்காக அதனைப் பயன்படுத்தும் ஓர் இயந்திரக் கட்டமைப்பை (engine) எவ்வாறு உருவாக்குவது?
சரி, அதை ஒவ்வொரு கேள்வியாக விரிவாகப் பார்ப்போம்.
1. "AI மூலம் சாதாரணமாக மொழிபெயர்ப்பது" ஒரு முழுமையான அமைப்பாக (engine) மாறாதது ஏன்?
எவ்வித சரிபார்ப்புமின்றி, ஒரேயொரு மாடலை ஒருமுறை மட்டும் பயன்படுத்தும்போது, அது மூன்று வழிகளில் அமைதியாகத் தோல்வியடைகிறது:
பொருளில் ஏற்படும் விலகல் (It drifts in meaning). ஒரு மாதிரி அமைப்பு உண்மையில் மொழிபெயர்ப்பதில்லை; அது அடுத்ததாக வரக்கூடிய அதிக சாத்தியமுள்ள சொற்களை மட்டுமே கணிக்கிறது. பெரும்பாலான நேரங்களில் அது சரியான பொருளைத் தருகிறது. ஆனால் சில நேரங்களில், வாசிப்பதற்கு மிக அழகாக இருக்கும், ஆனால் மூலப் பொருளிலிருந்து சற்று மாறுபட்ட வாக்கியத்தை உருவாக்கிவிடுகிறது. ஒரு கவிதையில் அது ரசிக்கத்தக்கதாக இருக்கலாம். ஆனால் ஒரு காணி அனுமதிப்பத்திரத்தில் (land permit), மருந்துச் சீட்டில், அல்லது சலுகை உரித்துடைமை விதியில் (benefit eligibility rule), அது பெரும் பாதிப்பை ஏற்படுத்தும்.
கலைச்சொற்களில் சீரின்மை (It is inconsistent with terms). திங்கட்கிழமை ஒரு குறிப்பிட்ட மாடலிடம் "Divisional Secretariat" (பிரதேச செயலகம்) என்பதை மொழிபெயர்க்கச் சொல்லுங்கள்; மீண்டும் வியாழக்கிழமை அதையே கேளுங்கள்; அது இரண்டு வெவ்வேறு மொழிபெயர்ப்புகளைத் தரக்கூடும். ஆயிரம் ஆவணங்கள் முழுவதும் இது நிகழும்போது, உங்கள் பிரஜைகளோ அல்லது வாடிக்கையாளர்களோ ஒவ்வொரு பக்கத்திலும் வெவ்வேறு சொல்வழக்குகளை வாசிக்க நேரிடும்.
அது மிகவும் தடையின்றி மாயைகளை (hallucinations) உருவாக்குகிறது. 2025 ஆம் ஆண்டில், டெலாய்ட் ஆஸ்திரேலியா (Deloitte Australia) நிறுவனம் ஆஸ்திரேலிய அரசாங்கத்திற்காகத் தயாரித்த ஓர் அறிக்கையின் கட்டணத்தில் ஒரு பகுதியைத் திருப்பிச் செலுத்த வேண்டியதாயிற்று. ஏனெனில், அதில் போலியான நீதிமன்ற மேற்கோள்களும், நடைமுறையில் இல்லாத ஆய்வுக் கட்டுரைகளின் குறிப்புகளும் இடம்பெற்றிருந்ததை ஆராய்ச்சியாளர்கள் கண்டுபிடித்தனர். இங்கு எவரும் திட்டமிட்டு ஏமாற்ற நினைக்கவில்லை. ஒரு திறமையான மாடல் மிகுந்த தன்னம்பிக்கையுடன் உரையை உருவாக்கியது; ஆனால் அது வெளியிடப்படுவதற்கு முன்பு எவரும் அதை ஆழமாக வாசித்துப் பார்க்கவில்லை. மொழிபெயர்ப்பிலும் இதுவேதான் நிகழ்கிறது; ஒரே வித்தியாசம், அனுமதி வழங்கும் அதிகாரிக்கு வாசிக்கத் தெரியாத ஒரு மொழியில் அது நிகழ்கிறது.
மேலும், நமது மொழிகளுக்கே உரிய நான்காவது பலவீனமும் இதில் உண்டு. இந்த மாதிரி அமைப்புகள் பெருமளவில் ஆங்கிலத்திலேயே பயிற்றுவிக்கப்பட்டுள்ளன. உலகெங்கிலும் உள்ள கோடிக்கணக்கான தமிழ் பேசும் மக்கள் இணையத்தில் பெருமளவிலான உள்ளடக்கங்களை எழுதியுள்ளதால், தமிழ் மொழி ஒப்பீட்டளவில் சிறந்த தரவைப் பெற்றுள்ளது. ஆனால் சிங்கள மொழி பேசுவோர் சுமார் இரண்டு கோடி பேர் மட்டுமே, அவர்கள் அனைவரும் இங்கேயே வாழ்கின்றனர்; மேலும் நாம் இணையத்தில் பதிவேற்றியுள்ள சிங்களத் தரவுகள் மிகக் குறைவு. வணிக மொழி மாடல்கள் பற்றிய ஆய்வுகள் காட்டுவது என்னவென்றால், பல மொழிகளைப் பேசுவோர் ஒரு வாக்கியத்திற்கு அதிக கட்டணம் செலுத்துகிறார்கள் (உரை அதிக டோக்கன்களாகப் பிரிவதால்), ஆனால் அதற்குப் பதிலாகக் குறைந்த தரத்திலான முடிவுகளையே பெறுகிறார்கள். இலங்கை ஆராய்ச்சியாளர்களால் உருவாக்கப்பட்ட சமீபத்திய மதிப்பீட்டு அளவுகோல்களும் (benchmarks) இதையே காட்டுகின்றன: ஆங்கிலத்தில் மிகச் சிறப்பாகச் சிந்திக்கும் மாடல்கள், அதே வினாவை நேரடியாகச் சிங்களத்திலோ அல்லது தமிழிலோ கேட்கும்போது குறிப்பிடத்தக்க அளவில் தடுமாறுகின்றன.
எளிய வார்த்தைகளில் சொல்வதானால்: ஒட்டுமொத்தமாகச் சிறந்த ஒரு மாடல், உங்கள் மொழியில், உங்கள் துறையில், உங்கள் ஆவண வகைக்குச் சிறந்ததாக இருக்க வேண்டிய அவசியமில்லை. இதனால்தான் நமக்கு ஓர் இயந்திரக் கட்டமைப்பு (engine) தேவைப்படுகிறது.
2. அந்த இயந்திரக் கட்டமைப்பு உண்மையில் எப்படி இயங்குகிறது?
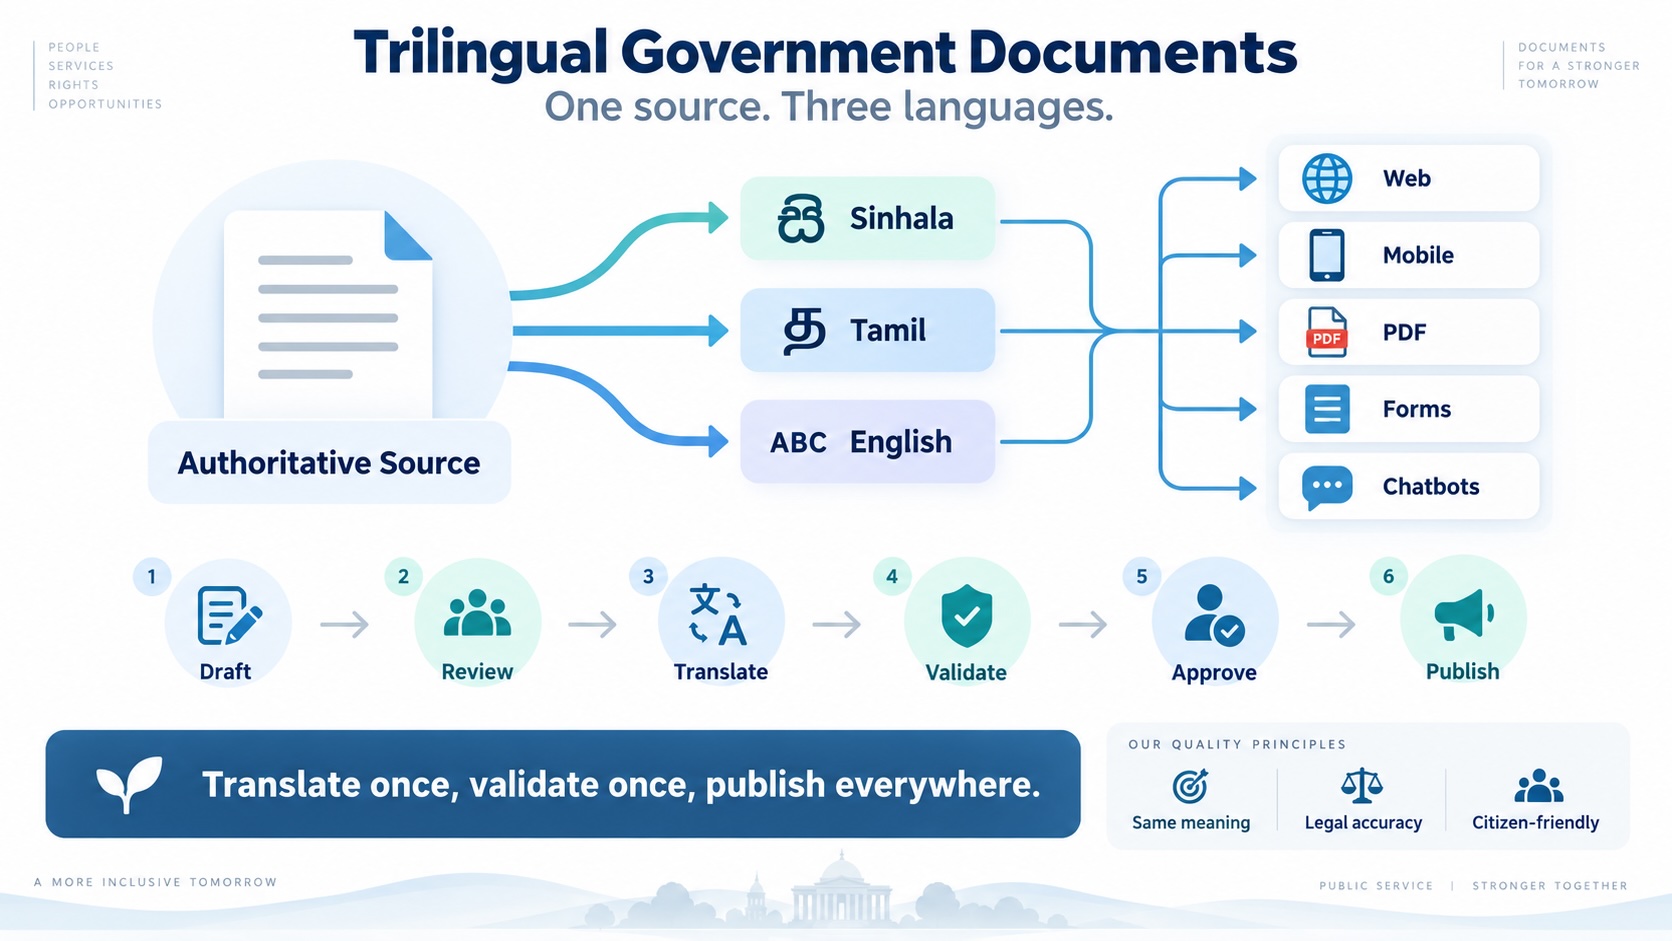
மேலே உள்ள முதலாவது வரைபடத்திலிருந்து தொடங்குவோம். முழுமையான சிந்தனையையும் ஒரே வரியில் சுருக்கிவிடலாம்: ஒருமுறை மொழிபெயருங்கள், ஒருமுறை சரிபாருங்கள், எங்கும் வெளியிடுங்கள் (translate once, validate once, publish everywhere).
இங்கு ஒரேயொரு அதிகாரப்பூர்வ மூலம் (authoritative source) மட்டுமே உள்ளது. யாரோ ஒருவர் ஒரே மாதிரியாக இருக்கும் என்று நம்பும் மூன்று வெவ்வேறு ஆவணங்கள் அல்ல; ஒரு மொழியில் எழுதப்பட்ட, உண்மைக்கு அடிப்படையான ஒரேயொரு ஆவணம். மற்றைய அனைத்துப் பதிப்புகளும் இதிலிருந்தே பெறப்படுகின்றன; மூல ஆவணத்தில் மாற்றம் ஏற்படும் போது, ஏனைய பதிப்புகளும் அதற்கேற்ப உடனுக்குடன் புதுப்பிக்கப்படுகின்றன.
அந்த மூலத்திலிருந்து, இந்த இயந்திரக் கட்டமைப்பு சிங்களம், தமிழ் மற்றும் ஆங்கிலப் பதிப்புகளை உருவாக்குகிறது. அந்தப் பதிப்புகளிலிருந்தே அனைத்துத் தளங்களும் உள்ளடக்கத்தைப் பெறுகின்றன: இணையதளம், கைபேசிச் செயலி (mobile app), PDF ஆவணம், அச்சிடப்பட்ட படிவம், மற்றும் சாட்போட் (chatbot). இங்கு சாட்போட் தன்னிச்சையாக உடனக்குடன் மொழிபெயர்த்து தனக்கென ஒரு புதிய பதிப்பை உருவாக்கிக்கொள்வதில்லை. அது ஏற்கனவே அங்கீகரிக்கப்பட்ட அதிகாரப்பூர்வப் பதிப்பையே வாசிக்கிறது.
இந்த வழித்தொடர் (pipeline) ஆறு படிகளைக் கொண்டுள்ளது; இதில் ஒவ்வொரு படியும் வெறும் சம்பிரதாயம் அல்ல, மாறாக ஒரு பாதுகாப்புக் கதவு (gate) ஆகும்:
- வரைவு தயாரித்தல் (Draft). மூல ஆவணத்தை ஒரு மனிதர் எழுதுகிறார்.
- மறுஆய்வு (Review). மூல ஆவணத்தை ஒரு மனிதர் சரிபார்க்கிறார். பலவீனமான ஒரு மூல ஆவணத்தை வைத்துக்கொண்டு சரியான மொழிபெயர்ப்பைப் பெற முடியாது.
- மொழிபெயர்ப்பு (Translate). மாதிரி அமைப்புகள் கடினமான சுமையை இங்கு ஏற்கின்றன. ஆறு நாட்கள் எடுக்கக்கூடிய சலிப்பூட்டும் தொடர் வேலை ஒரு நாளாக மாறுவது இங்குதான்.
- உறுதிப்படுத்தல் (Validate). மூலத்தின் அர்த்தம், கலைச்சொற்கள் மற்றும் சட்ட அர்த்தம் ஆகியவை இரண்டாவது மாதிரி அமைப்பாலும் ஒரு மனிதராலும் சரிபார்க்கப்படுகின்றன.
- அங்கீகாரம் (Approve). பெயர் குறிப்பிடப்பட்ட ஒரு மனிதர் கையொப்பமிடுகிறார். முழு இயந்திரக் கட்டமைப்பின் உச்சக்கட்ட நோக்கமே இந்தக் கையொப்பம்தான்.
- வெளியீடு (Publish). ஒரே அர்த்தத்துடன், சரியான பதிப்பு எண்களுடன் (versioned) மூன்று மொழிப் பதிப்புகளும் ஒரே நேரத்தில் வெளியிடப்படுகின்றன.
இந்த வழித்தொடரின் அடிப்படையாக மூன்று தரக் கோட்பாடுகள் இயங்குகின்றன; இவற்றை சுவரில் அச்சிட்டு மாட்டி வைக்குமாறு நான் பரிந்துரைப்பேன்: ஒரே அர்த்தம் (same meaning), சட்டத் துல்லியம் (legal accuracy), பிரஜைகளுக்கு உகந்த தன்மை (citizen-friendly). நீங்கள் அரசாங்கம் அல்ல என்றால்: ஒரே அர்த்தம், உங்கள் துறைக்குரிய துல்லியம், மற்றும் உங்கள் வாடிக்கையாளர்கள் இயல்பாகப் பேசும் மொழியில் எழுதுதல்.
3. ஒன்றுக்கு மேற்பட்ட மாதிரி அமைப்புகளைப் பயன்படுத்துவது ஏன்?
பெரும்பாலான குழுக்கள் தவிர்க்கும் பகுதி இதுதான்; ஆனால் இந்த இயந்திரக் கட்டமைப்பை நம்பகமானதாக மாற்றுவதும் இதுவேயாகும்.
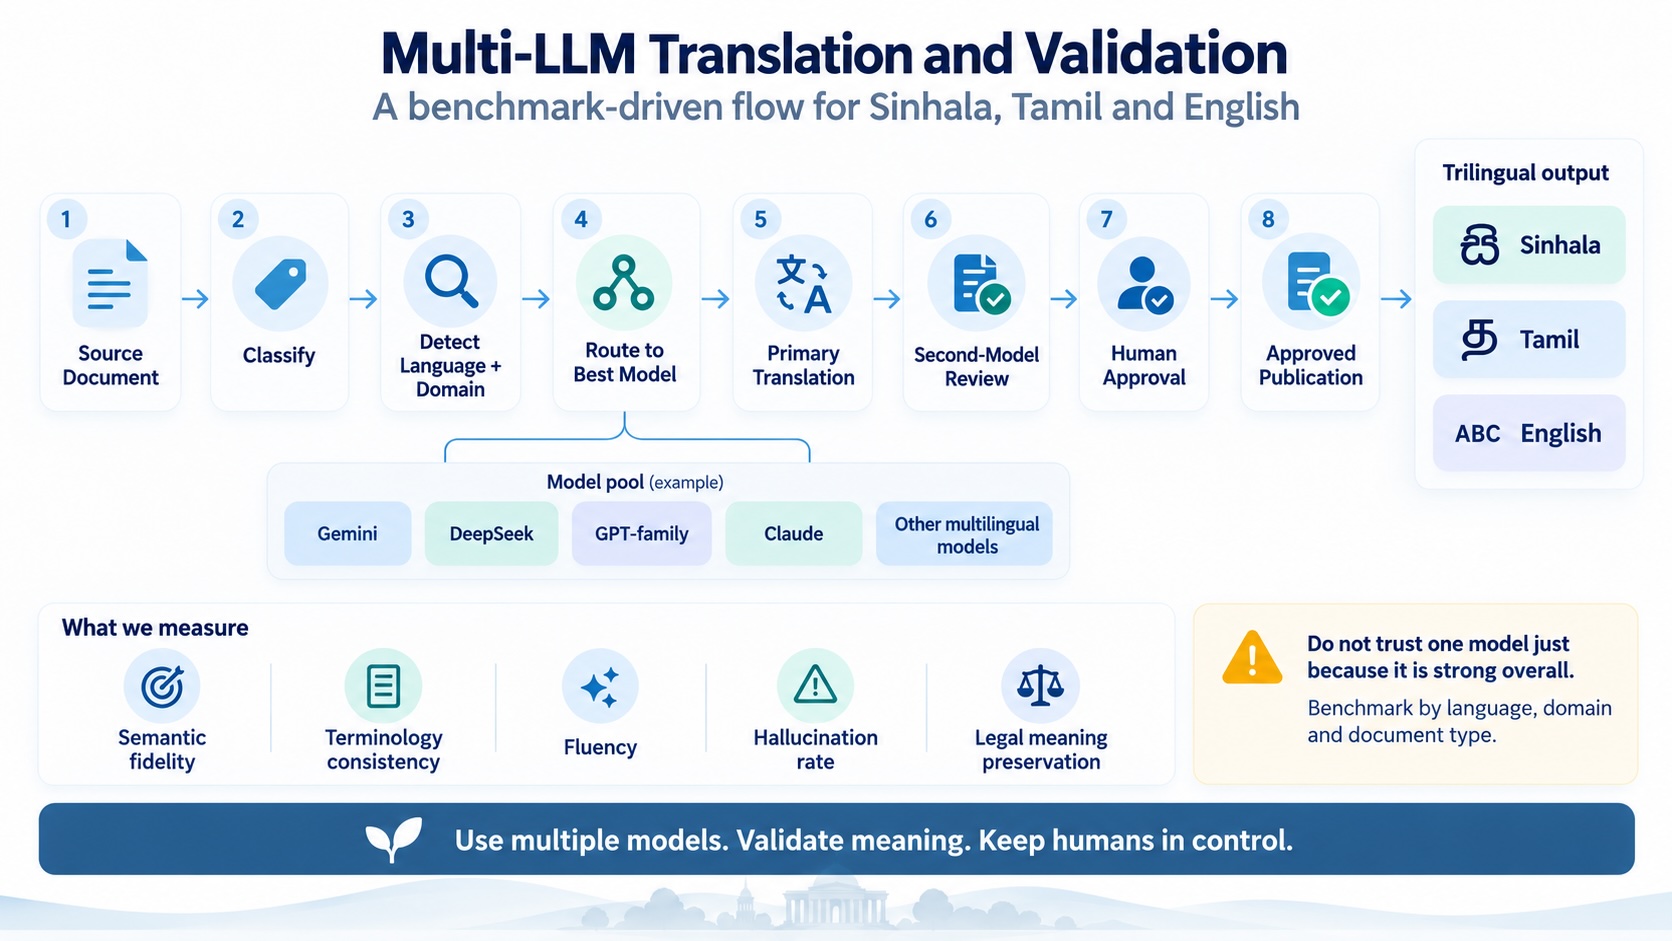
மேலே உள்ள இரண்டாவது வரைபடத்தைப் பாருங்கள். "மூல ஆவணத்திற்கும்" "அங்கீகரிக்கப்பட்ட வெளியீட்டிற்கும்" இடையில், ஒற்றை மாதிரி அமைப்பில் இல்லாத இரண்டு முக்கிய விடயங்கள் உள்ளன: மாதிரியைத் தேர்ந்தெடுக்கும் வழிகாட்டி (router), மற்றும் முதலாவது மாதிரியை மறுஆய்வு செய்யும் இரண்டாவது மாதிரி (second model).
வழிகாட்டி (The router). எதையும் மொழிபெயர்ப்பதற்கு முன்னர், இந்த இயந்திரம் ஆவணத்தை வகைப்படுத்துகிறது; அதன் மொழியையும் துறையையும் (domain) கண்டறிகிறது; பின்னர் அந்த இணைப்பிற்கு மிகச் சிறந்த பெறுபேறுகளைத் தந்த மாடலைத் தேர்ந்தெடுக்கிறது. சந்தையில் பிரம்மாண்டமாக அறிமுகப்படுத்தப்பட்ட மாடல் என்பதற்காக அல்ல; உங்கள் மதிப்பீட்டு அளவுகோலில் (benchmark), இந்த மொழிக்காக, இந்தத் துறையில், இந்த ஆவண வகைக்கு அதிக புள்ளிகளைப் பெற்ற மாடலையே அது தெரிவு செய்கிறது. எனது சொந்தப் பயிற்சி அமர்வுகளில், ஜெமினி (Gemini) மாடல் தனது அமெரிக்கச் சகாக்களை விடச் சிங்கள இலக்கணத்தை மிக இயல்பாகக் கையாள்வதை நான் பார்த்திருக்கிறேன். ஏனெனில் கூகுள் இருபது ஆண்டுகளுக்கும் மேலாகச் சிங்கள மற்றும் தமிழ் இணையப் பக்கங்களைத் தன் சுட்டகத்தில் (indexing) சேர்த்துள்ளது. டீப்ஸீக் (DeepSeek) மாடல் சரளமான சிங்களத்தால் அரங்கையே வியப்பில் ஆழ்த்துவதை நான் கண்டிருக்கிறேன்; ஏனெனில் அது சீன மொழி மற்றும் ஆங்கிலம் அல்லாத பரந்த தரவுகளில் ஆழமாகப் பயிற்றுவிக்கப்பட்டுள்ளது. கிளாட் (Claude) மாடல் ஆங்கிலத்தில் மிகவும் நேர்த்தியான சட்ட வரைவுகளை உருவாக்குவதை நான் கவனித்திருக்கிறேன். இந்த அவதானிப்புகள் எதுவும் இறுதித் தீர்ப்புகள் அல்ல. அவை வெறும் கருதுகோள்கள் மட்டுமே; முறையான மதிப்பீட்டு அளவுகோலே (benchmark) இறுதி முடிவை எடுக்கிறது.
மாதிரிகளின் தொகுப்பு (The pool). எனவே இந்த இயந்திரக் கட்டமைப்பு மாடல்களின் ஒரு தொகுப்பைக் கொண்டுள்ளது: Gemini, DeepSeek, GPT குடும்பம், Claude, மற்றும் அடுத்த வருடம் வரவிருக்கும் ஆற்றல்மிக்க எந்தவொரு பன்மொழி மாடலும் இதில் அடங்கும். மாடல்கள் தொடர்ந்து மாறிக்கொண்டே இருப்பதால், இந்தத் தொகுப்பே நமது பலமாக மாறுகிறது. ஒரு புதிய மாடல் வரும்போது, நீங்கள் முழு அமைப்பையும் புதிதாக உருவாக்க வேண்டியதில்லை. நீங்கள் அதை அளவீடு செய்து சோதிக்கிறீர்கள்; தமிழ் சட்ட அறிவித்தல்களுக்கு அது வெற்றி பெற்றால், வழிகாட்டி அமைப்பு தமிழ் சட்ட அறிவித்தல்களை உடனடியாக அந்த மாடலுக்கு அனுப்பத் தொடங்கும்.
இரண்டாவது மாடலின் மறுஆய்வு (The second-model review). ஆரம்ப மொழிபெயர்ப்பிற்குப் பிறகு, வேறுபட்ட ஒரு மாடல் மூலத்தையும் மொழிபெயர்ப்பையும் அருகருகே வைத்து வாசித்து, துல்லியமான சில கேள்விகளை எழுப்புகிறது: இந்த வாக்கியம் மூல வாக்கியத்தின் அதே அர்த்தத்தைத் தருகிறதா? அங்கீகரிக்கப்பட்ட கலைச்சொல் வங்கியிலிருந்து ஏதேனும் சொல் விலகியுள்ளதா? மூலத்தில் இல்லாத ஒன்று புதிதாகச் சேர்க்கப்பட்டுள்ளதா? இரண்டு வெவ்வேறு மாதிரி அமைப்புகள் ஒரே இடத்தில் ஒரே தவறைச் செய்வது மிகவும் அரிது. ஒற்றை மாடலால் கவனிக்கப்படாமல் நழுவிப்போகும் தவறுகளை இந்த மறுஆய்வு பிடித்துவிடுவது இதனால்தான்.
உண்மையில், எனது சொந்தப் பொறியியல் வாழ்க்கையில் நான் கடைப்பிடிக்கும், ஒவ்வொரு பயிற்சி அமர்விலும் நான் கற்பிக்கும் பழக்கமும் இதுவேதான். நான் ஒரு கருவியைக் கொண்டு உண்மைகளைச் சேகரிக்கிறேன்; இரண்டாவது கருவி மூலம் பிராம்ப்ட்டை (prompt) விரிவுபடுத்திக் கூர்மையாக்குகிறேன்; மூன்றாவது கருவியைக் கொண்டு வரைவை உருவாக்குகிறேன்; பின்னர் கையொப்பமிடுவதற்கு முன்பு ஒவ்வொரு வரியையும் நானே வாசித்துப் பார்க்கிறேன். இந்த இயந்திரக் கட்டமைப்பு அந்த ஒழுக்கமுறையை ஒரு முறையான, மீண்டும் மீண்டும் செய்யக்கூடிய (repeatable) அமைப்பாக மாற்றுகிறது; இதனால் அது ஒரு தனிநபரின் அன்றைய மனநிலையை மட்டுமே சார்ந்து இருப்பதில்லை.
நாம் எவற்றை அளவிடுகிறோம்? ஒரு மதிப்பீட்டு அளவுகோல் (benchmark) என்பது அதன் அளவீட்டு அளவுகோல்கள் எவ்வளவு நேர்மையானவையோ அவ்வளவு நேர்மையானது. இந்த இயந்திரம் ஐந்து பண்புகளைக் கண்காணிக்கிறது:
- அர்த்த உண்மைத்தன்மை (Semantic fidelity). மொழிபெயர்ப்பு மூலத்தின் உண்மையான அர்த்தத்தையே தருகிறதா?
- கலைச்சொல் சீர்மை (Terminology consistency). அங்கீகரிக்கப்பட்ட சொற்கள் ஒவ்வொரு முறையும் ஒரே மாதிரியாகப் பயன்படுத்தப்பட்டுள்ளனவா?
- சரளத்தன்மை (Fluency). இயந்திரத்தால் மொழிபெயர்க்கப்பட்டதைப் போலன்றி, அந்த மொழியைத் தாய்மொழியாகக் கொண்ட ஒருவர் எழுதியது போன்ற இயல்பான நடையில் உள்ளதா?
- மாயை உருவாக்கும் வீதம் (Hallucination rate). மூலத்தில் இல்லாத விடயங்கள் எவ்வளவு அடிக்கடி தோன்றுகின்றன?
- சட்ட அர்த்தப் பாதுகாப்பு (Legal meaning preservation). ஒழுங்குபடுத்தப்பட்ட ஆவணங்களுக்கு, பொறுப்புகள், உரிமைகள் அல்லது காலக்கெடு மாறாமல் முழுமையாகப் பாதுகாக்கப்பட்டுள்ளதா?
உங்கள் சொந்த நிறுவன ஆவணங்களைக் கொண்டு, அந்த மொழிகளைத் தாய்மொழியாகக் கொண்ட மதிப்பீட்டாளர்களைக் கொண்டு, ஒவ்வொரு மொழி மற்றும் துறை இணைப்பிற்கும் இந்த ஐந்து அளவுகோல்களின் கீழ் ஒவ்வொரு மாடலையும் மதிப்பிடுங்கள். அதன் பின்னர் கிடைக்கும் எண்களின் அடிப்படையில் பணிகளை வழிநடத்துங்கள். ஒட்டுமொத்தமாக ஒரு மாடல் பலமானது என்பதற்காக மட்டுமே அதை ஒருபோதும் குருட்டுத்தனமாக நம்பாதீர்கள்.
4. இந்த இயந்திரக் கட்டமைப்பைப் பாதுகாப்பாகவும் கட்டுப்பாட்டுடனும் வைத்திருப்பது எது?
இப்போது மூன்றாவது வரைபடத்தைப் பாருங்கள் — ஒருங்கிணைந்த நுழைவாயில் (the gateway). ஒரு நிறுவனம் நடைமுறையில் செயல்படுத்தக்கூடிய மாதிரி இதுவேயாகும்.
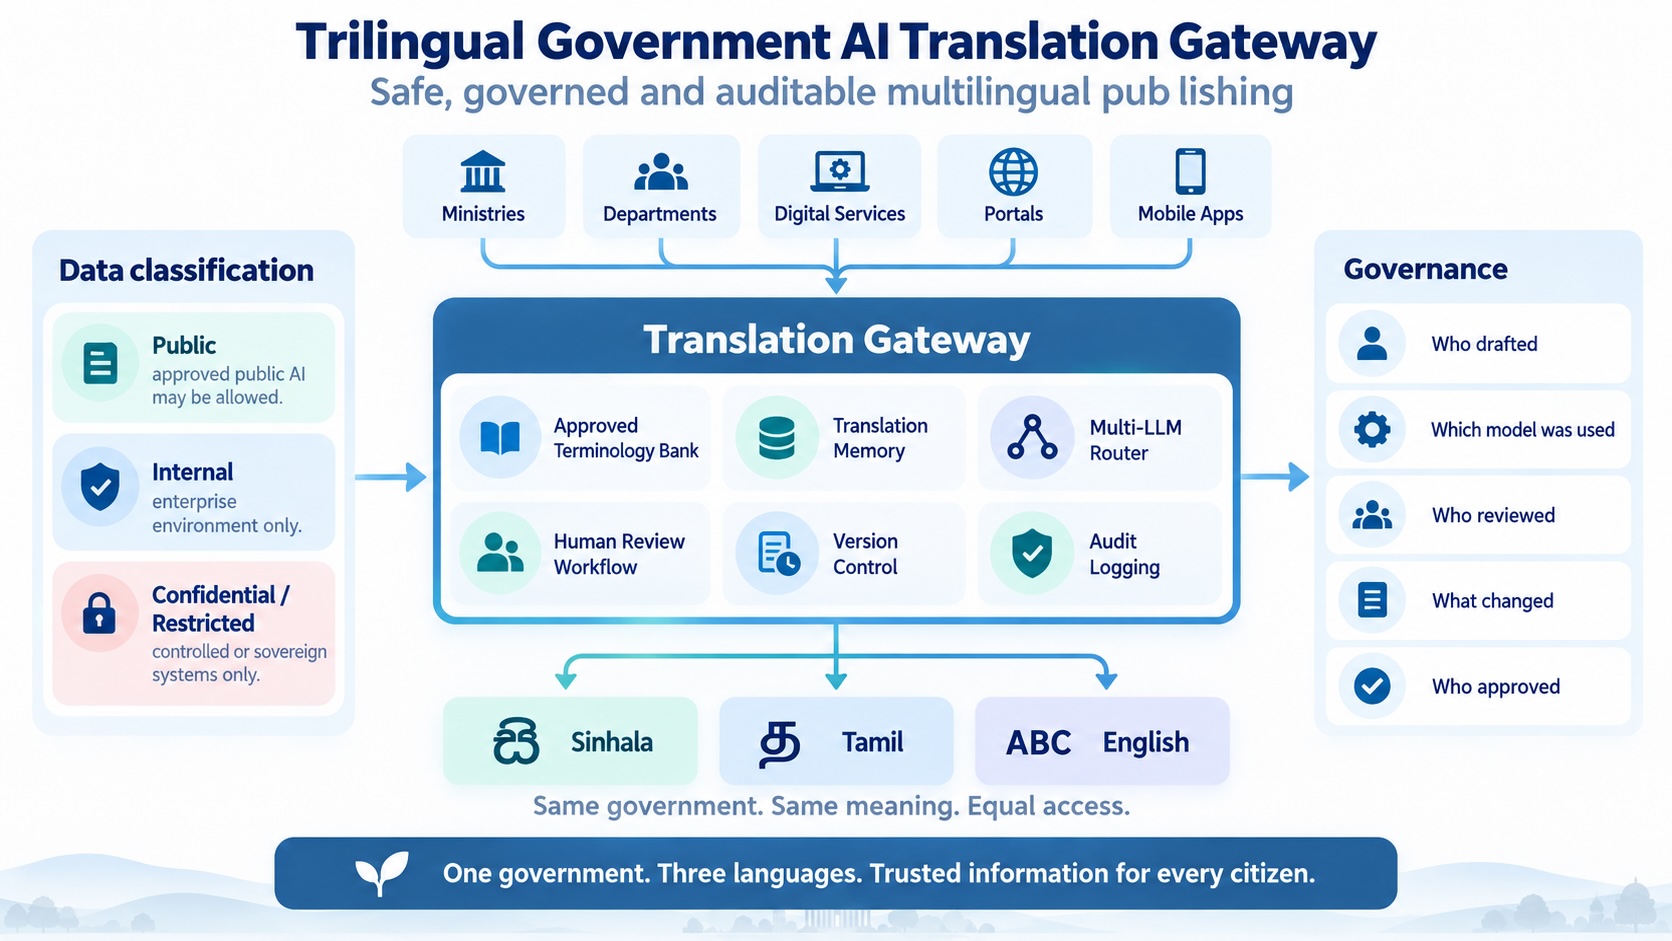
ஒவ்வொரு குழுவும் தங்கள் தனிப்பட்ட தொலைபேசியில் உள்ள இலவச செயலிகளில் உரையைத் தட்டச்சு செய்து மொழிபெயர்ப்பதற்குப் பதிலாக, ஒவ்வொரு அமைச்சகமும், திணைக்களமும், சேவையும், செயலியும் தங்கள் ஆவணங்களை ஒரேயொரு ஒருங்கிணைந்த நுழைவாயில் (one gateway) ஊடாகவே அனுப்புகின்றன. அந்த ஒற்றைக் கதவுதான் மற்ற அனைத்தையும் சாத்தியமாக்குகிறது. அதற்குள் ஆறு பிரதான கூறுகள் இயங்குகின்றன:
- அங்கீகரிக்கப்பட்ட கலைச்சொல் வங்கி (An approved terminology bank). உங்கள் நிறுவனம் பயன்படுத்தும் ஒவ்வொரு சொல்லுக்கும் அதிகாரப்பூர்வ சிங்களம், தமிழ் மற்றும் ஆங்கில வடிவங்கள் மனிதர்களால் பராமரிக்கப்பட்டு, மாடல்களுக்குக் கட்டாயமாக்கப்படுகின்றன. "திங்கட்கிழமை ஒரு சொல்லும் வியாழக்கிழமை வேறு சொல்லும்" வரும் பிரச்சினைக்கு இதுவே முற்றுப்புள்ளி வைக்கிறது.
- மொழிபெயர்ப்பு நினைவகம் (A translation memory). ஏற்கனவே அங்கீகரிக்கப்பட்ட வாக்கியங்கள் மீண்டும் மீண்டும் மொழிபெயர்க்கப்படாமல், நேரடியாகவே மீண்டும் பயன்படுத்தப்படுகின்றன. இது செலவை மிச்சப்படுத்துகிறது; மிக முக்கியமாக, அங்கீகரிக்கப்பட்ட ஒரு வாக்கியம் அடுத்த மாதம் சிறிய மாற்றத்துடன் தவறாக மறுஉருவாக்கம் செய்யப்படுவதைத் தடுக்கிறது.
- முந்தைய பகுதியில் விவரிக்கப்பட்ட பல-LLM வழிகாட்டி (The multi-LLM router).
- மனித மறுஆய்வுப் பணிப்பாய்வு (A human review workflow). ஒவ்வொரு மொழிக்கும் பெயரிடப்பட்ட மதிப்பீட்டாளர்கள், மூலத்தையும் மொழிபெயர்ப்பையும் அருகருகே வைத்து, இரண்டாவது மாடலின் கண்டுபிடிப்புகளையும் தங்கள் கண்முன்னே வைத்துச் சரிபார்க்கிறார்கள்.
- பதிப்புக் கட்டுப்பாடு (Version control). ஒவ்வொரு பதிப்பும் மூல ஆவணத்தின் ஒரு குறிப்பிட்ட பதிப்புடன் இணைக்கப்பட்டுள்ளது. மூலத்தில் மாற்றம் ஏற்படும் போது, தற்போது காலாவதியான பதிப்புகள் எவை என்பதை இந்த இயந்திரம் உடனடியாக அடையாளம் காண்கிறது.
- தணிக்கைப் பதிவு (Audit logging). வெளியிடப்படும் ஒவ்வொரு வாக்கியத்திற்கும்: யார் வரைவு செய்தார், எந்த மாடல் மொழிபெயர்த்தது, யார் மறுஆய்வு செய்தார், பதிப்புகளுக்கிடையில் என்ன மாற்றப்பட்டது, மற்றும் யார் அங்கீகரித்தார் என்ற விபரங்கள் பதிவாகின்றன. ஒரு பிரஜையோ அல்லது நீதிமன்றமோ "தமிழில் ஏன் இவ்வாறு குறிப்பிடப்பட்டுள்ளது?" என்று கேட்டால், ஒரு மாதத்திற்குப் பதிலாக ஒரே நிமிடத்தில் உங்களால் பதிலளிக்க முடியும்.
இந்த நுழைவாயிலைச் சுற்றி தரவு வகைப்படுத்தல் (data classification) இயங்குகிறது; இது எந்தத் தரவு எங்கு செல்லலாம் என்பதைத் தீர்மானிக்கிறது:
- பொதுத் தகவல்கள் (Public): அங்கீகரிக்கப்பட்ட பொதுவான AI சேவைகளுக்கு அனுப்பப்படலாம்.
- உள்முகத் தகவல்கள் (Internal): தரவுத் தக்கவைப்பு இல்லாத (no data retention) வணிக நிறுவனச் சூழலுக்குள் மட்டுமே இருக்கும்.
- இரகசியமான அல்லது கட்டுப்படுத்தப்பட்ட தகவல்கள் (Confidential or restricted): முழுமையான இறையாண்மை கொண்ட கட்டுப்பாட்டு அமைப்புகளுக்கு (sovereign systems) மட்டுமே செல்லும்; அல்லது எந்தவொரு மாதிரி அமைப்புக்கும் அனுப்பப்படாது.
இது ஏன் இவ்வளவு முக்கியமானது என்பதை நான் வெளிப்படையாகக் கூற விரும்புகிறேன். நான் செல்லும் ஒவ்வொரு அலுவலகத்திலும், அதிகாரிகள் ஏற்கனவே தங்கள் தனிப்பட்ட தொலைபேசிகளிலுள்ள இலவச AI கருவிகளுக்குக் கோப்புகளை அனுப்பிக் கொண்டிருக்கிறார்கள். கெட்ட நோக்கத்துடன் அல்ல; வேலைப்பளு தாங்க முடியாததாக இருக்கிறது, அந்தக் கருவி உதவுகிறது. அதைத் தடை செய்வதால் அது நின்றுவிடாது; மாறாக அது கண்களுக்குத் தெரியாமல் இரகசியமாக நிகழும். இந்த நுழைவாயில் என்பது உத்தியோகபூர்வமாக அனுமதிக்கப்பட்ட பாதுகாப்பான வழியாகும். இது இவ்வாறு கூறுகிறது: இதோ பாதுகாப்பான வழி, மற்றும் இதோ நீங்கள் இதன் மூலம் அனுப்பக்கூடிய மற்றும் அனுப்பக்கூடாத விடயங்கள்.
5. மனிதர்களின் பங்கு எங்கு நிலைத்திருக்கிறது?
மனிதத் தீர்மானமும் நுண்ணறிவும் வாழும் ஒவ்வொரு இடத்திலும் மனிதர்கள் நிலைத்திருக்க வேண்டும்.
இந்த இயந்திரம் கடினமான, சலிப்பூட்டும் பகுதியை எடுத்துக்கொள்கிறது: மொழிபெயர்ப்பின் முதல் வரைவு, கலைச்சொல் சீர்மைச் சரிபார்ப்பு, அருகருகே வைத்து ஒப்பிடுதல், மற்றும் பதிவுகளைப் பராமரித்தல். ஒரு வாரத்தில் ஆறு நாட்களை விழுங்கிய வேலை அதுவேயாகும். அது மனிதர்களுக்குத் திருப்பித் தருவது, ஒரு மனிதரால் மட்டுமே செய்யக்கூடிய பணிக்கான பொன்னான நேரமாகும்.
சிங்களம் உண்மையிலேயே சிங்களத்தைப் போலவும், தமிழ் உண்மையிலேயே தமிழைப் போலவும் ஒலிக்கிறதா என்பதை இன்னமும் தீர்மானிப்பது ஒரு தாய்மொழி வாசகரே ஆவார். இந்த மாதத்தில் எனது சொந்த நிறுவனத்திலேயே நான் இந்த அனுபவத்தைக் கற்றுக்கொண்டேன். க.பொ.த சாதாரண தர (O/L) மாணவர்களுக்காக இலவச ஆங்கிலப் புத்தகத் தொடர் ஒன்றை நாங்கள் தயாரித்துக் கொண்டிருந்தோம்; அதன் ஆங்கிலத் தலைப்பு "English without the fear" என்பதாகும். அதற்காக மூன்று நேரடி மொழிபெயர்ப்புகள் எனக்கு வழங்கப்பட்டன; அவை மூன்றும் சரியானவை, சொல்-க்கு-சொல் துல்லியமானவை, ஆனால் முற்றிலும் உயிரற்றவை. அதற்குப் பதிலாக நான் எழுதியது: බය නැතුව ඉංග්රීසි පේපර් එකට ලියමු ("பயமின்றி ஆங்கில வினாத்தாளை எழுதுவோம்" / "let's write the English paper without fear") என்பதாகும். பரீட்சை வினாத்தாளுக்காக மாணவர்கள் அன்றாடம் பயன்படுத்தும் இயல்பான சொல்லை அது பயன்படுத்துகிறது; பேச்சு வழக்கில் உள்ளது; மேலும் வெறும் நிலையை விவரிப்பதற்குப் பதிலாக ஒரு செயலைச் செய்ய அழைப்பு விடுக்கிறது. எந்தவொரு AI மாடலும் இதை முன்மொழியவில்லை; ஏனெனில் இது ஆங்கிலத்தின் நேரடி மொழிபெயர்ப்பு அல்ல. வாசகரின் மொழியில் அது முற்றிலும் மாறுபட்ட ஒரு உளவியல் பணியைச் செய்கிறது. ஓர் இயந்திரத்தால் அத்தகைய முடிவை எடுக்க முடியாது. ஒரு மனிதர் அந்த முடிவை எடுப்பதற்கான களத்தை மட்டுமே அதனால் உருவாக்க முடியும்.
அங்கீகரிப்பவர் இன்னமும் கையொப்பமிடுகிறார். சிந்தனைத் தொடர் சுவடுகள் (chain-of-thought traces), இரண்டாவது மாதிரி மறுஆய்வுகள் மற்றும் தணிக்கைப் பதிவுகள் ஆகியவை கையொப்பமிடும் நபர் தாம் எதில் கையொப்பமிடுகிறார் என்பதைத் தெளிவாகப் பார்ப்பதற்காகவே உள்ளன. அவை கையொப்பத்தை அகற்றுவதற்காக உருவாக்கப்படவில்லை.
எல்லாவற்றிற்கும் மேலாக, ஒரு மும்மொழி ஆவணத்தின் உண்மையான நோக்கம் மூன்று கோப்புகள் இருப்பதே அல்ல. யாழ்ப்பாணத்தில் உள்ள ஒரு தமிழ் வாசகரும், மாத்தறையில் உள்ள ஒரு சிங்கள வாசகரும், கொழும்பில் உள்ள ஓர் ஆங்கில வாசகரும் ஒரே அர்த்தத்தையும் அதே உரிமைகளையும் பெறுவதே இதன் நோக்கமாகும். ஒரே அரசாங்கம். ஒரே அர்த்தம். சமத்துவமான அணுகல். ஓர் இயந்திரம் உங்களை அங்கு விரைவாக அழைத்துச் செல்ல உதவலாம். ஆனால் அதற்கான உத்தரவாதத்தை அதனால் உங்களுக்கு வழங்க முடியாது.
6. அமைச்சக அளவிலான பெரும் வரவுசெலவுத் திட்டம் இல்லாமல் தொடங்குவது எப்படி?
முதல் நாளிலேயே உங்களுக்கு முழுமையான நுழைவாயில் கட்டமைப்பு தேவையில்லை. உங்களுக்குத் தேவை சரியான பழக்கவழக்கங்கள் மட்டுமே:
- உங்கள் அனைத்து மொழிகளிலும் ஏற்கனவே நடைமுறையில் உள்ள, மனிதர்களால் அங்கீகரிக்கப்பட்ட ஐம்பது உண்மையான ஆவணங்களைத் தேர்ந்தெடுங்கள். அதுவே உங்கள் மதிப்பீட்டுத் தொகுப்பாகும் (benchmark set).
- முதலில் கலைச்சொல் வங்கியை எழுதுங்கள். இருநூறு சொற்கள், மூன்று மொழிகள், ஒவ்வொரு சொல்லுக்கும் ஒரேயொரு அங்கீகரிக்கப்பட்ட வடிவம். இது மிகவும் மலிவானது, மேலும் எந்தவொரு மாடலும் இயங்குவதற்கு முன்பே பாதியளவு பிழைகளை இது நீக்கிவிடும்.
- அந்த ஐம்பது ஆவணங்கள் ஊடாக மூன்று வெவ்வேறு மாடல்களை இயக்குங்கள். அந்தந்த மொழிகளைத் தாய்மொழியாகக் கொண்ட வாசகர்களைக் கொண்டு மேற்கூறிய ஐந்து அளவுகோல்களின் கீழ் அவற்றுக்குப் புள்ளியிடுங்கள். எந்த மொழிக்கு எந்த மாடல் வெற்றி பெறுகிறது என்பதைக் கண்டு நீங்கள் வியப்படைவீர்கள். அந்த முடிவுகளைப் பதிவு செய்யுங்கள்.
- நீங்கள் ஏற்கனவே வெளியிடும் ஆவணங்களுடன் இரண்டாவது மாடல் மறுஆய்வை இணையுங்கள். ஒரு வழிகாட்டி அமைப்பு இல்லாவிட்டாலும் கூட, முதலாவது மாடலைச் சரிபார்க்கும் இரண்டாவது மாடல் மூலப் பொருளில் ஏற்படும் கடுமையான விலகல்களைப் பிடித்துவிடும்.
- அனைத்தையும் பதிவு செய்யுங்கள் (Log everything). யார், எந்த மாடல், யார் மறுஆய்வு செய்தார், என்ன மாற்றப்பட்டது, யார் அங்கீகரித்தார் என்பதைப் பதிவு செய்யுங்கள். ஆரம்பத்தில் ஒரு எக்செல் விரிதாள் (spreadsheet) கூடப் போதுமானது. பழக்கவழக்கமே மிக முக்கியமானது.
- ஒவ்வொரு மொழியிலும் பெயரிடப்பட்ட மனிதரின் உத்தியோகபூர்வ அங்கீகாரமின்றி எதையும் வெளியிடாதீர்கள்.
இதை ஒரு காலாண்டு முழுவதும் செய்யுங்கள்; உங்களுக்கு ஓர் இயந்திரக் கட்டமைப்பு கிடைத்துவிடும். நீங்கள் அதிகப் பணம் கொடுத்து ஒன்றை வாங்கியதால் அல்ல; நீங்கள் அதற்கான ஒழுக்கத்தைக் கட்டமைத்துவிட்டீர்கள், மென்பொருள் வெறும் பின்தொடர்தலாக மட்டுமே அமையும்.
இவை அனைத்தையும் கூறிவிட்டு, நான் ஆரம்பித்த இடத்திலேயே — அந்தப் பயிற்சி மண்டபத்திலேயே இதை முடிக்க விரும்புகிறேன்.
சிங்களத்தில் அல்லது தமிழில் முரண்பாடான விடைகள் வருவது ஏன் என்று கேட்ட அதிகாரி ஒரு தொழில்நுட்பக் கேள்வியைக் கேட்கவில்லை. அவரைப் போன்ற மனிதர்களுக்கும், அவரது பிரஜைகளுக்கும் மற்றவர்களைப் போலவே சமமான தரத்திலான உதவி கிடைக்கிறதா என்றுதான் அவர் கேட்டார். இன்றைய நிலையில் அதற்கான நேர்மையான பதில்: அது தானாக நிகழ்ந்துவிடாது. அதற்கான நம்பிக்கையூட்டும் பதில்: மொழிபெயர்ப்பை ஒரு பட்டனை அழுத்தும் வேலையாகப் பார்ப்பதை நிறுத்திவிட்டு, துல்லியமான அளவீடுகளுடன், ஒன்றையொன்று சரிபார்க்கும் பல மாடல்களுடன், வாசித்து கையொப்பமிடும் மனிதர்களுடன் கூடிய ஓர் இயந்திரக் கட்டமைப்பாக அணுகத் தொடங்கினால், அவர்களுக்கும் அந்தச் சமத்துவமான தரம் நிச்சயம் கிடைக்கும்.
இடசரா (Idasara) நிறுவனத்தில் நாங்கள் செய்வது இதைத்தான். இடசரா அகாடமியின் Learn to Learn புத்தகம் ஆங்கிலம், சிங்களம் மற்றும் தமிழ் ஆகிய மூன்று மொழிகளிலும் ஒரே நேரத்தில் வெளியிடப்பட்டது; ஒவ்வொரு அத்தியாயமும் ஒரே மூலத்திலிருந்து உருவாக்கப்பட்டு, வெளியிடப்படுவதற்கு முன்னர் அந்தந்தத் தாய்மொழி வாசகரால் சரிபார்க்கப்பட்டது. அது ஒரு சிறிய இயந்திரக் கட்டமைப்பு. ஆனால் அது அதே தத்துவத்தின் கீழ்தான் இயங்குகிறது. இலங்கையிலோ அல்லது ஒன்றுக்கு மேற்பட்ட மொழிகளை மக்கள் வாசிக்கும் உலகின் எந்தப் பகுதியிலோ, உங்கள் நிறுவனத்திற்கும் இத்தகைய ஒரு கட்டமைப்பு தேவைப்பட்டால், உங்களுக்கு வழிகாட்ட நாங்கள் தயாராக உள்ளோம்.
பல மாதிரி அமைப்புகளைப் பயன்படுத்துங்கள். அர்த்தத்தை உறுதிப்படுத்துங்கள். மனிதக் கட்டுப்பாட்டை நிலைநிறுத்துங்கள்.
ஒரு பார்வையில் (At a glance)
- பன்மொழி AI இயந்திரம் என்றால் என்ன? மாதிரி அமைப்புகளின் தொகுப்பு, இரண்டாவது மாதிரி மறுஆய்வு, கலைச்சொல் வங்கி, மொழிபெயர்ப்பு நினைவகம், தணிக்கைப் பதிவு மற்றும் மனித அங்கீகாரம் ஆகியவற்றைப் பயன்படுத்தி, ஓர் அதிகாரப்பூர்வ மூல ஆவணத்தைப் பல மொழிகளில் அங்கீகரிக்கப்பட்ட பதிப்புகளாக மாற்றும் ஒரு முழுமையான அமைப்பாகும் (pipeline).
- ஒன்றுக்கு மேற்பட்ட மாதிரிகளைப் பயன்படுத்துவது ஏன்? ஏனெனில் ஒட்டுமொத்தமாகச் சிறந்த ஒரு மாடல் பெரும்பாலும் ஒரு குறிப்பிட்ட மொழிக்கும் துறைக்கும் சிறந்ததாக இருப்பதில்லை. மதிப்பீட்டு அளவுகோலின்படி வழிநடத்துவதும், இரண்டாவது மாடல் மூலம் முதலாவதை மறுஆய்வு செய்வதும் ஒற்றை மாடலால் பார்க்க முடியாத தவறுகளைக் கண்டறிகிறது.
- எவை அளவிடப்படுகின்றன? நிறுவனத்தின் சொந்த ஆவணங்களின் அடிப்படையில் தாய்மொழி வாசகர்களால் புள்ளியிடப்படும் அர்த்த உண்மைத்தன்மை, கலைச்சொல் சீர்மை, சரளத்தன்மை, மாயை உருவாக்கும் வீதம் மற்றும் சட்ட அர்த்தப் பாதுகாப்பு.
- இது யாருக்கானது? அரசாங்கங்கள், வங்கிகள், மருத்துவமனைகள், பாடசாலைகள், வெளியீட்டாளர்கள், மற்றும் ஒரே விடயத்தை ஒன்றுக்கு மேற்பட்ட மொழிகளில் துல்லியமாகக் கூற வேண்டிய எந்தவொரு நிறுவனத்திற்கும்.
அடிக்கடி கேட்கப்படும் கேள்விகள் (Frequently asked questions)
அதிகாரப்பூர்வ ஆவணங்களை மொழிபெயர்க்க நான் ChatGPT அல்லது Gemini ஐ நேரடியாகப் பயன்படுத்தலாமா? எவ்வித சரிபார்ப்புமின்றி, ஒரு மாடலை ஒருமுறை மட்டும் பயன்படுத்துவது அதிகாரப்பூர்வ, சட்ட அல்லது ஒழுங்குபடுத்தப்பட்ட ஆவணங்களுக்குப் பாதுகாப்பானது அல்ல என்பதே இடசராவின் நிலைப்பாடாகும். இரண்டாவது மாடல் மறுஆய்வு மற்றும் பெயரிடப்பட்ட மனித அங்கீகாரம் கொண்ட ஓர் இயந்திரக் கட்டமைப்பிற்குள் அதை முதல் வரைவாகப் பயன்படுத்துங்கள்; ஒருபோதும் இறுதி முடிவாகப் பயன்படுத்தாதீர்கள்.
சிங்களம் அல்லது தமிழ் மொழிபெயர்ப்பிற்கு எந்த AI மாதிரி சிறந்தது? இது துறை மற்றும் ஆவண வகையைப் பொறுத்தது; மேலும் மாடல்கள் புதுப்பிக்கப்படும் போது மாறுகிறது. வெறும் புகழின் அடிப்படையில் தேர்ந்தெடுப்பதற்குப் பதிலாக, தாய்மொழி மதிப்பீட்டாளர்களுடன் உங்கள் சொந்த ஆவணங்களில் பல மாடல்களை மதிப்பிட்டு, ஒவ்வொரு மொழி மற்றும் துறைக்கும் சிறந்த புள்ளிகளைப் பெறும் மாடலுக்கு வழிகாட்டுமாறு இடசரா பரிந்துரைக்கிறது.
கலைச்சொல் வங்கி என்றால் என்ன, அது ஏன் முக்கியமானது? கலைச்சொல் வங்கி என்பது ஒவ்வொரு முக்கியமான சொல்லுக்கும் ஒவ்வொரு மொழியிலும் அங்கீகரிக்கப்பட்ட அதிகாரப்பூர்வ வடிவமாகும். பல்வேறு ஆவணங்களில் ஒரே சொல் வெவ்வேறு வழிகளில் மொழிபெயர்க்கப்படுவதைத் தடுப்பதற்கு மாடல்களின் மீது இதை நடைமுறைப்படுத்துவதே மிகச் சிறந்ததும் குறைந்த செலவுமிக்கதுமான வழியாகும்.
தணிக்கைப் பதிவில் (audit log) எவை பதிவாக வேண்டும்? வெளியிடப்படும் ஒவ்வொரு பதிப்பிற்கும்: மூலத்தை யார் வரைவு செய்தார், எந்த மாடல் மொழிபெயர்த்தது, யார் மறுஆய்வு செய்தார், பதிப்புகளுக்கிடையில் என்ன மாற்றப்பட்டது, மற்றும் யார் அங்கீகரித்தார் என்ற தகவல்கள். "தமிழில் ஏன் இவ்வாறு கூறப்பட்டுள்ளது?" என்று யாராவது கேட்டால் ஒரு நிறுவனத்தால் விரைவாகவும் நேர்மையாகவும் பதிலளிக்க இதுவே உதவுகிறது.
இந்த இயந்திரக் கட்டமைப்பு மொழிபெயர்ப்பாளர்களைப் பதிலீடு செய்யுமா? இல்லை. இது சலிப்பூட்டும் முதல் வரைவு தயாரிப்பையும் சீர்மைச் சரிபார்ப்பையும் மட்டுமே பதிலீடு செய்கிறது. தாய்மொழி வாசகர்களும் அங்கீகரிப்பாளர்களும் இறுதிப் பாதுகாப்புக் கதவாகத் தொடர்கின்றனர்; மேலும் வாசகருக்கு இயல்பாக ஒலிக்கும் சொற்களைத் தேர்ந்தெடுப்பது போன்ற மாடல்களால் செய்ய முடியாத மனித நுண்ணறிவு சார்ந்த முடிவுகளுக்கு அவர்களின் நேரம் விடுவிக்கப்படுகிறது.
இந்தக் கட்டுரையின் பின்னணியிலுள்ள சான்றுகள் (The evidence behind this piece)
- இலங்கை சனநாயக சோசலிசக் குடியரசின் அரசியலமைப்பு, அத்தியாயம் IV, உறுப்புரை 18 — சிங்களமும் தமிழும் அரச கரும மொழிகளாகவும், ஆங்கிலம் இணைப்பு மொழியாகவும் பிரகடனம் செய்யப்பட்டுள்ளது. இலங்கைப் பாராளுமன்றம்: https://www.parliament.lk/files/pdf/constitution.pdf · இணைய உரை: https://www.constituteproject.org/constitution/Sri_Lanka_2015
- Ahia, Kumar, Gonen, Kasai, Mortensen, Smith & Tsvetkov (2023). "Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models." EMNLP 2023 — வணிக மொழி மாடல் API களில் பல மொழிகளைப் பேசுவோர் ஒரு வாக்கியத்திற்கு அதிக கட்டணம் செலுத்துவதோடு குறைந்த தரத்திலான முடிவுகளையே பெறுகிறார்கள். https://aclanthology.org/2023.emnlp-main.614/
- "Large Language Models for Math Education in Low-Resource Languages: A Study in Sinhala and Tamil" (2026) — வினாக்கள் ஆங்கிலத்திற்குப் பதிலாக நேரடியாகச் சிங்களத்திலும் தமிழிலும் முன்வைக்கப்படும் போது தர்க்கத் திறன் தரம் குறைகிறது. https://arxiv.org/abs/2602.14517
- "SinhalaMMLU: A Comprehensive Benchmark for Evaluating Multitask Language Understanding in Sinhala" (2025) — தற்போதைய மாதிரி அமைப்புகளில் ஆங்கில மற்றும் சிங்கள செயல்திறனுக்கு இடையிலான இடைவெளியைக் காட்டும் சுதேச சிங்கள மதிப்பீட்டு அளவுகோல். https://arxiv.org/abs/2509.03162
- Fortune (7 அக்டோபர் 2025), "Deloitte to refund Australian government after AI hallucinations in report" — AI உதவியுடன் தயாரிக்கப்பட்ட ஓர் அரசாங்க அறிக்கையில் போலியான நீதிமன்ற மேற்கோள் மற்றும் நடைமுறையில் இல்லாத கல்விசார் மேற்கோள்கள் இடம்பெற்ற விவகாரம். https://fortune.com/2025/10/07/deloitte-ai-australia-government-report-hallucinations-technology-290000-refund
- AI Incident Database, Incident 1193 — மேற்கூறிய Deloitte Australia சம்பவம் ஆவணப்படுத்தப்பட்டுள்ளது. https://incidentdatabase.ai/cite/1193/
- இடசரா அகாடமி (Idasara Academy), "Learn to Learn" — ஒரே மூலத்திலிருந்து ஆங்கிலம், சிங்களம் மற்றும் தமிழ் ஆகிய மொழிகளில் வெளியிடப்பட்ட இலவசப் புத்தகம். https://academy.idasara.org/learn-to-learn/
வரைபடங்கள்: சமிச அபேசிங்க (Samisa Abeysinghe), இடசர டிஜிட்டல் (Idasara Digital), செப்டம்பர் 2026.